Runpod-Alternativen
Fazit zu den Runpod-Alternativen
Bleiben Sie bei Runpod, wenn Sie ComfyUI auf einer 4090 nutzen: Das günstigste verifizierte 4090 bei Vast.ai kostet 0,41 $ pro Stunde, bei Runpod 0,34 $. Bei einer 5090 ist der günstigste verifizierte Host von Vast.ai 0,05 $ pro Stunde günstiger (gelesen am ).
Der Haken ist die Verfügbarkeit: 13 von 48 Nutzerquellen berichten von beliebten GPUs, die sie nicht bekommen konnten (Trustpilot, Reddit).
Für ComfyUI auf einer gemieteten RTX 4090 oder 5090, mit Modellen, die zwischen Sitzungen erhalten bleiben: Runpod
Offizielles ComfyUI-Template, Modelle auf einem Network Volume. Auf unserem eigenen Runpod-Konto brauchte ein FLUX-Bild am 17. Okt. 2026 28.5 s auf einer 4090 in Secure Cloud.
Für Anzeigenvideos und -bilder ohne GPU, Modell oder Workflow, die Sie einrichten müssen:  Higgsfield
Kling, Veo und Seedance im Browser mit einem Credit-Guthaben; bezahlt wird pro Generierung, nie pro Stunde.
| Tool | Monatlich ab (USD) | Geprüft | Was es leistet | Offizielle Website |
|---|---|---|---|---|
| Runpod Das Tool, das Sie ersetzen | Abrechnung nach Nutzung | GPU-Cloud mit sekundengenauer Abrechnung: Eine RTX 4090 gibt es ab 0,34 $ pro Stunde, darauf laufen ComfyUI, Wan 2.2, LTX-2 oder FLUX in Eigenregie. | Runpod besuchen | |
 Higgsfield | 19 $ | Multimodell-Studio mit Seedance, Kling, Veo und eigenen Soul-Modellen, dazu Tools für Anzeigen und UGC sowie ein Agent. | Higgsfield besuchen |
Seitlich scrollen für alle 5 Spalten
Warum Nutzer nach einer Runpod-Alternative suchen
Eine GPU ist der Grafikchip, auf dem Bild- und Videomodelle laufen, und VRAM ist ihr eigener Speicher: Das Modell muss hineinpassen. Runpod vermietet beides pro Stunde. Sie starten einen Pod (eine gemietete Maschine mit einer oder mehreren GPUs) aus einem Template (einer vorgefertigten Software-Umgebung wie ComfyUI). Die Runpod-Themenseite deckt den ganzen Weg ab.
Unsere Auswertung stützt sich auf 48 Nutzerquellen. Das sind die 24 Bewertungen auf der ersten Seite des Trustpilot-Eintrags von Runpod und 24 Reddit-Threads von Februar bis Oktober 2026.
Die Verfügbarkeit führt die Beschwerden an: 13 von 48 Quellen berichten von beliebten GPUs, die sie nicht bekommen konnten (Trustpilot, Reddit). Acht beschreiben Pods, die nie funktionierten, oder Starts, die scheiterten (Trustpilot, Reddit).
Der Preis ist der zweite Grund: 7 von 48 Quellen beschreiben Preiserhöhungen bei der RTX 5090 und 4090 oder nennen den Dienst teuer (Reddit, Trustpilot).
Das Lob gilt der Einrichtung. Fünf von 48 Quellen finden Runpod einfach einzurichten, und 3 loben schnelle Antworten des Supports (Trustpilot). Vier von 48 schätzen es, eine High-End-GPU sekundengenau zu mieten (Trustpilot, Reddit).
Stundenpreise für eine RTX 4090, 5090 und H100
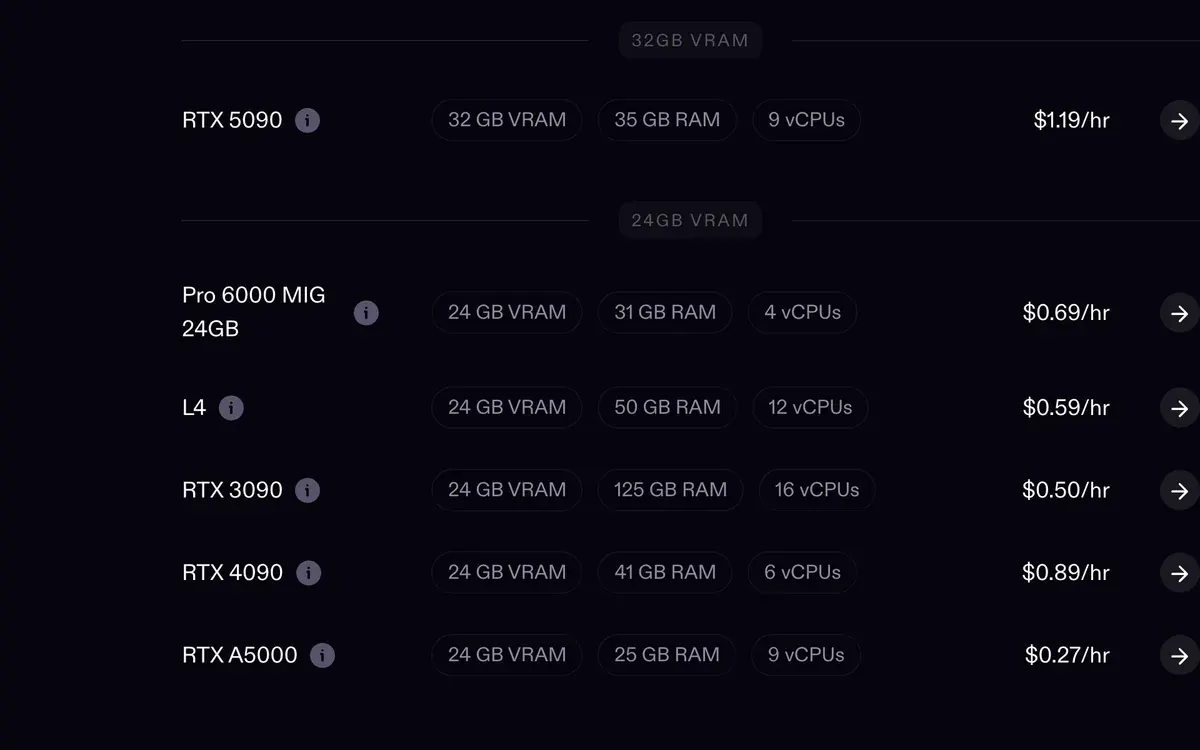
Die Community Cloud von Runpod nennt den niedrigsten Preis für die RTX 4090 und, um einen Cent, für die H100. Die verifizierten Hosts von Vast.ai nennen den niedrigsten Preis für die RTX 5090. Bei Vast.ai zählt die Tabelle nur verifizierte Hosts, und jeder Preis stammt am 24. Oktober 2026 von der Seite oder API des Anbieters.
| Cloud und Stufe | RTX 4090 (24 GB) | RTX 5090 (32 GB) | H100 (80 GB) |
|---|---|---|---|
| Runpod Community H100 PCIe, sekundengenau abgerechnet | 0,34 $ | 0,69 $ | 1,99 $ |
| Runpod Secure H100 PCIe, sekundengenau abgerechnet | 0,89 $ | 1,19 $ | 2,89 $ |
| Vast.ai Niedrigstes verifiziertes Angebot, H100 PCIe | 0,41 $ | 0,64 $ | 2,00 $ |
| TensorDock Üblicher Preis, je nach Host unterschiedlich; H100 SXM5, pro Sekunde abgerechnet | 0,35 $ | Nicht aufgeführt | 2,25 $ |
| Massed Compute H100 80 GB, nach Stunde berechnet | Nicht aufgeführt | Nicht aufgeführt | 2,73 $ |
| Lambda H100 PCIe, pro Minute abgerechnet | Nicht aufgeführt | Nicht aufgeführt | 3,29 $ |
| Modal H100 SXM5, pro Sekunde abgerechnet | Nicht aufgeführt | Nicht aufgeführt | 3,95 $ |
| DigitalOcean GPU Droplets HGX H100, pro Sekunde, Mindestdauer 5 Minuten | Nicht aufgeführt | Nicht aufgeführt | 4,41 $ |
| Paperspace H100 on demand zu einem Aktionspreis, pro Stunde abgerechnet | Nicht aufgeführt | Nicht aufgeführt | 5,95 $ |
Seitlich scrollen für alle 4 Spalten
Die günstigste Zeile ist nicht immer das günstigste Bild. Eine langsamere Karte zu einem niedrigeren Preis kann pro Ergebnis mehr kosten. Teilen Sie den Stundenpreis durch die Ergebnisse, die Sie in einer Stunde bekommen, bevor Sie wechseln.
Runpod vs. Vast.ai: dieselben Karten, zwei Arten von Hosts
Vast.ai ist ein Marktplatz: Unabhängige Hosts bieten ihre eigenen Maschinen an und legen ihre Preise selbst fest. Die Preisseite sagt, der Markt lege die Preise fest, nicht Vast („are set by the market, not by Vast.“). Runpod nennt einen Preis pro Karte für Secure Cloud und einen anderen für die Community Cloud mit Peer-to-Peer-Hosts.
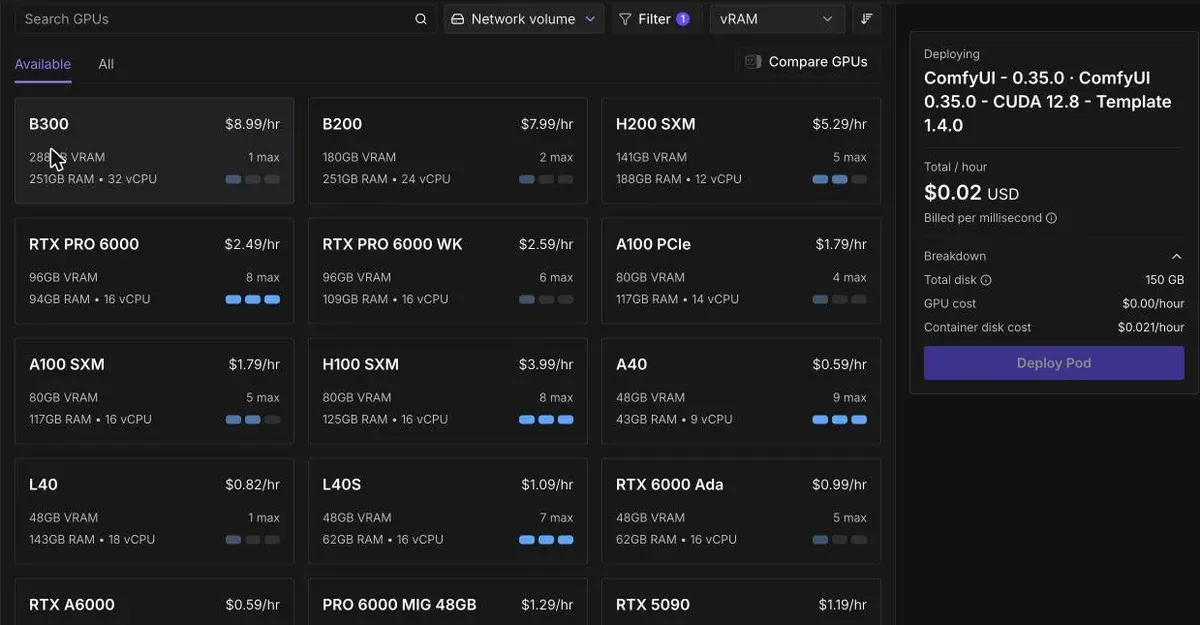
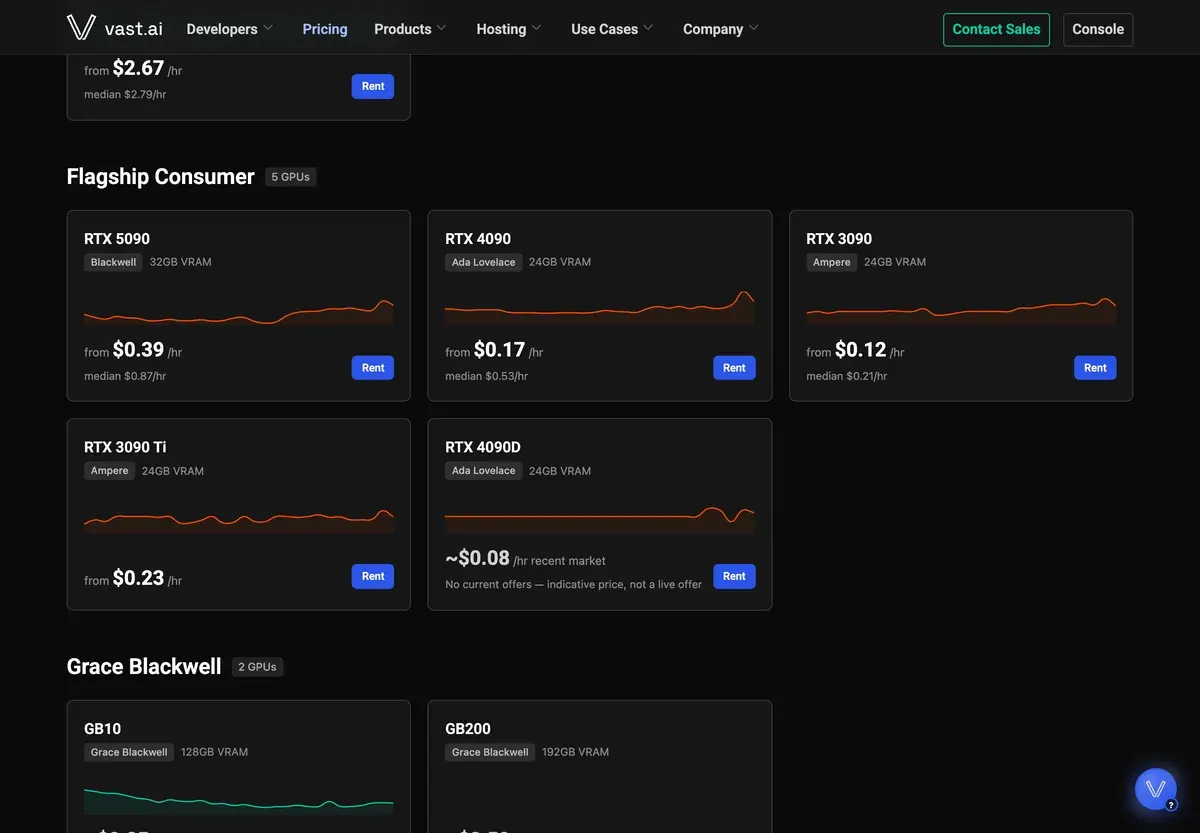
Die Angebotssuche von Vast.ai ergab am 24. Oktober 2026: 39 verifizierte Maschinen mit RTX 4090 für eine GPU on demand. Die günstigste kostete 0,41 $ pro Stunde, die mittlere 0,67 $. Nicht verifizierte Hosts boten niedrigere Preise an, ab 0,17 $.
Vast.ai bietet auch Interruptible-Maschinen an, die laut Preisseite zurückgeholt werden können („may be reclaimed.“). Das passt zu einer Charge Standbilder, die sich neu starten lässt. Es schadet dem Rendern eines Videos von 20 Minuten.
Auf Trustpilot hat Vast.ai 262 Bewertungen und einen TrustScore von 3.8, Runpod dagegen 387 Bewertungen und einen TrustScore von 3.5. Beide wurden am 24. Oktober 2026 gelesen.
Beide Clouds führen ComfyUI aus einem Template aus. Der Leitfaden zur Videogenerierung von Vast.ai findet es über die Suche nach „ComfyUI“ im Tab Templates. Die Template-Auswahl von Runpod zeigt zuerst das offizielle ComfyUI-Template, daneben Community-Templates für Wan 2.2.
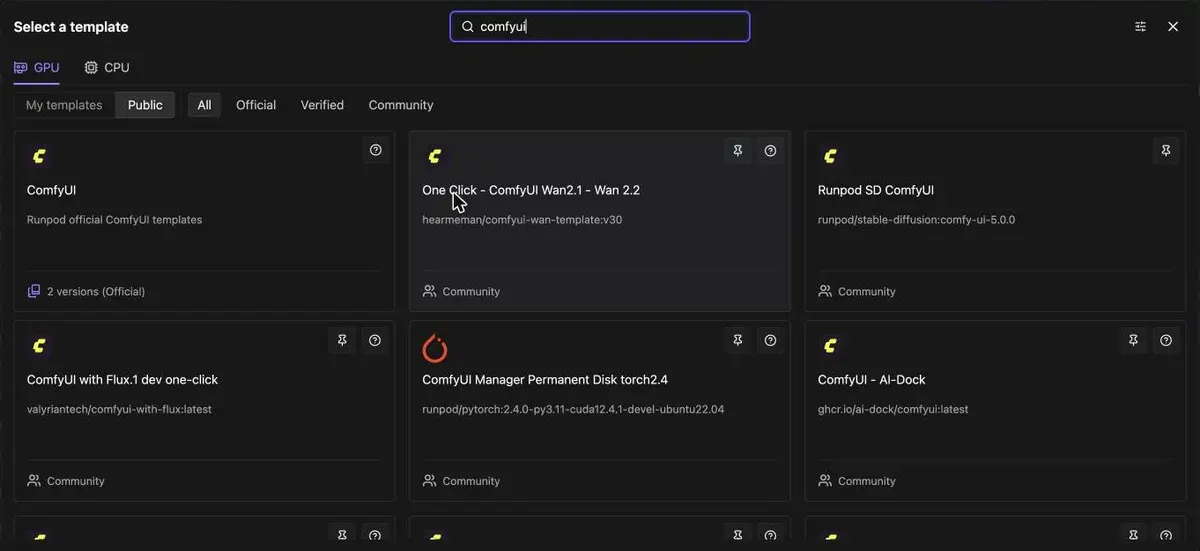
Runpod hält Ihre Modelle auf einem Network Volume, einem Speicher, der jeden einzelnen Pod überdauert. Auf unserem eigenen Runpod-Konto kosteten 28 kurze Pod-Sitzungen zwischen dem 16. und dem 21. Oktober 2026 zusammen 9,26 $.
Netzwerkspeicher für die Modelle schlug im Oktober bis zum 24. mit 2,21 $ zu Buche, der einzige Posten, der läuft, wenn kein Pod läuft. Unsere Runpod-Preisseite schlüsselt die Rechnung auf, und ComfyUI auf Runpod führt durch die Einrichtung.
Ein neuer Runpod-Nutzer, der sich über einen Empfehlungslink mit Google anmeldet und dann 10 $ lädt, erhält ein einmaliges Guthaben. Ebenso die Person, die ihn empfohlen hat.
Das Guthaben reicht von 5 $ bis 500 $, die meisten bekommen 5 $ (Dokumentation zum Empfehlungsprogramm). Nutzer in Europa bekommen pauschal 5 $. Unser Ratgeber zum Runpod-Empfehlungscode erklärt die Schritte.
Modal: GPUs sekundengenau aus Python-Code
Modal führt Ihre Python-Funktion auf einer GPU aus und rechnet jede Sekunde ab, die sie läuft, sodass ein Setup, das zwischen Anfragen wartet, nichts kostet. Das passt zu einem Team, das einen ComfyUI-Workflow in eine API für ein Anzeigen-Tool verwandelt. Die Dokumentation von Modal zeigt einen ComfyUI-Workspace, der mit einem einzigen Befehl startet, modal serve.
Modal führt nur Rechenzentrumskarten. Die H100 kommt dort auf 3,95 $ pro Stunde und die L40S auf 1,95 $, gegenüber 1,09 $ für dieselbe L40S bei Runpod Secure Cloud (Preise von Modal).
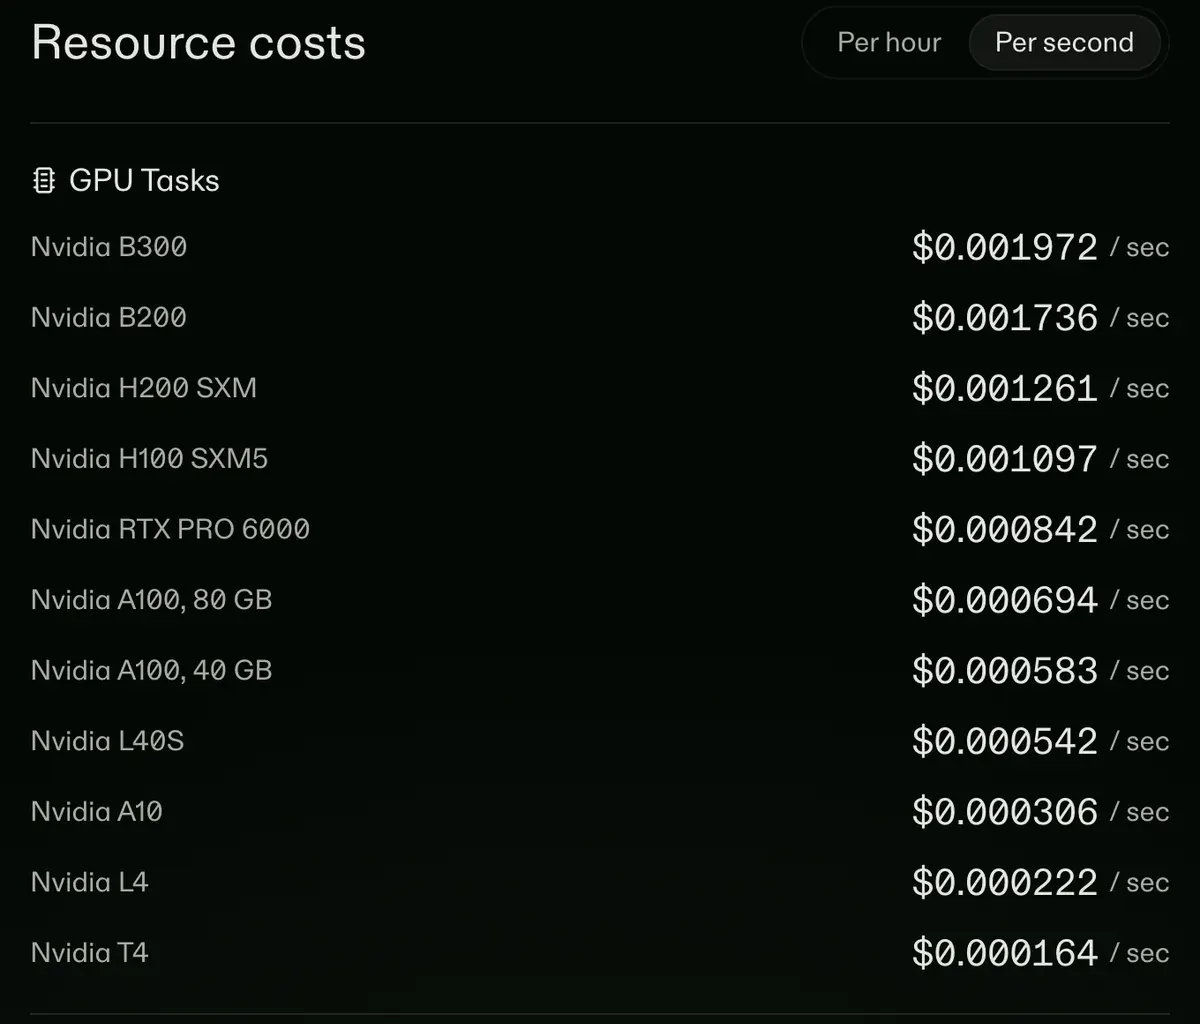
Der Gratis-Tarif Starter enthält 30 $ Compute-Credits pro Monat. Wählen Sie Modal, wenn Sie Code schreiben und zwischen Anfragen nichts laufen soll.
Lambda: H100 und B200 für Jobs in Trainingsgröße
Lambda vermietet Rechenzentrums-GPUs pro Minute, von einer einzelnen Karte bis zu Clustern mit acht. Eine H100 PCIe kostet 3,29 $ pro Stunde, eine B200 6,99 $.
Die günstigste Karte mit 24 GB ist eine Quadro RTX 6000 für 0,69 $, zwei Generationen älter als eine 4090. Lambda eignet sich, um ein Modell auf acht GPUs gleichzeitig zu trainieren. Für eine Person, die Standbilder erzeugt, sind die oben genannten Preise für die 4090 günstiger.
TensorDock: Marktplatzpreise bei veralteter Seite
TensorDock ist wie Vast.ai ein Marktplatz. Die öffentliche Seite nennt einen üblichen Stundenpreis von 0,35 $ für eine RTX 4090 und 2,25 $ für eine H100 SXM5, abgerechnet pro Sekunde.
Auf derselben Seite steht, der Preis hänge vom Host ab („varies by host“) und sie sei zuletzt am 24. Juli 2024 aktualisiert worden. Aktuelle Preise stehen hinter dem Dashboard.
Massed Compute: feste Stundenpreise für Karten mit 48 bis 96 GB
Massed Compute berechnet jede GPU-Maschine pro Stunde. Eine L40S mit 48 GB kostet 0,97 $ und eine RTX PRO 6000 Blackwell mit 96 GB 2,19 $.
Die Community Cloud von Runpod nennt für dieselbe RTX PRO 6000 1,69 $. Massed Compute führt keine RTX 4090 oder 5090, eignet sich also für große Videomodelle, die die 96 GB brauchen.
Paperspace und DigitalOcean GPU Droplets
Paperspace gehört jetzt zu DigitalOcean, dessen Banner lautet: „Paperspace is now part of DigitalOcean!“ Die Preisseite nennt eine H100 on demand für 5,95 $ pro Stunde unter der Bezeichnung „special promo price“. Die niedrigeren Preise für H100 und A100 setzen eine Bindung über drei Jahre voraus.
Die GPU Droplets von DigitalOcean selbst führen eine L40S für 1,57 $ pro Stunde, abgerechnet pro Sekunde bei einer Mindestdauer von 5 Minuten. Ein ausgeschaltetes Droplet wird weiter berechnet, bis Sie es zerstören.
Baseten: als APIs bereitgestellte Modelle, abgerechnet pro Minute
Baseten hostet ein Modell als Endpoint und rechnet minutengenau ab („down to the minute“), solange es rechnet. Eine H100 kostet 0,108 $ pro Minute, das sind 6,50 $ pro Stunde. Baseten betreibt und skaliert den Modellserver für Sie. Auf einem Runpod-Pod betreiben Sie ihn selbst, und Serverless von Runpod liegt dazwischen.
Comfy Cloud: ComfyUI im Browser im Monatsabo
Comfy Cloud ist ComfyUI, betrieben von den eigenen Machern, ohne Pod zum Starten. Standard kostet 20 $ pro Monat, und jeder Tarif läuft auf einer RTX 6000 Pro mit 96 GB.
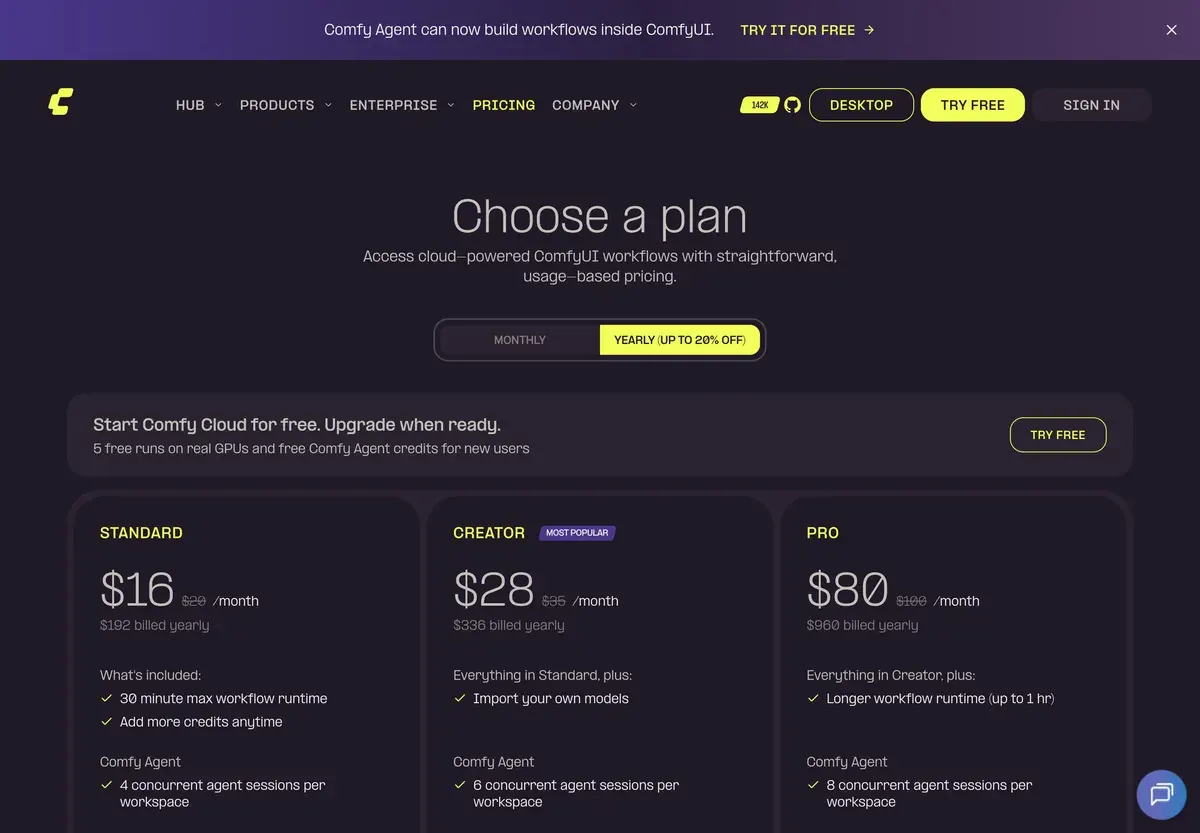
Jeder Job bei Standard endet nach 30 Minuten, Pro hebt das auf eine Stunde an. Standard lohnt sich, wenn Ihre Jobs innerhalb von 30 Minuten fertig sind und Sie lieber 20 $ pro Monat zahlen als pro Stunde.
 Higgsfield: Apps mit Credit-Abrechnung statt einer GPU
Higgsfield verkauft fertige Generierungen von Kling, Veo, Seedance und den eigenen Soul-Modellen in einem Credit-Tarif. Starter kostet 19 $ pro Monat (Preisseite, geprüft am ).
Sie wählen nie eine GPU und laden kein Modell. Der Kompromiss ist die Modellliste: Offene Modelle wie Wan 2.2 oder LTX-2 mit eigenen Einstellungen brauchen eine gemietete GPU. Unser Higgsfield-Profil behandelt Credits und Bedingungen.
Modelllizenzen bleiben bei einem Wechsel bestehen
Jede Cloud oben vermietet Hardware, deshalb entscheidet die Lizenz des Modells, das Sie betreiben, was Ihre Anzeige darf. Wan 2.2 steht unter Apache 2.0. LTX-2 ist bei einem Jahresumsatz unter 10.000.000 $ kostenlos kommerziell nutzbar (Lizenz, Abschnitt 2.1).
Die Community-Lizenz von MiniMax H3 schließt die USA, die EU, das Vereinigte Königreich und Südkorea aus, ist also bei keiner Cloud ein Weg für Anzeigen dort. Wan 2.2 auf Runpod richtet das Apache-Modell Schritt für Schritt ein.
Weggelassen, und warum
Google Cloud, AWS und Azure berechnen GPUs innerhalb ganzer Familien virtueller Maschinen, Region für Region und hinter Kontingenten. Keine einzelne Stundenzahl von ihnen ist mit den Zeilen oben vergleichbar.
Quellen
- Runpod: Runpod pricing, Preise pro Stunde für Secure Cloud, Community Cloud und Serverless; die API unseres eigenen Kontos lieferte dieselben Preise. Geprüft am
- Runpod docs: Runpod referral programme, Anmeldung mit Google, eine Mindestaufladung, ein einmaliges Guthaben für beide Personen. Geprüft am
- Vast.ai: Vast.ai pricing, von Hosts festgelegte Preise; die Stufen On-Demand, Interruptible und Reserved. Geprüft am
- Vast.ai: Vast.ai offer search API, verifizierte, mietbare On-Demand-Angebote für eine einzelne GPU, sortiert nach Gesamtpreis pro Stunde. Geprüft am
- Vast.ai docs: Vast.ai video generation guide, das ComfyUI-Template im Tab Templates. Geprüft am
- Modal: Modal pricing, GPU-Preise pro Sekunde; kostenlose Credits pro Monat bei Starter. Geprüft am
- Modal docs: Run ComfyUI on Modal. Geprüft am
- Lambda: Lambda GPU cloud pricing, On-Demand-Preis pro GPU und Stunde, abgerechnet pro Minute. Geprüft am
- TensorDock: TensorDock cloud GPUs, üblicher Stundenpreis, je nach Host unterschiedlich, abgerechnet pro Sekunde; laut Seite zuletzt am 24. Juli 2024 aktualisiert. Geprüft am
- Massed Compute: Massed Compute pricing. Geprüft am
- Paperspace (DigitalOcean): Paperspace pricing, H100 on demand zu einem Aktionspreis; die übrigen gezeigten Preise setzen eine Bindung über drei Jahre voraus. Geprüft am
- DigitalOcean: DigitalOcean GPU Droplets pricing, abgerechnet pro Sekunde bei einer Mindestdauer von 5 Minuten. Geprüft am
- Baseten: Baseten pricing, dedizierte Deployments, abgerechnet pro Minute. Geprüft am
- Comfy Org: Comfy Cloud pricing, vier Tarife auf einer RTX 6000 Pro mit 96 GB; 30 Minuten pro Job bei Standard. Geprüft am
- Trustpilot: Runpod reviews, 387 Bewertungen, TrustScore 3.5; Befunde gezählt an den 24 Bewertungen der ersten Seite. Geprüft am
- Reddit, gelesen über das Arctic-Shift-Archiv: Runpod threads on r/RunPod and r/comfyui, 24 Threads, Februar bis Oktober 2026. Geprüft am
- Trustpilot: Vast.ai reviews, 262 Bewertungen, TrustScore 3.8. Geprüft am
- MiniMax auf Hugging Face: MiniMax H3 Community License Agreement, Excluded Territories. Geprüft am
- Lightricks auf GitHub: LTX-2 Community License Agreement, Abschnitt 2.1, eine kostenpflichtige Lizenz über einer Grenze beim Jahresumsatz. Geprüft am

Alexandre S.
Alexandre S. ist Creative Ad Strategist und Copywriter mit zehn Jahren Erfahrung im digitalen Marketing über mehrere Kanäle hinweg.
Ähnliche Seiten
-
 Kategorie Die besten KI-Video-Generatoren für Werbung
23 KI-Video-Generatoren und Modell-Shops im Vergleich nach Kosten pro Clip und Anzeigenbedingungen, geprüft am 25. September 2026.
-
 Profil Runpod
Runpod für Anzeigenbilder und -videos: Secure oder Community Cloud, Pods oder Serverless, Modelllizenzen und was 48 Nutzerquellen berichten. Geprüft am 24. Oktober 2026.
-
 Preise Runpod-Preise
Runpod-GPU-Preise pro Stunde bei Secure, Community und Serverless, Speicherpreise und was ein Bild auf unserem eigenen Pod mit RTX 4090 kostet. Geprüft am 24. Okt. 2026.
-
 Ratgeber ComfyUI-Workflow für KI-Influencer
Die ComfyUI-Bausteine hinter einem KI-Influencer, die Lizenz jedes offenen Modells, wo es Workflows gibt und die Kosten der gemieteten GPU pro Bild. Geprüft am 24. Okt. 2026.
-
 Alternativen Higgsfield-Alternativen
Weitere Studios, die Kling, Veo und Seedance in einem Tarif weiterverkaufen, im Vergleich mit Higgsfield bei Kosten pro Clip, Trainingsbedingungen und Rückerstattungen, geprüft am 2. Oktober 2026.
-
 Daten Preis-Tracker für KI-Anzeigen-Tools
Bei 69 von 82 KI-Anzeigen-Tools steht ein Listenpreis, gelesen auf der eigenen Seite des Anbieters, zuletzt geprüft am 16. Oktober 2026, mit den Kosten pro Clip oder Bild, wo der Credit-Verbrauch das erlaubt.


