Wan 2.2 und LTX-2 auf Runpod
Wan 2.2 und LTX-2 sind offene Videomodelle. Sie laden die Dateien herunter und führen sie selbst in ComfyUI aus, auf einer Grafikkarte, die Sie besitzen oder mieten. Runpod vermietet diese Karten sekundengenau.
Das kleine 5B-Modell von Wan 2.2 und LTX-2 passen auf eine Karte mit 24 oder 32 GB, die RTX 4090 oder RTX 5090. Bei 720p brauchen die 14B-Modelle von Wan 48 GB im leichteren fp8-Format. In voller Größe brauchen sie 80 GB oder mehr, etwa die RTX PRO 6000 mit 96 GB.
Aus veröffentlichten Generierungszeiten gerechnet, kostet ein kurzer Clip von unter einem Cent bis etwa einem Dollar GPU-Zeit. Der Dollar stammt aus dem Referenzskript von Alibaba.
| Modell | Was es erstellt | Grafikspeicher (Quelle) | Passende Runpod-Karte | Lizenz für Anzeigen |
|---|---|---|---|---|
| Wan 2.2 TI2V-5B | Text- oder Bild-zu-Video, 720P bei 24 FPS | 24 GB (Wan-Team), etwa 8 GB mit Offloading (ComfyUI) | RTX 4090, 24 GB | Apache 2.0 |
| Wan 2.2 T2V und I2V A14B | Text-zu-Video, Bild-zu-Video, 480P und 720P | 80 GB auf einer GPU (Wan-Team); 24 GB in fp8 bei 480p (Runpod) | RTX PRO 6000, 96 GB, für 720p | Apache 2.0 |
| LTX-2 und LTX-2.3 | Video mit synchronisiertem Ton | Ein 4-Sekunden-Clip mit 720p innerhalb von 32 GB (NVIDIA) | RTX 5090, 32 GB | Kostenlos bei weniger als 10.000.000 $ Jahresumsatz |
Seitlich scrollen für alle 5 Spalten
Was sind Wan 2.2 und LTX-2?
Wan 2.2 ist die offene Videomodellfamilie von Alibaba. Die neuere Version, Wan 3.0, wird stattdessen pro Sekunde über die API von Alibaba Cloud verkauft. Auf der GitHub-Seite von Wan 2.2 ist ein 5B-Modell aufgeführt, das aus Text oder einem Bild 720P-Video macht (Wan2.2 auf GitHub). Die 14B-Modelle der Familie decken Text-zu-Video, Bild-zu-Video, Sprache-zu-Video und Figurenanimation ab.
Das „B“ steht für Milliarden Parameter, ein grobes Maß für die Modellgröße. Größere Modelle brauchen mehr Grafikspeicher, VRAM genannt, und der ist die entscheidende Zahl, wenn Sie eine Karte mieten.
LTX-2 ist das offene Modell von Lightricks, und die Version 2.3 erzeugt Video und Ton in einem Durchgang. Die Modellkarte von LTX-2.3 sagt, es sei „designed to generate synchronized video and audio within a single model“, und verweist ComfyUI-Nutzer auf die integrierten LTXVideo-Nodes.

Beide laufen in ComfyUI, einer kostenlosen App, in der jeder Schritt der Aufgabe ein Kasten auf einer Arbeitsfläche ist, der mit dem nächsten verdrahtet wird. Wan 2.2 gibt es in ComfyUI seit dem 28. Juli 2025.
Lassen sich Clips von Wan 2.2 und LTX-2 in Anzeigen nutzen?
Ja, bei beiden, mit einer Umsatzbedingung und einer Liste verbotener Nutzungen bei LTX-2. Runpod vermietet die Hardware, deshalb entscheidet die Lizenz des Modells selbst, was Sie mit den Clips tun dürfen.
Wan 2.2 steht unter Apache 2.0, einer freizügigen Lizenz, die kommerzielle Nutzung erlaubt. Im Repository des Wan-Teams heißt es: „The models in this repository are licensed under the Apache 2.0 License.“
Licence
Licence The models in this repository are licensed under the Apache 2.0 License.
Outputs We claim no rights over the your generated contents, granting you the freedom to use them.
5B model The TI2V-5B model can also run on consumer-grade graphics cards like 4090.
LTX-2 steht unter der LTX-2 Community License Agreement vom 5. Januar 2026. Sie erlaubt die Nutzung für jeden Zweck, vorbehaltlich der verbotenen Nutzungen in Attachment A, etwa ohne Einwilligung erstellter Deepfakes. Sie gilt für jede seit diesem Datum veröffentlichte LTX-2-Version, einschließlich LTX-2.3.
Für die Arbeit an Anzeigen ist die Umsatzgrenze die Bedingung, die zu prüfen ist. Unternehmen mit Jahresumsätzen von mindestens 10.000.000 $ müssen eine bezahlte Lizenz für die kommerzielle Nutzung erwerben (Lizenz von LTX-2).
Section 2.1, grant of rights (dated 5 January 2026)
Entities with annual revenues of at least $10,000,000 (the “Commercial Entities”) are required to obtain a paid commercial use license in order to use LTX-2 and Derivatives of LTX-2.
Die Schwelle zählt die ganze Gruppe, Tochtergesellschaften eingeschlossen. Darunter ist die Nutzung für Anzeigen lizenzgebührenfrei, und Lightricks erhebt keinen Anspruch auf Rechte an den Ergebnissen, die Sie erzeugen.
Die offene Lizenz von MiniMax H3 schließt die USA, die EU, das Vereinigte Königreich und Südkorea aus (Lizenz von MiniMax H3). Für Anzeigen dort steht es nicht auf der Liste.
Wie viel VRAM brauchen Sie, und welche Runpod-GPU passt?
Passen Sie zuerst Modell und Auflösung an den Speicher der Karte an und vergleichen Sie dann den Preis. Passt ein Modell nicht, lagert ComfyUI einen Teil davon in den normalen Arbeitsspeicher des Pods aus, was funktioniert, aber deutlich langsamer läuft.
Wan2.2 in ComfyUI
Templates Workflows in this guide can be found in the Workflow Templates.
5B memory The Wan2.2 5B version should fit well on 8GB vram with the ComfyUI native offloading.
Licence The Wan2.2 series models are based on the Apache 2.0 open source license and support commercial use.
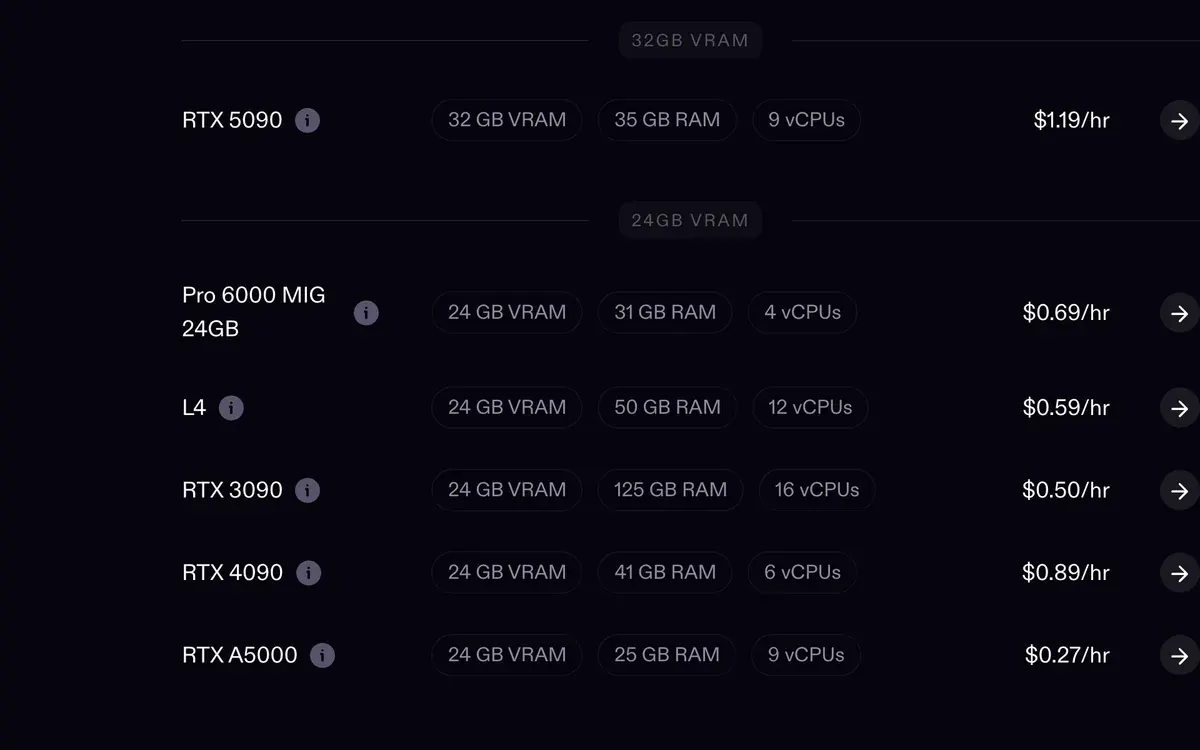
Der eigene Leitfaden von Runpod zu Wan 2.2, aktualisiert am 22. Oktober 2026, nennt Speicherstufen je Aufgabe (Runpods Leitfaden zu Wan 2.2). Die Preise in der Tabelle stammen von Runpods Preisseite.
| Aufgabe | Speicher | Karte | Secure Cloud pro Stunde | Community Cloud pro Stunde |
|---|---|---|---|---|
| TI2V-5B bei 1280 × 704 | 24 GB | RTX 4090 | 0,89 $ | 0,34 $ |
| 14B in fp8 bei 480p oder 640 × 640 | 24 GB | RTX 4090 | 0,89 $ | 0,34 $ |
| 14B in fp8, längere Clips oder LoRAs | 32 GB | RTX 5090 | 1,19 $ | 0,69 $ |
| 14B in fp8 bei 720p | 48 GB | L40S | 1,09 $ | 0,79 $ |
| 14B bei 720p ohne Offloading | 80 GB oder mehr | RTX PRO 6000, 96 GB | 2,49 $ | 1,69 $ |
Seitlich scrollen für alle 5 Spalten
Das fp8 in der Tabelle ist ein leichteres Dateiformat: Die Zahlen des Modells werden mit geringerer Genauigkeit gespeichert, daher braucht es etwa die Hälfte des Speichers.
Auf unserem eigenen Runpod-Konto sehen wir von der Bildseite aus dieselbe Grenze. Bildmodelle von 6 bis 17 GB passen bequem in die 32 GB einer 5090. Ein Videomodell von etwa 40 GB sprengt sie und lagert aus.
Deshalb kann eine Karte mit 96 GB pro Clip weniger kosten als eine günstigere Karte, die auslagern muss.
Was kostet ein Clip auf Runpod?
Von unter einem Cent für einen kurzen LTX-2-Clip bis zu etwa einem Dollar für einen 720p-Clip von Wan 14B mit dem Referenzskript von Alibaba. Jede Zahl unten ist berechnet: eine veröffentlichte Generierungszeit, multipliziert mit dem Preis pro Stunde bei Runpod.
| Clip | Veröffentlichte Zeit (Quelle) | Karte | Secure Cloud | Community Cloud |
|---|---|---|---|---|
| LTX-2, 4 Sekunden, 720p, 24 fps | Etwa 25 Sekunden (NVIDIA) | RTX 5090 | 0,008 $ | 0,005 $ |
| LTX-2, 8 Sekunden, 720p | Etwa 3 Minuten (NVIDIA) | RTX 5090 | 0,06 $ | 0,03 $ |
| Wan 2.2 14B, 5 Sekunden, 640 × 640, Lightning LoRA | Etwa 71 Sekunden (Runpod, auf einer RTX 4090D) | RTX 4090 | 0,018 $ | 0,007 $ |
| Wan 2.2 14B, 5 Sekunden, 640 × 640, 20 Schritte | Etwa 513 Sekunden (Runpod, auf einer RTX 4090D) | RTX 4090 | 0,13 $ | 0,05 $ |
| Wan 2.2 TI2V-5B, 5 Sekunden, 720P | Unter 9 Minuten (Wan-Team, Consumer-GPU) | RTX 4090 | 0,13 $ | 0,05 $ |
| Wan 2.2 14B, 720p, 40 Schritte, Clip-Länge nicht angegeben | 17.4 Minuten (Benchmark von Alibaba) | H100 SXM | 1,16 $ | 0,78 $ |
Seitlich scrollen für alle 5 Spalten
Runpod hat die 71 und 513 Sekunden bei einem Warmlauf gemessen (Modelle bereits geladen), auf einer RTX 4090D, der Exportversion der 4090 mit weniger Kernen. Sie sind hier zum Preis der 4090 angesetzt.
Die drei Minuten von NVIDIA für 8 Sekunden enthalten die Verlangsamung, wenn der Clip über 32 GB hinauswächst. Die 9 Minuten des Wan-Teams sind ein „Unter“-Wert, diese Zeile ist also eine Obergrenze. Das Laden der Modelle vor dem ersten Clip wird ebenfalls berechnet und steht außerhalb dieser Zeilen.
Die Lightning LoRA, eine kleine Zusatzdatei, die das Sampling von Wan auf 4 Schritte reduziert, senkt die Zeit für denselben Clip von etwa 513 Sekunden auf etwa 71.
Zum Vergleich eine Zahl, die auf unserem eigenen Konto gemessen wurde. Ein schnelles Bild mit FLUX 3 Klein braucht auf einer RTX 4090 in Secure Cloud etwa 28.5 Sekunden, das sind 0,007 $ pro Bild. Die Tabelle steht im Leitfaden zu ComfyUI auf Runpod.
RTX 5090 oder RTX 4090 für Wan in ComfyUI?
Die RTX 4090 für das 5B-Modell und für 14B bei 480p; die RTX 5090, wenn 24 GB nicht ausreichen. Die 5090 kostet in Secure Cloud etwa ein Drittel mehr pro Stunde und lohnt sich deshalb nur, wenn die zusätzlichen 8 GB verhindern, dass ComfyUI auslagert. In Community Cloud kostet sie etwa doppelt so viel (0,69 $ gegenüber 0,34 $).
Runpods Leitfaden ordnet die 32 GB der 5090 den 14B-Aufgaben zu, die Spielraum brauchen: längere Clips oder zusätzlich geladene LoRAs. Für LTX-2 ist die 5090 die Karte zum Mieten, da der 4-Sekunden-Clip von NVIDIA mit 720p in ihren Speicher passt.
Bei mehr als 32 GB verzichten Sie auf beide. Eine L40S mit 48 GB kostet pro Stunde weniger als eine 5090 in Secure Cloud. Für volles 14B bei 720p nimmt die RTX PRO 6000 mit 96 GB das ganze Modell auf.
So richten Sie Wan 2.2 mit der Vorlage von HearmemanAI ein
Dieser Weg lädt die Modelle und Workflows beim ersten Start des Pods für Sie herunter. Er nutzt eine Community-Vorlage, die HearmemanAI auf Runpod veröffentlicht hat. Binden Sie ein Network Volume ein (der permanente Datenträger von Runpod, der erhalten bleibt, wenn der Pod weg ist), damit der Download einmal stattfindet.
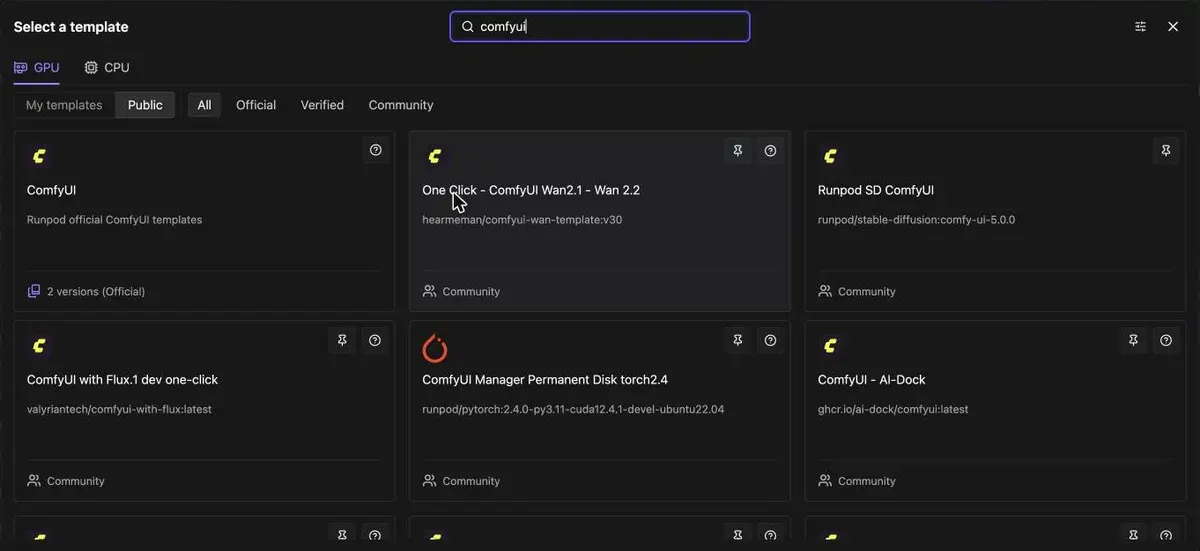
- Vorlage finden. Öffnen Sie in der Runpod-Konsole Pods, dann Deploy, und suchen Sie „comfyui“. Wählen Sie bei den Community-Vorlagen neben der offiziellen „One Click - ComfyUI Wan2.1 - Wan 2.2“.
-
Den Download von Wan 2.2 aktivieren. Öffnen Sie vor dem Deploy Edit Template. Jedes Download-Flag steht anfangs auf false, setzen Sie also
download_wan22auf true,download_wan21ebenfalls, wenn Sie auch die Workflows von Wan 2.1 möchten, unddownload_wan_animatefür Figurenanimation. -
Wählen Sie eine Karte, die CUDA 13 ausführt. Laut Runpods Leitfaden ist die Vorlage für CUDA 13.0 und höher gebaut, CUDA ist die Treiberschicht für die GPU. Filtern Sie die Auswahl nach CUDA-Version. Auf unserem Konto war die CUDA-Festlegung einer Vorlage eine Ursache für die Meldung „no instances available“.
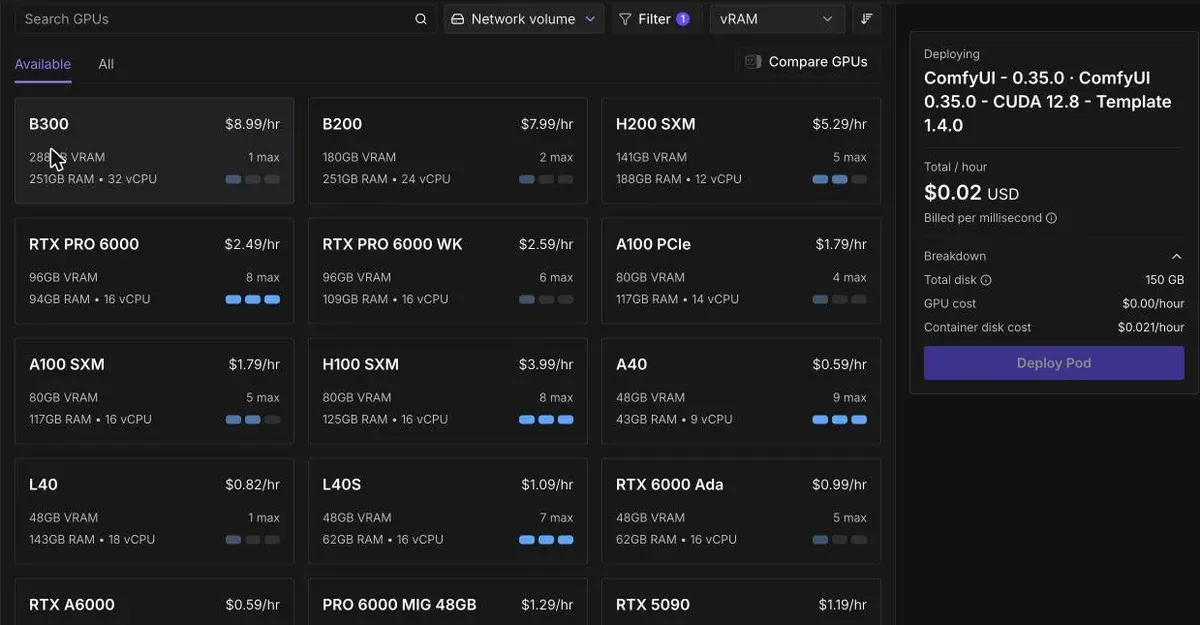
-
Starten Sie den Pod und warten Sie auf den ersten Boot. Der Pod lädt die Modelle herunter, bevor ComfyUI sich öffnet. Klicken Sie dann auf Connect und öffnen Sie den ComfyUI-Link.
-
Laden Sie einen Workflow von Wan 2.2 und führen Sie ihn aus. Die Vorlage bringt ihre Workflows fertig mit, Sie legen also Prompt oder Bild, Größe und Clip-Länge fest und stellen ihn in die Warteschlange.

- Stoppen Sie den Pod, sobald die Clips gespeichert sind. Er wird für jede Sekunde berechnet, in der er läuft, auch im Leerlauf.
Der Weg über die offizielle ComfyUI-Vorlage
Die offizielle Vorlage liefert ein sauberes ComfyUI, und die Wan-Dateien ergänzen Sie selbst. Das dauert beim ersten Mal länger, und Sie sind für jede Datei selbst zuständig.
-
Starten Sie die offizielle ComfyUI-Vorlage aus derselben Auswahl oder ihre Blackwell Edition auf einer RTX 5090. Setzen Sie den Container-Datenträger auf 50 GB; so lief das Deployment auf unserem Konto, wo die Voreinstellung von 150 GB oft keine Karte fand.
-
Öffnen Sie die Vorlagenbibliothek. Suchen Sie in ComfyUI in der Template Library nach „Wan2.2 5B“. Erscheint nichts, ist laut Dokumentation von ComfyUI Ihr ComfyUI veraltet. Dieselben Workflows stehen in der öffentlichen Galerie auf comfy.org und lassen sich nach Modell durchsuchen.
-
Legen Sie jede Datei in ihren Ordner. Für das 5B-Modell nennt die Dokumentation von ComfyUI
wan2.2_ti2v_5B_fp16.safetensorsinmodels/diffusion_models/,wan2.2_vae.safetensorsinmodels/vae/undumt5_xxl_fp8_e4m3fn_scaled.safetensorsinmodels/text_encoders/(ComfyUI-Dokumentation zu Wan 2.2). -
Stellen Sie Größe und Länge im Node
Wan22ImageToVideoLatentein. Bei den 14B-Modellen ist es der NodeEmptyHunyuanLatentVideo. -
Starten Sie die Warteschlange und speichern Sie den Clip. Stoppen Sie danach den Pod.
Für LTX-2 funktioniert dieselbe offizielle Vorlage. Installieren Sie die LTXVideo-Nodes über den ComfyUI Manager, wie es die Modellkarte rät. Laden Sie dann über Template Library, dann Video einen Workflow für Text-zu-Video oder Bild-zu-Video.
LTX-2 in ComfyUI
Go to Template Library > Video > choose any LTX-2 workflow

Lässt sich Wan 2.2 in ComfyUI auf Google Colab ausführen?
Auf dem Gratis-Tarif nicht zuverlässig. Laut FAQ von Google ist die Arbeit über eine Weboberfläche in kostenlosen Runtimes nicht erlaubt, und solche Runtimes werden oft beendet (Colab-FAQ). ComfyUI ist eine Weboberfläche. Für einen gemieteten Pod gilt keine solche Regel, und seine GPU wird nur berechnet, solange der Pod läuft.
Unsere Runpod-Themenseite führt die übrigen Runpod-Seiten auf, und die Preistabelle für Cloud-GPUs vergleicht diese Karten über GPU-Clouds hinweg.
Häufige Fragen zu Wan 2.2 und LTX-2 auf Runpod
Welche GPU benötigt Wan 2.2 in ComfyUI?
Eine Karte mit 24 GB wie die RTX 4090 führt das 5B-Modell mit 720P und die 14B-Modelle in fp8 mit 480p aus. Bei 720p brauchen die 14B-Modelle 48 GB in fp8, in voller Größe auf einer Karte 80 GB oder mehr.
Lassen sich Videos von Wan 2.2 in bezahlten Anzeigen verwenden?
Ja. Wan 2.2 steht unter Apache 2.0, was kommerzielle Nutzung erlaubt. Runpod vermietet nur die Karte, deshalb gilt für die Clips die Lizenz des Modells.
Ist LTX-2 für die kommerzielle Nutzung kostenlos?
Ja, unter 10.000.000 $ Jahresumsatz Ihrer ganzen Gruppe, im Rahmen der Liste verbotener Nutzungen. Darüber verlangt die Lizenz von Lightricks eine bezahlte kommerzielle Lizenz.
Wie lange braucht ein Clip von Wan 2.2 auf einer gemieteten GPU?
Runpods Leitfaden nennt etwa 71 Sekunden für einen 5-Sekunden-Clip mit 640 × 640 auf einer RTX 4090D mit der Lightning LoRA. Bei den voreingestellten 20 Schritten dauert es etwa 513 Sekunden.
Läuft die Vorlage auch mit Wan 2.1?
Ja. Wan 2.1 ist die frühere Generation, und die Vorlage von HearmemanAI lädt deren Workflows herunter, wenn Sie download_wan21 auf true setzen. Beginnen Sie mit 2.2, dem neueren Modell.
Quellen
- GitHub: Wan2.2, Apache 2.0; TI2V-5B erzeugt 720P mit 24 FPS auf einer GPU mit mindestens 24 GB, ein 5-Sekunden-Video mit 720P in unter 9 Minuten auf einer Consumer-GPU; A14B und S2V brauchen mindestens 80 GB auf einer GPU; in ComfyUI seit dem 28. Juli 2025. Geprüft am
- ComfyUI docs: Wan2.2 Video Generation ComfyUI Official Native Workflow Example, die 5B-Version sollte mit nativem Offloading von ComfyUI gut in 8 GB VRAM passen; Modelldateien und Ordner; Vorlagen über die Suche in der Template Library. Geprüft am
- Runpod: Wan 2.2 in ComfyUI on Runpod (updated 22 October 2026), One-Click-Vorlage von HearmemanAI, Download-Flags download_wan22, download_wan21 und download_wan_animate, standardmäßig alle false; CUDA 13.0 und höher; VRAM-Stufen nach GPU; 5-Sekunden-Clip mit 640x640 auf einer RTX 4090D in etwa 71 Sekunden mit der Lightning LoRA oder 513 bei 20 Schritten, Warmläufe; Benchmark von Alibaba mit 720p bei 17.4 Minuten auf einer H100, Referenzskript mit 40 Schritten, Clip-Länge nicht angegeben; Runpod führt ihn getrennt von den ComfyUI-Zeiten. Geprüft am
- Lightricks auf Hugging Face: LTX-2.3, synchronisiertes Video und Audio in einem Modell; integrierte LTXVideo-Nodes in ComfyUI; destillierte Version mit 8 Schritten. Geprüft am
- Lightricks auf GitHub: LTX-2 Community License Agreement (5 January 2026), gilt für alle seit dem 5. Januar 2026 veröffentlichten LTX-2-Versionen, die Lizenz, auf die die Modellkarte von LTX-2.3 verlinkt; Unternehmen mit Jahresumsätzen von mindestens 10 Millionen Dollar brauchen eine bezahlte Lizenz für die kommerzielle Nutzung; Attachment A listet verbotene Nutzungen auf; Lightricks erhebt keinen Anspruch auf Rechte an den Ergebnissen. Geprüft am
- MiniMax auf Hugging Face: MiniMax H3 Community License Agreement, Geltungsgebiet weltweit außer der Europäischen Union, dem Vereinigten Königreich, der Republik Korea und den Vereinigten Staaten. Geprüft am
- NVIDIA: Quick start guide for LTX-2 in ComfyUI (5 January 2026, Spanish edition), RTX 5090 mit 32 GB erzeugt einen Clip mit 720p, 24 fps und 4 Sekunden im GPU-Speicher in etwa 25 Sekunden; ein Clip von 8 Sekunden dauert etwa drei Minuten. Geprüft am
- Runpod: Runpod pricing (updated 8 October 2026), RTX 4090: 0.89 Dollar pro Stunde in Secure, 0.34 in Community; RTX 5090: 1.19 und 0.69; L40S: 1.09 und 0.79; RTX PRO 6000: 2.49 und 1.69; H100 SXM: 3.99 und 2.69. Geprüft am
- Google: Colab FAQ, die Arbeit über eine Weboberfläche statt über das Notebook ist in kostenlosen Runtimes nicht erlaubt, die oft beendet werden, wenn man mit ihnen eine Weboberfläche zur Inhaltserzeugung betreibt. Geprüft am

Alexandre S.
Alexandre S. ist Creative Ad Strategist und Copywriter mit zehn Jahren Erfahrung im digitalen Marketing über mehrere Kanäle hinweg.
Ähnliche Seiten
-
 Ratgeber Wan auf Higgsfield
Higgsfield bietet sechs Wan-Videomodelle. Ein 5 Sekunden langer Wan-3.0-Clip mit 720p kostet 8.75 Credits, nahe am Preis von Alibaba. Wann Wan Kling oder Seedance schlägt, und die Schritte.
-
 Kategorie Die besten KI-Video-Generatoren für Werbung
23 KI-Video-Generatoren und Modell-Shops im Vergleich nach Kosten pro Clip und Anzeigenbedingungen, geprüft am 25. September 2026.
-
 Profil Runpod
Runpod für Anzeigenbilder und -videos: Secure oder Community Cloud, Pods oder Serverless, Modelllizenzen und was 48 Nutzerquellen berichten. Geprüft am 24. Oktober 2026.
-
 Alternativen Runpod-Alternativen
Vast.ai, Modal, Lambda, TensorDock, Massed Compute, Paperspace und Comfy Cloud im Vergleich zu Runpod bei den Preisen für RTX 4090, 5090 und H100, gelesen am 24. Oktober 2026.


