Cloud-GPU-Preise für KI-Bilder und -Videos
Eine Cloud-GPU ist eine Grafikkarte im Rechenzentrum eines Dritten, die Sie stundenweise mieten, um KI-Modelle auszuführen. Der VRAM, der eigene Speicher der Karte, entscheidet, welche Modelle hineinpassen.
Von acht GPU-Clouds, die am 24. Oktober 2026 gelesen wurden, nennt die Community Cloud von Runpod den niedrigsten Preis für eine RTX 4090: 0,34 $ pro Stunde. Die H100 PCIe ist dort mit 1,99 $ um einen Cent die günstigste.
Die günstigsten verifizierten Hosts von Vast.ai unterbieten jeden Listenpreis bei 5090, L40S, A100 und RTX PRO 6000. Die RTX PRO 6000 kostet dort 1,08 $ gegenüber 1,69 $ bei Runpod. Bei den Zahlen von Vast.ai zählen nur verifizierte Hosts.
Auf unserem eigenen Runpod-Konto dauerte am 17. Oktober 2026 ein Bild mit 1280 x 1280 in FLUX 3 Klein auf einer RTX 4090 in der Secure Cloud etwa 28.5 Sekunden. Zum Preis dieser Stufe kostet das 0,007 $ GPU-Zeit pro Bild.
| Anbieter und Stufe | RTX 4090 (24 GB) | RTX 5090 (32 GB) | L40S (48 GB) | A100 (80 GB) | H100 (80 GB) | RTX PRO 6000 (96 GB) |
|---|---|---|---|---|---|---|
| Runpod Community Cloud Listenpreis; A100 SXM, H100 PCIe | 0,34 $ | 0,69 $ | 0,79 $ | 1,39 $ | 1,99 $ | 1,69 $ |
| Runpod Secure Cloud Listenpreis; A100 SXM, H100 PCIe | 0,89 $ | 1,19 $ | 1,09 $ | 1,79 $ | 2,89 $ | 2,49 $ |
| Runpod Serverless Flex-Worker, läuft nur auf Anfrage | 1,10 $ | 1,58 $ | 1,75 $ | 2,72 $ | 4,79 $ | 3,49 $ |
| Vast.ai, niedrigstes verifiziertes Angebot Marktplatz; H100 PCIe, RTX PRO 6000 WS | 0,41 $ | 0,64 $ | 0,74 $ | 1,07 $ | 2,00 $ | 1,08 $ |
| Vast.ai, Median der verifizierten Angebote Marktplatz; das mittlere Angebot | 0,67 $ | 1,03 $ | 0,80 $ | 1,12 $ | 2,33 $ | 1,83 $ |
| TensorDock Typischer Preis, je nach Host unterschiedlich; A100 PCIe, H100 SXM5 | 0,35 $ | Nicht aufgeführt | Nicht aufgeführt | 1,50 $ | 2,25 $ | Nicht aufgeführt |
| Massed Compute Listenpreis; H100 80 GB | Nicht aufgeführt | Nicht aufgeführt | 0,97 $ | 1,35 $ | 2,73 $ | 2,19 $ |
| Modal Preis pro Sekunde mal 3.600; H100 SXM5 | Nicht aufgeführt | Nicht aufgeführt | 1,95 $ | 2,50 $ | 3,95 $ | 3,03 $ |
| Lambda Listenpreis; H100 PCIe | Nicht aufgeführt | Nicht aufgeführt | Nicht aufgeführt | Nicht aufgeführt | 3,29 $ | Nicht aufgeführt |
| DigitalOcean GPU Droplets Listenpreis; HGX H100 | Nicht aufgeführt | Nicht aufgeführt | 1,57 $ | Nicht aufgeführt | 4,41 $ | Nicht aufgeführt |
| Paperspace On-Demand-Aktionspreis | Nicht aufgeführt | Nicht aufgeführt | Nicht aufgeführt | Nicht aufgeführt | 5,95 $ | Nicht aufgeführt |
Seitlich scrollen für alle 7 Spalten
Warum dieselbe H100 je nach Cloud dreimal so viel kostet
Die Spanne ergibt sich daraus, wem die Maschine gehört und wie lange Sie sich binden. Eine H100 kostet von 1,99 $ pro Stunde in der Community Cloud von Runpod bis 5,95 $ bei Paperspace On-Demand.
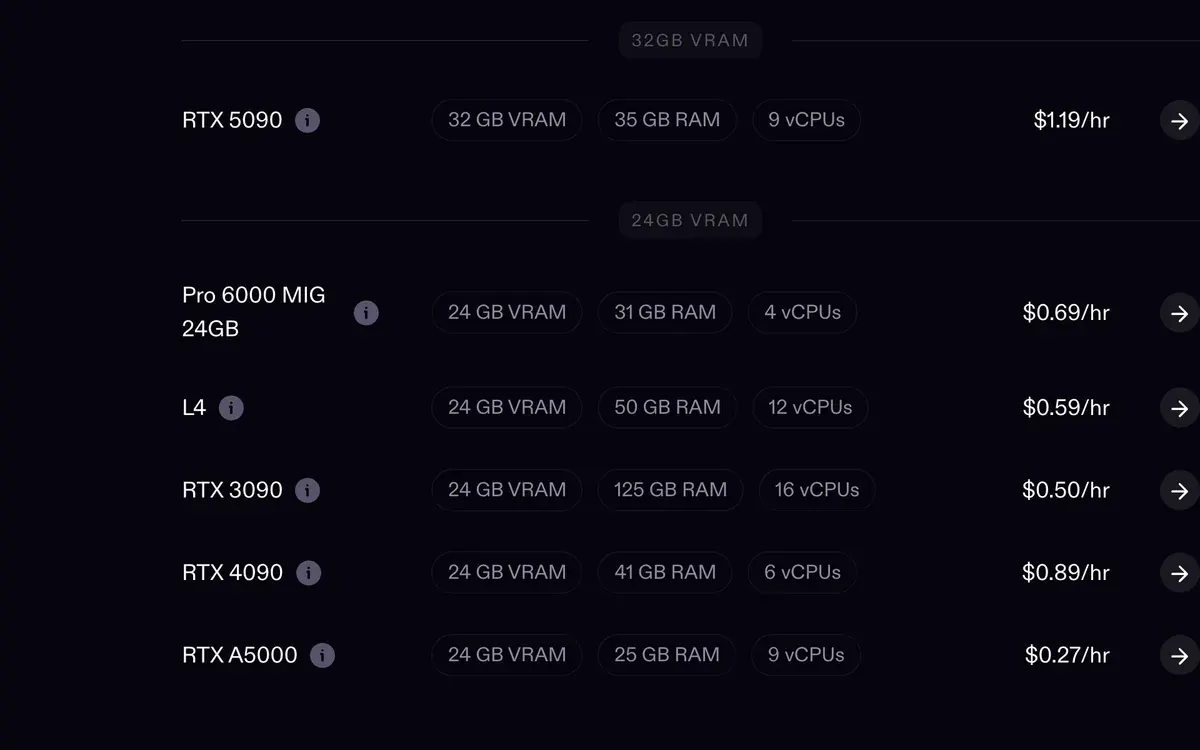
Runpod mit seiner Community Cloud und Vast.ai vermieten Maschinen, die externen Hosts gehören. Die Dokumentation zu Choose a Pod von Runpod stuft die Zuverlässigkeit der Community Cloud als „Variable“ ein, und Runpod nimmt keine neuen Community-Hosts mehr an.

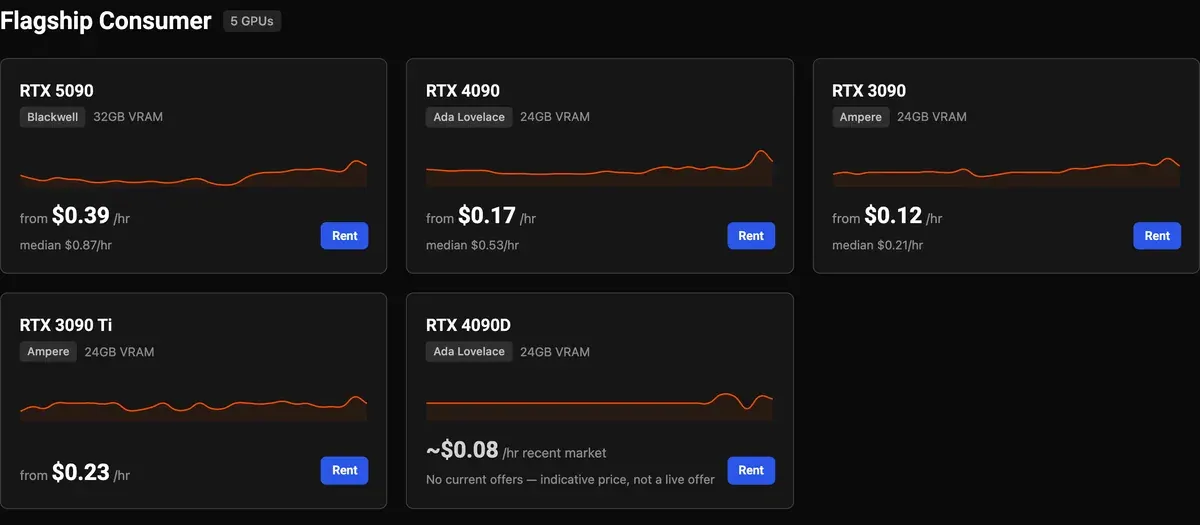
Die Hosts von Vast.ai legen ihre Preise selbst fest: Die 39 verifizierten Angebote für die RTX 4090 reichten von 0,41 $ bis zu einem mittleren Preis von 0,67 $.
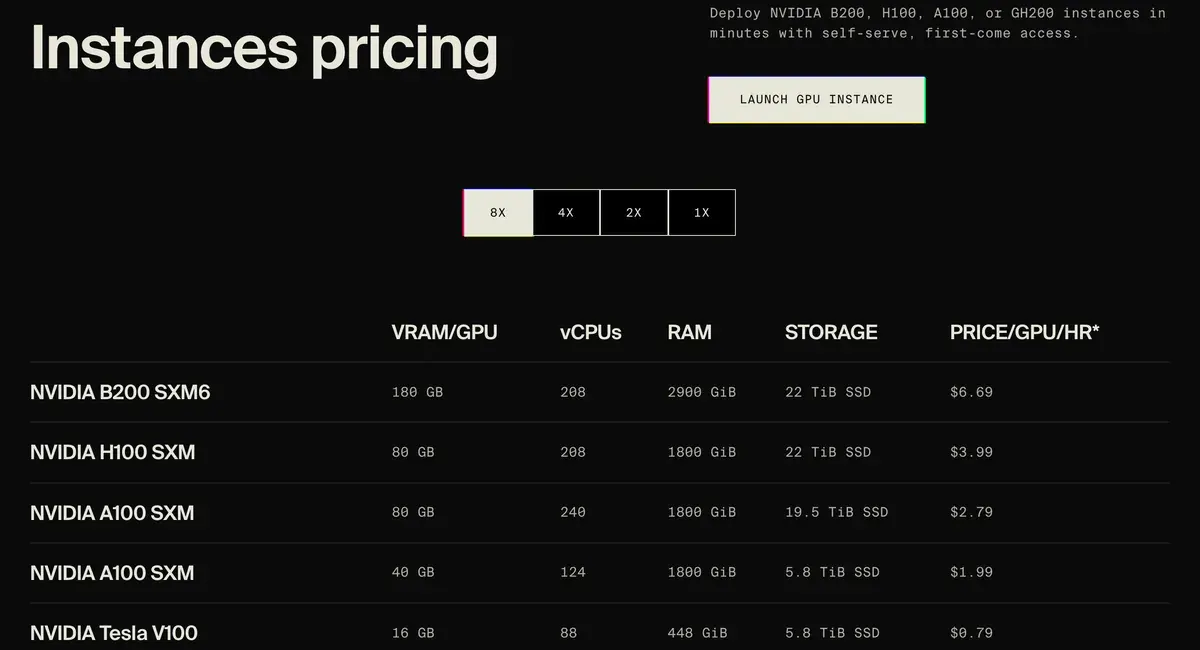
Die Bindung ist der zweite Hebel. Paperspace zeigt eine A100 für 1,15 $ pro Stunde, und zwar nur bei einer Laufzeit von drei Jahren. Lambda nennt für die A100 SXM 80 GB nur Preise für Maschinen mit acht Karten, zu 2,79 $ pro Karte.
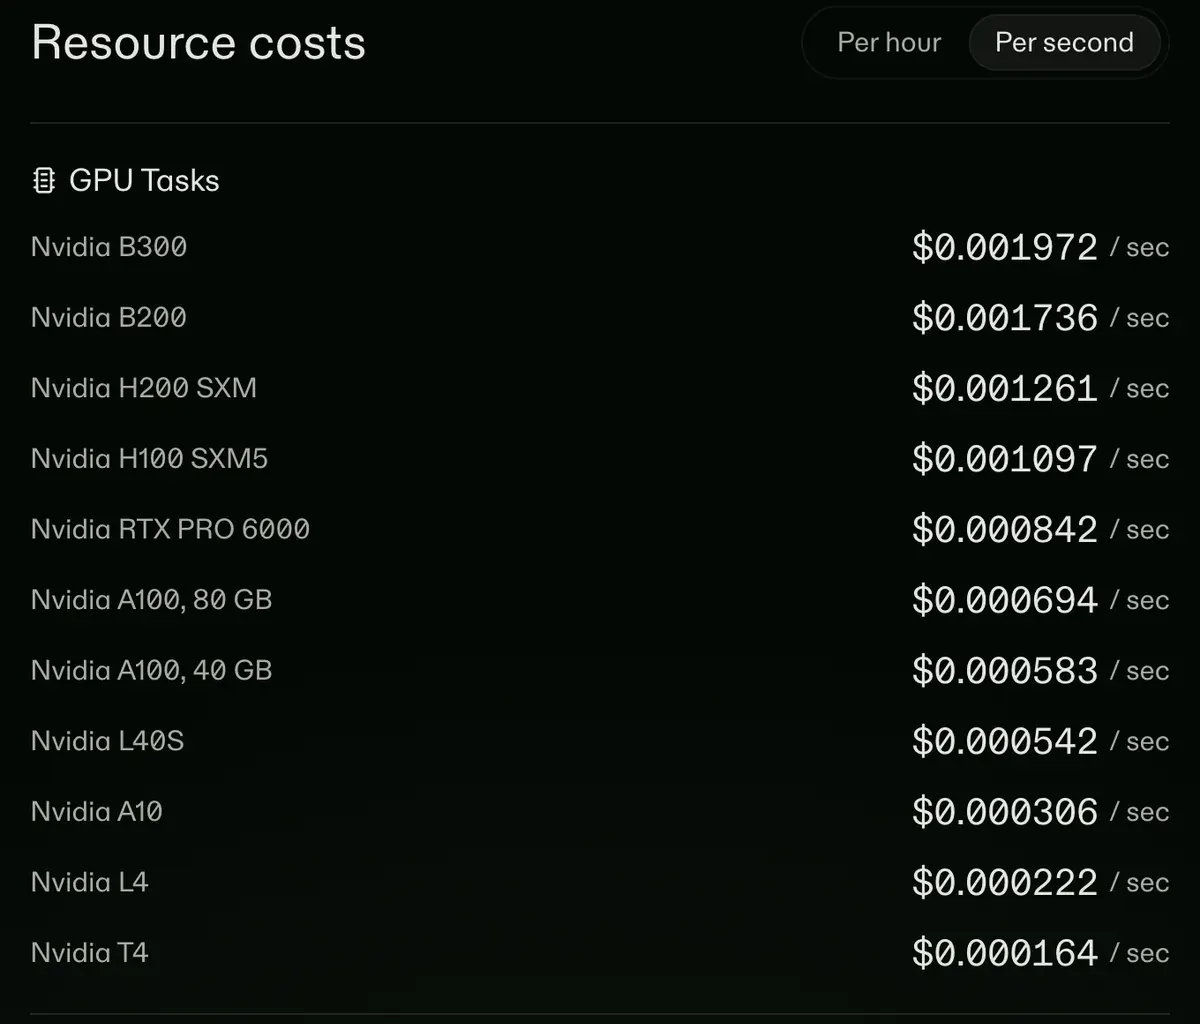
Serverless kostet pro Stunde mehr und pro Monat weniger, wenn Anfragen selten sind. Der Flex-Worker von Runpod rechnet vom Start bis zum vollständigen Stopp ab und skaliert zwischen den Jobs auf null (Runpod-Preise). Modal rechnet jede Sekunde ab, in der eine Funktion läuft, ohne Kosten zwischen den Anfragen: Der Preis für die H100 liegt bei 0,0011 $ pro Sekunde, also bei 3,95 $ pro Stunde (Modal-Preise).
Was ein Bild oder ein Clip kostet
Der Preis pro Stunde sagt wenig aus, solange Sie nicht wissen, wie schnell die Karte arbeitet. Aussagekräftig sind die Kosten pro Ergebnis: der Stundenpreis geteilt durch die Ergebnisse, die Sie in einer Stunde fertigstellen.
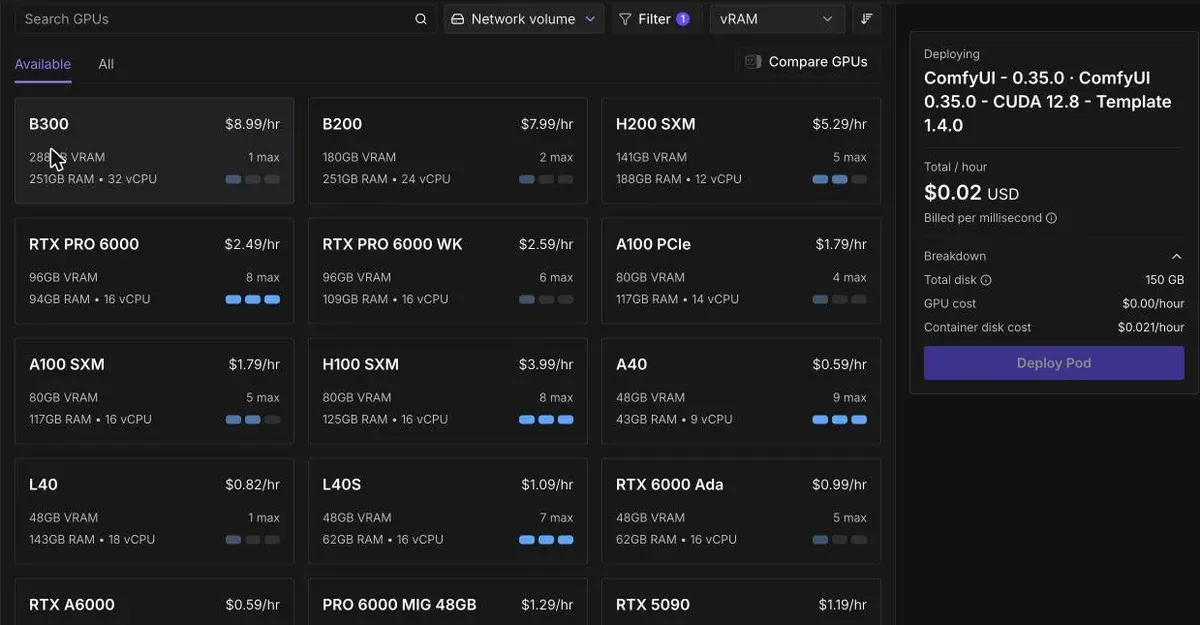
Auf unserem eigenen Runpod-Konto erzeugte eine RTX 4090 in der Secure Cloud am 17. Oktober 2026 12 Bilder mit FLUX 3 Klein in 342 Sekunden. Jedes Bild hatte 1280 x 1280 bei 16 Schritten, also etwa 28.5 Sekunden pro Bild.
Die Tabelle unten wendet diese Zeit auf jeden der 4090 Preise an. Jede Zeile geht von den 28.5 Sekunden aus, die in der Secure Cloud gemessen wurden.
| Wo die 4090 läuft | Pro Stunde | Pro 100 Bilder |
|---|---|---|
| Runpod Community Cloud | 0,34 $ | 0,27 $ |
| TensorDock, typischer Preis | 0,35 $ | 0,28 $ |
| Vast.ai, niedrigstes verifiziertes Angebot | 0,41 $ | 0,32 $ |
| Runpod Secure Cloud, gemessen | 0,89 $ | 0,70 $ |
| Runpod Serverless | 1,10 $ | 0,87 $ |
Seitlich scrollen für alle 3 Spalten
Die Einstellungen verändern die Rechnung stärker als die Cloud. Das vollständige Modell FLUX 3 Klein brauchte bei 50 Schritten auf demselben Pod etwa 4 Minuten pro Bild, also je 0,06 $.
Diese Zahlen sind reine GPU-Zeit. Dazu kommen das Starten des Pods, das Laden des Modells und der Speicher. Unsere Aufschlüsselung der Runpod-Preise rechnet diese Posten zusammen.
Bei Video messen Sie die Zeit für einen Clip auf Ihrem eigenen Pod und dividieren dann. Das von Runpod selbst gehostete Wan 2.2 erzeugt einen 5-Sekunden-Clip in 720p für 0,30 $ (Runpod-Preise). Eine gemietete 5090 für 1,19 $ ist nur dann günstiger, wenn jeder Clip weniger als 15 Minuten braucht (1.19 geteilt durch 0.30 ergibt 3.97 Clips pro Stunde).
Welche GPU für welche Aufgabe
Der VRAM ist der erste Filter. Passt ein Modell nicht hinein, läuft es in den Hauptspeicher des Computers über (Offloading); das funktioniert, ist aber langsamer.
| Aufgabe | Benötigter VRAM | Passende Karten |
|---|---|---|
| Standbilder für Anzeigen mit FLUX oder ähnlichen Bildmodellen | Modelle mit 6 bis 17 GB, auf unserem eigenen Runpod-Konto | RTX 4090 oder 5090 |
| Video mit Wan 2.2 5B | Passt in 8 GB mit dem Offloading von ComfyUI, laut Dokumentation von ComfyUI | Jede Karte der Tabelle; am günstigsten die RTX 4090 |
| Große Videomodelle um 40 GB | Mehr als die 32 GB einer 5090, auf unserem eigenen Runpod-Konto | L40S, A100 oder RTX PRO 6000 |
Seitlich scrollen für alle 3 Spalten
Ein Videomodell mit etwa 40 GB läuft über den Speicher einer 5090 hinaus und wird ausgelagert. Auf unserem eigenen Konto ist dieser Überlauf der Grund, warum eine Karte mit 96 GB trotz höheren Stundenpreises pro Clip weniger kosten kann. In der Modellkarte von Wan 2.2 heißt es zur 5B-Version: „can also run on consumer-grade graphics cards like 4090“ (Hugging Face).
Schritt-für-Schritt-Anleitungen finden Sie unter Wan 2.2 auf Runpod mit ComfyUI und ComfyUI auf Runpod. Unsere Runpod-Themenseite bündelt den Rest.
Die Lizenz des Modells gilt bei jeder Miete
Die Cloud vermietet Hardware; ob dessen Ergebnisse in einer Anzeige laufen dürfen, entscheidet die Lizenz des Modells. Wan 2.2 steht unter Apache 2.0. LTX-2 braucht eine kostenpflichtige Lizenz, sobald ein Unternehmen 10.000.000 $ im Jahr oder mehr verdient (Lizenz, Abschn. 2.1).
Die Lizenz von MiniMax H3 schließt die USA, die EU, das Vereinigte Königreich und Südkorea aus, daher dürfen die Clips dort nicht als Anzeigen laufen, egal welche GPU sie erzeugt hat. Günstigere Hosts für dieselbe Arbeit werden in den Runpod-Alternativen verglichen.
Wie die Tabelle aufgebaut ist
Ein Preis kommt in die Tabelle, wenn die eigene Seite oder API des Anbieters ihn für eine Karte On-Demand zeigt, gelesen am 24. Oktober 2026. „Nicht aufgeführt“ heißt, dass diese Seite für die GPU keinen On-Demand-Preis für eine einzelne Karte zeigt.
Die Preise von Vast.ai stammen aus der öffentlichen Angebotssuche: verifizierte, mietbare On-Demand-Angebote mit einer einzelnen GPU, sortiert nach dem Gesamtpreis pro Stunde mit der Standard-Festplatte. Modal veröffentlicht Preise pro Sekunde; die Tabelle multipliziert sie mit 3.600. Die Seite von TensorDock nennt einen typischen Preis, der je nach Host variiert, und gibt als letzte Aktualisierung den 24. Juli 2024 an.
Jede Zeile hat einen Anker, sodass ein Link wie /data/cloud-gpu-prices/#runpod-community stabil bleibt. Korrekturen erscheinen in der Änderungsliste dieser Seite und unter Aktualisierungen und Korrekturen.
So zitieren Sie diese Daten
adtestbench, „Cloud-GPU-Preise für KI-Bilder und -Videos“, https://adtestbench.com/data/cloud-gpu-prices/, aktualisiert am .
- CSV-Datei /data/cloud-gpu-prices.csv
Quellen
- Runpod: Runpod pricing, Preise für Secure Cloud, Community Cloud und Serverless; die GPU-Type-API auf unserem eigenen Konto lieferte dieselben Werte. Geprüft am
- Vast.ai: Vast.ai offer search API, verifizierte, mietbare On-Demand-Angebote mit einer GPU; der Gesamtpreis pro Stunde enthält die Standard-Festplatte. Geprüft am
- Vast.ai: Vast.ai pricing, Preise von den Hosts festgelegt. Geprüft am
- Lambda: Lambda GPU cloud pricing, Preis pro GPU und Stunde, minutengenau abgerechnet, zzgl. Umsatzsteuer oder VAT. Geprüft am
- Modal: Modal pricing, GPU-Preise pro Sekunde. Geprüft am
- TensorDock: TensorDock cloud GPUs, typischer Stundenpreis, je nach Host unterschiedlich, Abrechnung pro Sekunde; Seite zuletzt aktualisiert am 24. Juli 2024. Geprüft am
- Massed Compute: Massed Compute pricing. Geprüft am
- DigitalOcean: DigitalOcean GPU Droplets pricing, Abrechnung pro Sekunde, Mindestdauer von 5 Minuten. Geprüft am
- Paperspace (DigitalOcean): Paperspace pricing, H100 On-Demand zum Aktionspreis; A100-Preis nur bei dreijähriger Bindung angezeigt. Geprüft am
- ComfyUI-Dokumentation: Wan2.2 in ComfyUI, das 5B-Modell und natives Offloading. Geprüft am
- Runpod-Dokumentation: Choose a Pod, Zuverlässigkeit der Community Cloud „Variable“; keine neuen Community-Hosts. Geprüft am
- Wan-AI auf Hugging Face: Wan2.2 TI2V-5B model card, Apache 2.0; läuft auf Consumer-Karten wie der 4090. Geprüft am
- Lightricks auf GitHub: LTX-2 Community License Agreement, Abschn. 2.1. Geprüft am

Alexandre S.
Alexandre S. ist Creative Ad Strategist und Copywriter mit zehn Jahren Erfahrung im digitalen Marketing über mehrere Kanäle hinweg.
Ähnliche Seiten
-
 Daten Preis-Tracker für KI-Anzeigen-Tools
Bei 69 von 82 KI-Anzeigen-Tools steht ein Listenpreis, gelesen auf der eigenen Seite des Anbieters, zuletzt geprüft am 16. Oktober 2026, mit den Kosten pro Clip oder Bild, wo der Credit-Verbrauch das erlaubt.
-
 Ratgeber ComfyUI-Workflow für KI-Influencer
Die ComfyUI-Bausteine hinter einem KI-Influencer, die Lizenz jedes offenen Modells, wo es Workflows gibt und die Kosten der gemieteten GPU pro Bild. Geprüft am 24. Okt. 2026.
-
 Preise Higgsfield-Preise
Higgsfield-Tarife beginnen bei 19 $ pro Monat für 270 Credits, also ca. 0,07 $ pro Credit. Was Unlimited abdeckt, der Gratis-Tarif, die Testphase und Rückerstattungen. Geprüft am 25. Okt. 2026.


