Cómo crear un personaje UGC de IA realista en Higgsfield
Un creador UGC de IA creíble es una persona inventada, creada una vez y reutilizada en cada plano. En Higgsfield eso lleva seis pasos. Escribe quién es, genera el rostro y fíjalo. Luego colócalo con tu producto, haz que hable y quítale el aspecto de IA.
| Paso | Herramienta o modelo de Higgsfield | Lo que obtienes | Créditos |
|---|---|---|---|
| 1. Ficha de casting | Ninguna: una nota o un chat | Una página sobre quién es | Ninguna |
| 2. Rostro | Soul 2.0 o Nano Banana Pro | Retratos candidatos | 0.12 por imagen en Soul 2.0, 2 en Nano Banana Pro |
| 3. Fijar | Soul ID o una hoja de referencia | El mismo rostro en cada plano | Soul ID: un tope mensual; una hoja cuesta 2 |
| 4. Habitación y producto | Nano Banana Pro con referencias | Fotogramas iniciales, con el producto en la mano | 2 por fotograma |
| 5. Hablar | Seedance con sonido, o Speak 2.0 | Un clip con sincronización labial (lip-sync) | Unos 22 por 5 segundos (Seedance 2.0, 720p); unos 14 por 5 segundos (Speak 2.0, 720p) |
| 6. Quitar el aspecto de IA | Tu editor y luego el escalador | Un montaje cortado, con color y subtítulos | Ninguno en el editor |
Desliza hacia los lados para ver las 4 columnas
¿Qué hace que un creador UGC de IA parezca real?
El UGC real es un video de teléfono grabado en la vida de alguien. Cuatro señales delatan a un creador de IA:
- Piel de plástico: sin poros, sin marcas, con un color perfectamente uniforme.
- Luz de ninguna parte: un brillo suave de estudio en una cocina con una sola ventana.
- Una cámara que nadie sostiene: encuadre centrado, enfoque perfecto, un fondo tan ordenado como un plató.
- Un rostro que cambia entre planos: una nariz nueva en el primer plano, una línea del cabello nueva en el siguiente clip.
La propia lista de causas de Higgsfield apunta en el mismo sentido: sin ancla de identidad, imágenes de referencia que se desvían, el modelo equivocado y ninguna capa de sincronización labial.
Why AI Characters Look Weird: The Root Causes
No identity anchor. When you describe a character in text only, the model interprets that description freshly each generation.
Reference image drift. When the scene changes, the anchor weakens and the face starts to drift.
Wrong model for the use case. Some models handle human subjects better than others.
Missing lip sync layer. When audio and video generate separately and get combined in post, the mouth movements are approximated rather than driven by the actual audio. The result looks dubbed.
Low-resolution prototyping at final quality expectations. A face that looks acceptable at 720p can look wrong at 1080p because the higher resolution reveals artifacts the lower resolution masks.
Cada paso de abajo elimina una de ellas.
Paso 1: Escribe una ficha de casting
Una ficha de casting es el documento de identidad del creador. Escríbela antes de cualquier prompt, porque cada prompt posterior la copia palabra por palabra.
Elige el casting según el producto, nunca el rostro más guapo: una botella para trabajadores por turnos pide a alguien que trabaja por turnos.
Name: Dana. Age: 34. British, Nigerian parents.
Life: A&E nurse on 12-hour nights, two kids, small terraced house.
Why she films: short honest clips about getting through night shifts.
Where: her kitchen just after a shift, her parked car, the hospital car park.
Camera: her phone, front camera, held in one hand.
Wardrobe: grey marl sweatshirt with a stretched collar, black leggings, white trainers with no logo.
Two signature details: a healed scar through one eyebrow, a black hair band.
Voice: London accent, low and dry, a little tired, quick to laugh.
Revisa los dos detalles distintivos en cada plano: son la forma más rápida de detectar una desviación.
Paso 2: Genera el rostro
Genera el rostro solo, sobre una pared lisa, antes de cualquier escena. Un retrato le da al modelo una sola tarea; una escena le pide inventar a la vez la habitación, la luz y el rostro.
Soul 2.0, el modelo de imagen propio de Higgsfield para personas, cuesta 0.12 créditos por imagen; Nano Banana Pro de Google cuesta 2. Ejecuta el mismo prompt en ambos y quédate con el mejor rostro.
A head-and-shoulders photo of a 34-year-old British woman with Nigerian parents, short natural hair pushed back with a black band, small gold studs, a grey marl sweatshirt with a stretched collar. She sits against a plain off-white wall, lips closed, a tired half-smile that reaches her eyes. Soft overcast daylight from a window off frame to one side, about 5600K, the far cheek in gentle shadow. Taken by her sister about a metre away on a phone at eye level. Skin after a night shift: pores across the nose, faint dark circles, a healed scar through one eyebrow, a light oil sheen on the forehead. Muted colour, fine phone grain, no plastic skin, no watermark, no readable text anywhere.
El prompt nombra la fuente y la temperatura de color de la luz (5600K es luz de día), quién sostiene la cámara y las marcas que el día deja en la piel. Palabras como “ultra-realistic”, “8K” o “perfect lighting” empujan al modelo hacia el acabado pulido que intentas evitar.
Juzga cada rostro a tamaño completo: poros visibles, ambos ojos del mismo color, un pequeño reflejo de la ventana en cada uno. Si uno falla, vuelve a generar. Un rostro débil solo empeora en movimiento.
Una construcción completa de un personaje en Soul 2.0, desde el primer prompt hasta el rostro final, aparece en este recorrido de Lera AiLab:

Paso 3: Fija el personaje para que cada plano sea la misma persona
Fijar le da a Higgsfield un registro fijo del rostro, para que deje de reinventarlo. La primera vía es Soul ID, el personaje entrenado de Higgsfield. Su artículo de ayuda pide “20 o más fotos de la misma persona (hasta 80 admitidas)”, y dice que el entrenamiento “tarda unos minutos”.
What is Soul ID?
Train once and reuse the identity.
A trained Soul ID works across the Soul family.
Para un creador inventado, Higgsfield dice que hay que “generar primero esos retratos y luego entrenar un Soul ID con ellos”: 20 retratos del rostro elegido, con distintos ángulos y expresiones, uno de cuerpo entero. Los personajes entrenados “aparecen en Elements automáticamente”, y así llega el rostro al video de Seedance.
Higgsfield fija el listón en “claramente la misma persona” entre generaciones; no promete un rostro idéntico al píxel. Cada plan limita las generaciones de Soul ID al mes: 9 en Starter y 40 en Plus, con facturación mensual.
Code And Create entrena un Soul ID a partir de fotos subidas, de principio a fin:

La segunda vía es una hoja de referencia: cuatro vistas de la persona en una imagen, adjunta a cada prompt posterior. Cuesta una imagen de Nano Banana Pro.
Image 1 is the woman: face, hair and build only. One photo, a 2 by 2 grid of this exact woman against the same off-white wall in the same window daylight. Top left: facing the camera, lips closed. Top right: three-quarter view. Bottom left: full profile. Bottom right: full length, hands in the sweatshirt pocket, black leggings, plain white trainers. The hair band, gold studs and eyebrow scar in every panel. Unretouched phone photo, no plastic skin, no watermark, no readable text anywhere.
Prueba pronto un primer plano: ahí es donde primero se desvían los rostros. Cinco de 52 fuentes públicas atribuyen a Soul ID, Elements y las hojas de referencia el mérito de mantener coherentes a los personajes (YouTube, Reddit). El entrenamiento completo: la guía de Soul.
Paso 4: Ponlo en una habitación real con el producto
Estas imágenes se convierten en los fotogramas iniciales de tu video. En Image, elige Nano Banana Pro y adjunta el retrato maestro, la hoja y una foto real de tu producto. Luego di para qué sirve cada imagen: una imagen sin función indicada se copia entera.
How do I generate with Nano Banana Pro?
Open higgsfield.ai → Image → Nano Banana Pro.
Choose your input mode: Text-to-Image, Multi-reference, or Image-to-Image.
Write a clear, specific prompt. Describe the subject, setting, lighting, and any specific quantities or text. Be explicit.
Add references if needed (up to 14), and describe the role of each reference in the prompt.
Set the resolution. Start at 1K when iterating, scale to 2K or up to native 4K for final assets.
Generate and iterate. If something is off, change the prompt or the reference, not both at once.
Images 1 and 2 show the woman: face, hair and build only. Image 3 is the product only: shape, colour and label exactly as shown. She stands at her kitchen counter at 8:10 in the morning, just home from a night shift, in the grey sweatshirt. She holds the sage-green steel bottle at chest height, four fingers round it, thumb on the far side, label flat to the camera and a little closer to the lens than her face. She films herself on her phone's front camera at arm's length, just above eye level. Behind her: a kettle, a fruit bowl, her lanyard face down on the counter. Cool daylight from a window behind the phone, about 5200K, and a warm 2700K under-cabinet light. The label reads "FIELDWELL" in large white capitals. Mild phone HDR, slight wide-angle stretch at the edges, no plastic skin, no watermark, no other readable text.
Escribe entre comillas cada palabra de la etiqueta: lo que dejes fuera se inventa. Y usa una foto del producto real, nunca un render de IA.
Revisa la mano a tamaño completo: cuatro dedos y un pulgar, sujetando con peso. Arreglos de agarre, escala y etiqueta a fondo: producto en la mano en UGC de IA.
Paso 5: Haz que hable
Un video con diálogo necesita un guion lo bastante corto para decirlo en voz alta. Parte de un presupuesto de unas dos palabras y media por segundo: de 36 a 40 palabras para una toma de 15 segundos. Con más palabras suena apresurado. Con menos, el modelo rellena el hueco con balbuceos.
Escribe el guion como un creador que muestra el producto a cámara, en su propio día. Quita las frases hechas (“un antes y un después”, “estoy obsesionado”) y cualquier resultado que tu producto no pueda dar. Plantillas por formato de anuncio: plantilla de guion UGC.
La propia lista de verificación de Higgsfield para video con diálogo añade dos arreglos para un rostro congelado. Dale a la imagen de origen una expresión ligera y natural, y escribe indicaciones de emoción en el guion.
How to make an AI Talking Video Feel Real?
A believable LipSync video coordinates six elements simultaneously: lip movement aligned to speech phonemes; facial expressions that shift with emotional content; eye movement; subtle head motion that follows speech rhythm; gestures that match meaning; voice delivery with pacing, pauses, and tonal variation.
Frozen facial expressions. The cause is usually a source image with a neutral, flat expression. Use an image where the subject has a light, natural expression, not a passport-photo neutral face. Adding emotion cues to the script also helps: words like [excited], [thoughtful], or [warm] in brackets give performance-based models a signal to animate from.
La primera vía es Seedance, que genera “video con sonido nativo en una sola pasada, con sincronización labial en varios idiomas” (artículo de ayuda de Seedance).
Seedance 2.0 dura de 4 a 15 segundos. Seedance 2.5 llega hasta 30, en Plus y superiores. Elige tu personaje de Soul con @ desde Elements, o sube la hoja de referencia. Para mantener una sola voz, sube un archivo de voz y etiquétalo con @audio.
9:16, 15 seconds, one continuous selfie take, no cuts. Spoken language: British English.
Start frame: the kitchen still. THE WOMAN is @Dana. THE BOTTLE keeps its shape, colour and the word "FIELDWELL".
0 to 3 s: THE WOMAN lifts the bottle into frame and speaks within the first half-second. DANA (dry, tired, warm): "The label says ice for twenty-four hours. Night shift, so fair test."
3 to 10 s: She tilts the bottle towards the lens and shakes it once; ice knocks inside. DANA (matter-of-fact): "Listen to that. Ice, and plenty of it, still knocking about in there."
10 to 15 s: She lowers the bottle onto the counter, out of frame. DANA (a small laugh): "Which is more than I can say for my coffee. Right, bed." She settles, eyes on the lens.
Camera: we look through the phone in her other hand: a small breathing bob, a slight wrist roll, quick reframing. Real time, normal speed.
Sound: her voice, ice, a fridge hum, no music. Only Dana speaks, only these lines. Pores stay on her skin; four fingers and a thumb on each hand; no subtitles, no watermark.
Cada acción usa una sola mano, porque la otra sostiene el teléfono: abrir una tapa con una mano es el fallo de mano que el Paso 6 elimina. La línea de cámara describe el brazo que sostiene el teléfono, algo que los modelos manejan mejor que “handheld shake”.
En el montaje, abre con un clip de 3 segundos de hielo cayendo en la botella, con una ventana oscura detrás. Así la afirmación se muestra, nunca solo se dice.
GameTrainer US pasa de una imagen de avatar a un anuncio UGC hablado dentro de Higgsfield:

La segunda vía es Lipsync Studio, que crea un clip hablado a partir de una imagen y un guion escrito (artículo sobre lipsync); sincronización labial en Higgsfield lo explica paso a paso.
How do I use lipsync, voiceover, and aspect ratios?
Voice generation, voice change, and translation live in Audio, while making a character talk (lip sync) lives in Lipsync Studio, which offers several models for image-to-video and video-to-video talking clips. Some video models also generate audio together with video in a single pass. Aspect ratio is set per generation inside each tool: common options are 9:16 for vertical, 16:9 for horizontal, and 1:1 for square, and not every model supports every ratio.
Su motor Higgsfield Speak 2.0 está en Plus y Ultra, a unos 14 créditos por 5 segundos a 720p. La clonación de voz está permitida para “una voz que es tuya o una que tienes permiso de la persona para usar”.
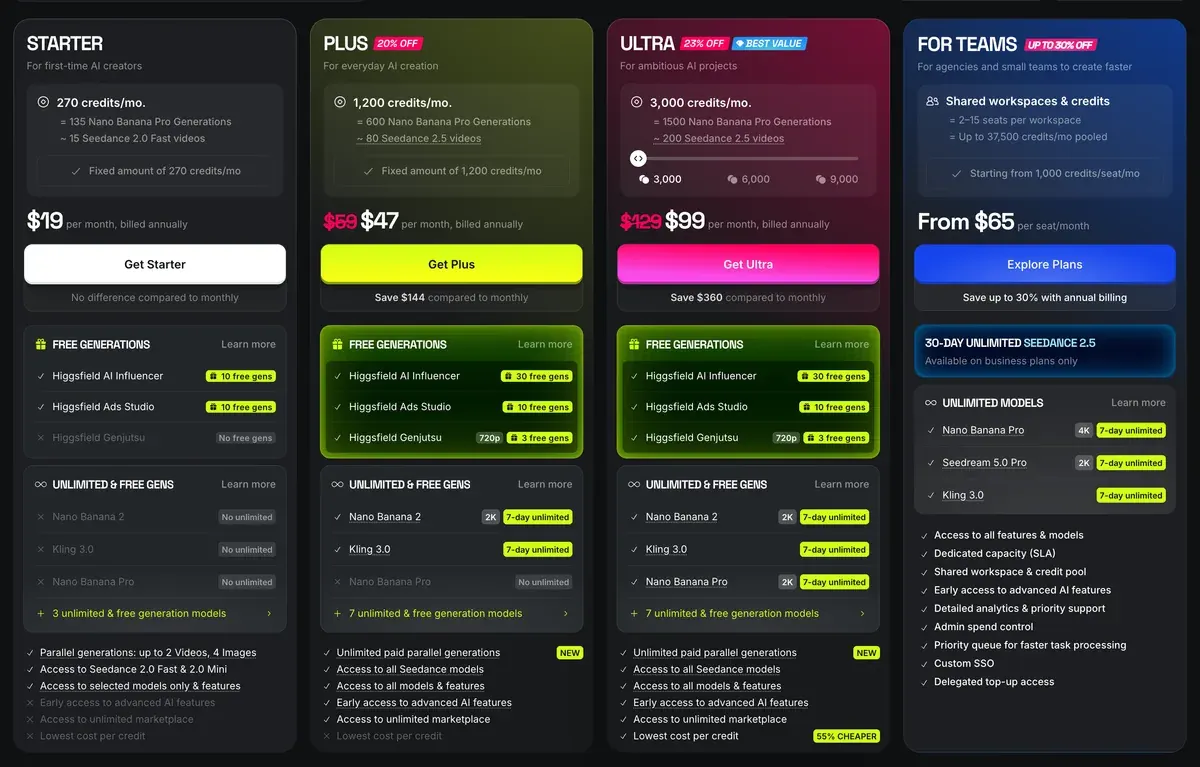
En Plus, que abre Seedance 2.5 y Speak, el plan cuesta $49 al mes (página de precios; planes completos en precios de Higgsfield).
La tabla comparativa, consultada el 19 de octubre de 2026, lista 22 créditos por 5 segundos. Un clip de 15 segundos de Seedance 2.0 a 720p son entonces unos 66 créditos. Los 1,000 créditos mensuales de Plus cubren unas 15 tomas así, si se usan todos los créditos.
Paso 6: Quita el aspecto de IA
El video de IA en bruto es demasiado limpio: mucho contraste, color intenso, una cámara que nunca se mueve. Corrígelo en tu editor.
- Recorta cada clip hasta su primera sílaba y corta cualquier momento en que falle una mano o la etiqueta.
- Cambia de plano cada pocos segundos. Cuando el creador nombre el producto, muéstralo de cerca. Los planos de apoyo también esconden un tramo de sincronización labial débil.
- Añade una capa de ajuste sobre todo el montaje. Baja el contraste hasta que deje de parecer un render y luego recupera el color.
- Añade un efecto de temblor tan leve que el espectador no lo note.
- Añade los subtítulos en el editor, nunca en la generación, donde el texto de IA sale confuso.
- Exporta a 1080p, 9:16.
Para una ubicación grande, el escalador de video de Higgsfield lleva los clips a 1080p, 2K o 4K con ByteDance o Topaz. El flujo completo del montaje al lanzamiento está en cómo hacer anuncios UGC de IA.
Qué sale mal y cómo arreglarlo
La mayoría de las tomas fallidas se deben a una instrucción que falta. Encuéntrala antes de gastar créditos en otro intento.
| Lo que ves | Por qué | Solución |
|---|---|---|
| Piel de plástico, retocada | Palabras de acabado pulido, sin marcas en la lista | Quita “ultra-realistic”; lista de 4 a 7 marcas que deja el día |
| Luz brillante de estudio en interiores | Sin fuente de luz nombrada | Nombra la ventana o la lámpara, su lado y su temperatura de color |
| Centrado, posando, mirando a la cámara | Nadie sostiene la cámara | Di quién hace la foto, desde qué distancia y a qué altura |
| Un rostro nuevo en cada plano | Sin fijar | Entrena un Soul ID o adjunta siempre la hoja de referencia |
| El rostro se desvía en los primeros planos | A la hoja le falta una vista cercana | Añade un panel de primer plano; prueba antes los primeros planos |
| Cambian las letras de la etiqueta | Palabras de la etiqueta sin escribir | Entrecomilla cada palabra de la etiqueta; usa un packshot real |
| Carteles o subtítulos ininteligibles | El modelo inventa texto | Deja el texto fuera del encuadre; añade los subtítulos en el montaje |
| Labios que se retrasan o balbucean | Guion demasiado largo o demasiado corto | Reescríbelo a unas dos palabras y media por segundo |
| La voz cambia entre clips | Una voz nueva en cada generación | Sube un archivo de voz y etiquétalo con @audio |
Desliza hacia los lados para ver las 3 columnas
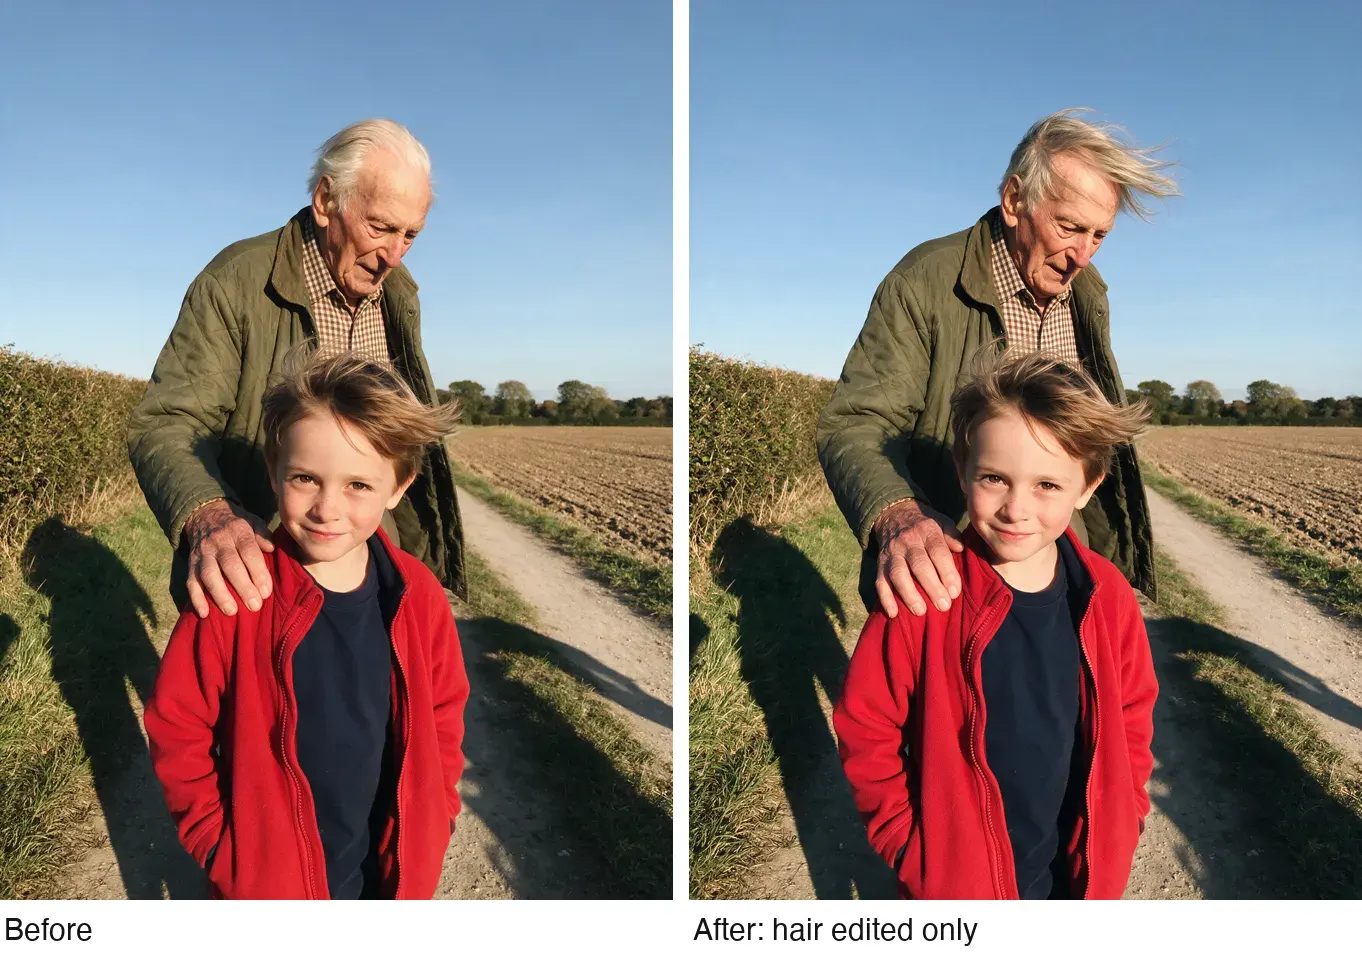
Cuando una imagen está casi bien, edítala: un prompt que cambia una sola cosa deja el resto en su sitio. En el par de abajo, un prompt cambió solo el cabello del hombre; revisa el rostro del niño, las manos y el fondo, que siguen como estaban.
Cuatro personajes UGC más, listos para adaptar
La ficha de casting de Dana está en el Paso 1; aquí van cuatro más. Cada prompt crea un creador como retrato para los Pasos 2 y 3. Cambia los detalles para ajustarlos a tu producto; mantén el orden: persona, lugar, luz, quién sostiene la cámara, piel.
Un papá que cocina en casa, para marcas de cocina y alimentos:
Head-and-shoulders photo of a 58-year-old Korean American man, thinning grey hair, reading glasses pushed up on his forehead, a faded navy apron over a flannel shirt, against a plain cream wall, lips closed, a patient half-smile. Warm 3000K pendant light from above one side. Taken by his daughter a metre away at eye level on a phone. Skin: deep smile lines, age spots on one temple, stubble missed under the jaw. Fine phone grain, no plastic skin, no watermark, no readable text anywhere.
Una estudiante de enfermería, para snacks, estudio y apps de presupuesto:
Head-and-shoulders photo of a 24-year-old Mexican American woman in navy scrubs, dark hair in a loose clip with strands falling out, sitting in the driver's seat of a parked car after a shift, head resting back, lips closed. Flat grey daylight through the windscreen, about 6000K. Taken on her own front camera, held just below her chin. Skin: a red mask mark across the nose, mascara softened under one eye, oil sheen on the forehead. Mild phone HDR, no plastic skin, no watermark, no readable text anywhere.
Una corredora, para ropa deportiva y productos de recuperación:
Head-and-shoulders photo of a 41-year-old white Scottish woman, auburn hair in a damp ponytail, a black running jacket zipped to the chin, against a stone park wall in fine drizzle, breathing hard, lips closed, a tight satisfied smile. Overcast light from above, about 6500K. Taken by her running partner a metre away at chest height on a phone. Skin: windburn on both cheeks, freckles, water beads on the forehead, flyaway hairs stuck to one temple. Fine grain, no plastic skin, no watermark, no readable text anywhere.
Un jardinero jubilado, para marcas de hogar, jardín y salud:
Head-and-shoulders photo of a 67-year-old Black British woman of Caribbean heritage, short silver curls, small hoop earrings, a mustard cardigan with soil on one cuff, at her back door against a pale green frame, lips closed, smiling with her eyes. Low late-afternoon sun from one side, about 3500K. Taken by her grandson a metre away at eye level on a phone. Skin: fine lines around the eyes, dark marks on the cheekbones, dry knuckles. Fine grain, no plastic skin, no watermark, no readable text anywhere.
Reglas para usarlo como anuncio
- Etiquétalo donde la plataforma lo pida. La política de anuncios de TikTok exige una etiqueta en los anuncios con “imágenes, video o audio completamente generados por IA” (etiqueta de IA de TikTok). Meta solo exige que indiques tú el uso de IA en los anuncios políticos y de temas sociales, y etiqueta ella misma los demás anuncios cuando detecta IA (divulgación de IA de Meta).
- La etiqueta también es lo que mantiene a un creador de IA dentro de las condiciones de Higgsfield, 5.2(xi), que prohíben presentar “que cualquier resultado es generado por humanos cuando no lo es”.
- Haz que el personaje hable como un creador que muestra el producto a cámara, nunca como un cliente que cuenta sus propios resultados. Un rostro de IA que dice “lo uso desde hace meses” es un testimonio falso según la norma de la FTC (UGC de IA y la ley). Dana lee la afirmación de la marca y muestra el hielo; nunca habla de meses de uso.
- No uses el rostro ni la voz de una persona real sin consentimiento por escrito. La sección 5.3 de las mismas condiciones te obliga a garantizar todos los consentimientos de los rostros y voces que subas.
Para ir más a fondo
El método de esta página sigue técnicas enseñadas en AI Video Bootcamp, un curso de pago en Skool. Cada pestaña de Higgsfield está en cómo usar Higgsfield, y cada página de Higgsfield en el hub de Higgsfield.
- Modelos: Seedance, Kling, Nano Banana, prompts de UGC de IA.
- Avatares listos: Marketing Studio, AI Influencer. Planes y condiciones: el perfil de Higgsfield.
Marketing Studio es el atajo: Higgsfield lista más de 40 avatares listos, o uno personalizado hecho con Soul 2.0.
Preguntas sobre UGC de IA realista en Higgsfield
¿Puede Higgsfield hacer UGC de IA realista?
Tiene todas las piezas: Soul 2.0 y Nano Banana Pro para los rostros, Soul ID para fijarlos, Seedance y Speak para los clips hablados. Las reseñas públicas respaldan las imágenes. Una reseña de Trustpilot sobre una campaña de cosméticos llama a las imágenes de Soul fotorrealistas y coherentes, y un hilo de reseñas en Reddit también las elogia.
¿Mi creador de IA puede hablar francés o español?
Sí. Seedance genera sincronización labial “en varios idiomas”, y las herramientas de voz de Higgsfield traducen un guion a 18 idiomas (artículo sobre lipsync). Escribe el guion en el idioma de destino e indica el idioma hablado en la primera línea del prompt.
¿Puedo crear una versión de IA de mí mismo?
Sí, con entre 20 y 80 fotos tuyas en un Soul ID. La regla propia de Higgsfield: “Sube solo fotos tuyas o de alguien que te haya dado permiso para usar su imagen”.
Todas las guías de Higgsfield, ordenadas por tarea, están en el centro de Higgsfield
Fuentes
- Centro de ayuda de Higgsfield: How do I create and use a Soul ID character?, 20 o más fotos de una persona, hasta 80; rostros inventados entrenados a partir de retratos generados; los personajes de Soul aparecen en Elements; modificado el 2 de septiembre de 2026. Revisado el
- Centro de ayuda de Higgsfield: How do I use Soul to generate images?, Soul, Soul 2.0 y Soul Cinema, proporciones de 9:16 a 16:9, lotes de 1 a 4, el campo de prompt se cierra al adjuntar una imagen de referencia. Revisado el
- Centro de ayuda de Higgsfield: How do I use Seedance?, duración de los clips, límites de referencias, las etiquetas @character y @audio, sonido nativo con sincronización labial en varios idiomas, Seedance 2.5 en Plus y superiores; modificado el 9 de septiembre de 2026. Revisado el
- Centro de ayuda de Higgsfield: Lipsync, voiceover and aspect ratios, motores de Lipsync Studio desde Higgsfield Speak 2.0 hasta Sync Lipsync 3, clonación de voz con permiso, traducción a 18 idiomas; modificado el 1 de septiembre de 2026. Revisado el
- Higgsfield: Higgsfield pricing, tabla comparativa consultada en un navegador: Soul 2.0, Nano Banana Pro, Seedance 2.0 y topes de Soul ID el 19 de octubre de 2026; Speak 2.0 y Speak por plan el 9 de octubre de 2026. Revisado el
- Higgsfield: AI video upscaler, escalado de ByteDance y Topaz a 1080p, 2K o 4K. Revisado el
- Higgsfield: Condiciones de uso de Higgsfield (26 de julio de 2026), 4.2(b) y 5.3 sobre imagen y consentimiento, 5.2(xi) sobre resultados presentados como generados por humanos, 5.5 sobre la divulgación de IA. Revisado el
- TikTok: TikTok ads policy, misleading and false content, etiquetar los anuncios con imágenes, video o audio completamente generados por IA; actualizado en abril de 2026. Revisado el
- Trustpilot, Reddit y YouTube: Reseñas de usuarios de Higgsfield, 52 fuentes públicas sintetizadas, revisadas el 28 de septiembre de 2026. Revisado el
Qué cambió en esta página
- Los precios de Higgsfield retrocedieron: Starter cuesta 15 dólares al mes por 200 créditos, Plus 49 al mes o 39 con facturación anual por 1,000 créditos, y Ultra 129 o 99 con facturación anual vuelve a tener tarjeta (antes Starter 19 por 270, Plus 59 o 47 por 1,200).

Alexandre S.
Alexandre S. es estratega creativo de anuncios y redactor publicitario, con diez años de experiencia en marketing digital en múltiples canales.
Páginas relacionadas
-
 Guía Seedance para anuncios UGC de IA
El filtro de rostros de Seedance rechaza rostros reales y de IA en 10 de 35 reseñas de usuarios. El consentimiento que piden sus condiciones y cómo escribir el prompt de un clip UGC. Revisado el 2 de octubre de 2026.
-
 Guía Significado de UGC con IA: ¿qué es el UGC con IA?
El UGC con IA es video publicitario hecho con IA para parecer grabado por un cliente. Sus dos significados y reglas de proveedores sobre pasarlo por humano
-
 Guía Higgsfield motion control
Cómo funcionan el motion control y los motion presets de Higgsfield, qué modelos los admiten, cuánto cuestan y ejemplos que sirven para anuncios. Revisado el 16 de octubre de 2026.
-
 Guía UGC con IA vs UGC humano: qué dice la evidencia
Comparativas públicas de anuncios UGC con IA y humanos, calificadas por cómo y quién las hizo. La mayoría son de vendedores o una cuenta. 24 sep 2026.


