Sincronización labial (lip sync) en Higgsfield
El lip sync (sincronización labial) hace que un rostro en una foto o video mueva la boca al ritmo de un guion. En Higgsfield, el lipsync está en Lipsync Studio, dentro de Video. Aportas un rostro y una línea de texto, eliges uno de ocho modelos y obtienes un clip hablado. La voz viene de la pestaña Audio de Higgsfield, donde puedes clonar la tuya.
| Dónde | Qué hace | Qué aportas | Créditos |
|---|---|---|---|
| Lipsync Studio, modelos de imagen | Hace hablar a un rostro fijo | Un retrato y un guion | Unos 12 a 14 por 5 s a 720p (Infinite Talk: unos 12 por 2 s) |
| Lipsync Studio, modelos de video | Vuelve a sincronizar la boca en material existente | Un clip y audio nuevo | Unos 2 por 5 s (Kling Lipsync, 720p) |
| Modelos de video con audio nativo | Rostro y voz en una sola pasada | Un prompt y un fotograma inicial | Según el modelo; Seedance 2.0 unos 22 por 5 s a 720p |
| Audio | Texto a voz, cambio de voz, traducción a 18 idiomas | Un guion o un clip | Se muestra en Generate antes de confirmar |
| Clonación de voz, en Audio | Una copia reutilizable de una voz | Una muestra corta en MP3 o WAV, con consentimiento | Se muestra en Generate antes de confirmar |
Desliza hacia los lados para ver las 4 columnas
¿Qué es el lipsync de Higgsfield?
El lipsync de Higgsfield son dos herramientas que funcionan en pareja. Audio crea la voz. Lipsync Studio pone esa voz en un rostro. El artículo de ayuda de Higgsfield lo deja claro: una boca que habla “es Lipsync Studio, dentro de Video”, una voz “es Audio. Son herramientas separadas.”
How do I use lipsync, voiceover, and aspect ratios?
Voice generation, voice change, and translation live in Audio, while making a character talk (lip sync) lives in Lipsync Studio, which offers several models for image-to-video and video-to-video talking clips. Some video models also generate audio together with video in a single pass. Aspect ratio is set per generation inside each tool: common options are 9:16 for vertical, 16:9 for horizontal, and 1:1 for square, and not every model supports every ratio.
Una tercera vía evita la pareja. Algunos modelos de video, entre ellos Seedance 2.5, Seedance 2.0 y Kling 3.0, generan el habla junto con la imagen “en una sola pasada”. El artículo de ayuda explica la diferencia: Lipsync Studio “añade una boca que habla a una imagen o video ya existente, después de hecho”, mientras que el audio nativo da “una alineación física perfecta desde el principio”.
Para un anuncio, Lipsync Studio te deja escribir las palabras exactas, elegir la voz y mantener el mismo rostro. Un modelo con audio nativo crea rostro y voz juntos en una sola toma, con menos control sobre la entrega.
La página de AI Talking Avatar es la puerta de entrada de Higgsfield a las mismas herramientas: un guion o una pista de audio, luego “una foto de retrato o un rostro que generaste en Higgsfield”, y después vista previa y descarga.
Cómo hacer un video hablado, paso a paso
Siete pasos te llevan de una página en blanco a un clip que puedes cortar para un anuncio.
- Abre la guía propia de Higgsfield, How do I use lipsync, voiceover, and aspect ratios?, y tenla a mano. Después abre Lipsync Studio desde el menú Video; el centro de ayuda llama a la herramienta “Create Talking Clips”.
How do I create a lip-synced (talking) video?
Lip sync lives in Lipsync Studio (higgsfield.ai → Video → Lipsync Studio, “Create Talking Clips”). Upload a character image or video, type what the character should say in Audio text (or generate the audio), pick a model, and generate. Each model offers scene templates (General, Selfie, Podcast, Car Talking, and more) to set the look of the clip.
- Escribe primero el guion, a unas dos palabras y media por segundo (la sección siguiente tiene los conteos). Escríbelo como habla una persona, con una indicación entre corchetes como [warm] o [direct] donde cambie el tono.
- Elige el rostro. Para una imagen fija, sube un retrato nítido, bien iluminado y de frente con “una expresión ligera y natural”; el blog de Higgsfield dice que un “rostro neutro de foto de pasaporte” deja al modelo “sin nada desde donde animar”. Para un clip que quieres volver a doblar, usa material estable con la cabeza firme. Un rostro inventado en Soul sirve; el rostro de una persona real requiere su consentimiento.
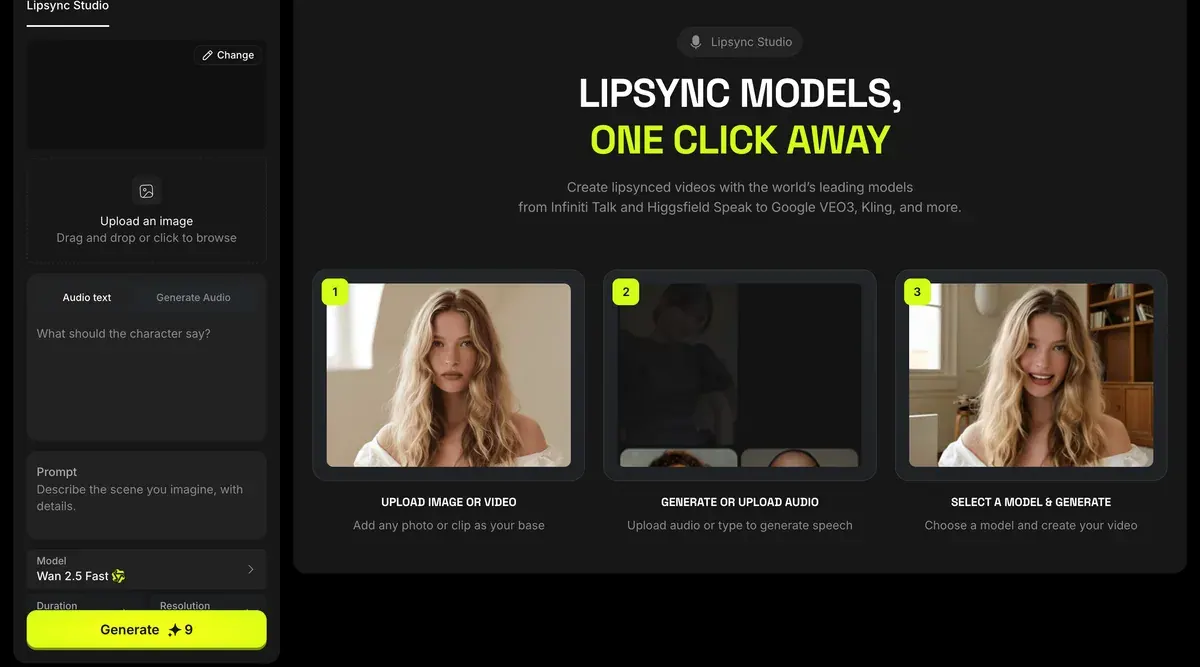
- Crea la voz. Escribe la línea en el cuadro de audio de Lipsync Studio, o arma antes la pista en Audio. Audio ofrece una voz predefinida o un clon de la tuya, ajustada con controles de emoción. El blog de Higgsfield pone el audio primero por una razón: “Una pista de audio plana produce un rostro plano, sin importar qué modelo uses.”
- Elige el modelo y la plantilla de escena. Las plantillas incluyen General, Selfie, Podcast y Car Talking. Fija la proporción antes de confirmar: 9:16 para TikTok, Reels y Shorts. Las proporciones cambian según el modelo, y algunos leen la proporción de tu imagen.
- Genera y luego mira el rostro completo. Revisa los ojos, la cabeza y si la expresión encaja con la voz; la boca suele ser lo que funciona. Cambia una sola cosa por intento, en el orden de Higgsfield: guion, luego imagen, luego modelo.
- Exporta. Para cambiar el formato de un clip terminado, usa Edit y luego Reframe. Para hacer una versión en otro idioma, pasa el clip por Translate en Audio.
What voice and audio tools are available?
Three modes. Text to Speech generates a voice track from text; Voice Change replaces the existing voice in a clip with a different one; Translate translates and re-voices your content in another language (18 languages).
Your own voice. Create custom voice → Add Voice lets you record a sample or upload one (MP3 or WAV), then clones it into a reusable voice you can select for any generation. Only clone a voice that is your own or one you have the person’s permission to use.
Para un recorrido por todas las pestañas de Higgsfield, mira cómo usar Higgsfield.
Qué modelos hacen lipsync y cuánto cuestan
Lipsync Studio tiene seis modelos de imagen y dos de video. Higgsfield Speak 2.0, su motor propio, está solo en Plus y Ultra.
| Modelo | Entrada | Lo que dice Higgsfield | Créditos |
|---|---|---|---|
| Higgsfield Speak 2.0 | Imagen | Velocidad de cola prioritaria | Unos 14 por 5 s a 720p |
| Wan 2.5 Speak | Imagen | De 480p a 1080p, con audio | Unos 12 por 5 s a 720p |
| Infinite Talk | Imagen | Video hablado de larga duración | Unos 12 por 2 s a 720p |
| Kling 2.6 Lipsync | Imagen | Hasta 1080p, con audio | No aparece con ese nombre; la fila Kling Speak de la tabla marca unos 2 por 2 s |
| Kling Avatars 2.0 | Imagen | Avatares hablantes, clips más largos | No aparece con ese nombre |
| Google Veo 3.1 | Imagen | Video hablado cinematográfico | No aparece para Lipsync Studio |
| Kling Lipsync | Video | Sincronización labial sobre material existente | Unos 2 por 5 s a 720p |
| Sync Lipsync 3 | Video | Sincronización labial precisa, hasta 4K | Unos 18 por 2 s a 4K |
Desliza hacia los lados para ver las 4 columnas
Los nombres de los modelos y las notas salen del artículo de ayuda sobre lipsync; los créditos, de la tabla comparativa de la página de precios, leída el 9 de octubre de 2026.
Lipsync Studio models
Image to video. Google Veo 3.1 (cinematic talking video); Kling 2.6 Lipsync (up to 1080p, with audio); Wan 2.5 Speak (480p to 1080p, with audio); Kling Avatars 2.0 (talking avatars, longer clips); Higgsfield Speak 2.0 (priority-queue speed); Infinite Talk (long-form talking video).
Video to video. Kling Lipsync (lip sync on existing footage); Sync Lipsync 3 (precise lip sync, up to 4K).
Tres costos de ejemplo, con esas tarifas:
- Un clip de presentador de 15 segundos en Speak 2.0 a 720p: tres bloques de 5 segundos a unos 14, es decir, unos 42 créditos.
- Volver a doblar un anuncio de 30 segundos que ya corre, en Kling Lipsync: seis bloques a unos 2, es decir, unos 12 créditos. Es la forma más barata de probar un gancho nuevo sobre material que ya funciona.
- Los mismos 15 segundos en Sync Lipsync 3 a 4K: unos 18 créditos cada 2 segundos, es decir, unos 135 créditos.
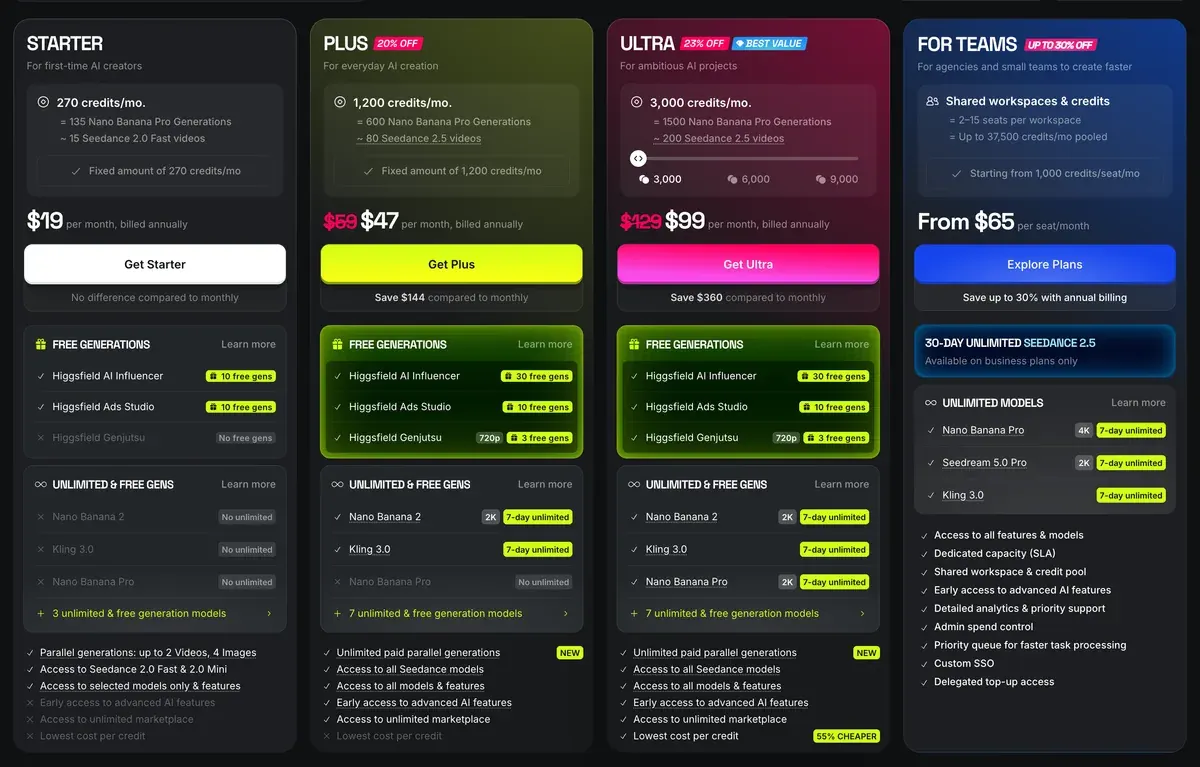
Plus, el plan más barato con Speak, cuesta $49 al mes por 1,000 créditos al mes. A unos 42 créditos por clip, eso cubre unos 23 clips de presentador en Speak 2.0, si nada más gasta los créditos.
Dos reportes de usuarios pesan en la factura. Ocho de 52 fuentes públicas dicen que las generaciones van lentas o fallan y aun así cuestan créditos (Reddit, YouTube). Seis dicen que los créditos caducan al final de cada período (Trustpilot, YouTube). Todos los planes y sus créditos: precios de Higgsfield.
Cómo escribir un guion que sincronice bien
Un guion de lip sync se escribe para el oído, así que su longitud se mide en segundos. El inglés estadounidense conversacional va a unas 150 palabras por minuto, una cifra que VirtualSpeech atribuye al National Center for Voice and Speech. Son dos palabras y media por segundo.
| Duración del clip | Palabras, como máximo | Encaja |
|---|---|---|
| 5 s | 12 | Una línea de gancho |
| 8 s | 20 | Un gancho y una razón |
| 15 s | 37 | Gancho, producto, llamada a la acción |
| 30 s | 75 | Un anuncio corto completo, mejor cortado en dos clips |
Desliza hacia los lados para ver las 3 columnas
Quédate unas palabras por debajo del presupuesto. Las pausas y las indicaciones entre corchetes también llevan tiempo, y una línea apresurada es donde se desajustan las bocas.
Cinco reglas marcan la diferencia en Higgsfield:
- Una idea por línea. Cada frase tiene su propia respiración, así que el rostro se reinicia entre ellas.
- Escríbelo como lo dirías. El blog de Higgsfield contrapone “Nos complace anunciar la última actualización de nuestro producto” a “Hoy quiero enseñarte algo en lo que llevamos un tiempo trabajando.”
- Marca el tono entre corchetes donde cambie: [warm], [calm], [direct]. Higgsfield dice que los modelos basados en la interpretación “los usan para variar los parámetros de animación facial”.
- Escribe los números como se dicen (“veinte por ciento”) y las marcas como suenan. Una voz adivina mal los símbolos.
- Mantén un solo hablante. Higgsfield incluye el diálogo superpuesto entre sus límites; haz de cada hablante un clip aparte.
Step-by-step: how to improve AI lipsync quality
Write for spoken delivery, not for reading. Formal writing produces robotic delivery. Conversational language produces more natural facial animation because the model has more expressive cues to work from. Add emotion cues in brackets where the tone should shift: [excited], [calm], [direct].
Generate expressive audio first. Voice is the input that drives facial animation. Monotone delivery reduces the range of facial motion the model generates. A flat audio track produces a flat face regardless of which model you use.
Un guion de presentador de 15 segundos, con 28 palabras habladas, para un teléfono apoyado en una repisa de baño:
[warm] Morning routine, one step.
[direct] Two drops of this serum, pat it in, done.
[light] No layering three bottles.
[calm] It's in the link below, if your shelf is full too.
La presentadora muestra el producto y lee la afirmación de la marca. Nunca dice que lo usa desde hace meses: viniendo de un rostro de IA, eso es un testimonio falso (UGC con IA y la ley). Más formas de guion según el formato de anuncio: plantilla de guion UGC.
Cuando la boca se desajusta: soluciones habituales
El blog de Higgsfield dice que la precisión del lip sync es “un problema en gran parte resuelto en 2026”. Lo que notan los espectadores es todo menos la boca: un rostro congelado, ojos que miran fijo, un asentimiento en bucle, un rostro que cambia entre clips.
How to make an AI Talking Video Feel Real?
A believable LipSync video coordinates six elements simultaneously: lip movement aligned to speech phonemes; facial expressions that shift with emotional content; eye movement; subtle head motion that follows speech rhythm; gestures that match meaning; voice delivery with pacing, pauses, and tonal variation.
Frozen facial expressions. The cause is usually a source image with a neutral, flat expression. Use an image where the subject has a light, natural expression, not a passport-photo neutral face. Adding emotion cues to the script also helps: words like [excited], [thoughtful], or [warm] in brackets give performance-based models a signal to animate from.
| Lo que ves | Por qué | Solución |
|---|---|---|
| Solo se mueve la boca | Una foto de origen plana y neutra | Un retrato con una expresión ligera; indicaciones entre corchetes |
| Voz animada, rostro en blanco | Voz y rostro hechos en pasadas separadas | Ajusta la energía de la voz al rostro, o usa un modelo con audio nativo |
| Mirada fija, parpadeos regulares | Poco movimiento de ojos en el modelo | Clips de menos de 20 segundos |
| El mismo asentimiento cada 8 a 10 s | Una biblioteca de movimientos pequeña en un clip largo | Clips de menos de 30 segundos, unidos con cortes |
| Un rostro nuevo en cada clip | Sin bloqueo de identidad | Entrena un Soul ID una vez y reutilízalo |
| Labios desfasados con la cabeza girada | Ángulo lateral o rostro cubierto | Material de origen de frente, sin gafas ni pelo sobre la boca |
| Acento equivocado | Voz por defecto para el guion | Elige una voz en el idioma de destino; Qwen Audio 3.0 TTS acepta el dialecto en palabras sencillas |
| Dos personas hablando a la vez | Diálogo superpuesto | Un hablante por clip, unidos en la edición |
Desliza hacia los lados para ver las 3 columnas
Las soluciones de las primeras cinco filas son del propio Higgsfield, tomadas de su publicación de blog sobre lipsync. Las filas de ángulo lateral y de varios hablantes salen de los límites de esa misma publicación; la fila del acento, de la página de voz en off.
How do you fix the most common problems?
Repetitive gestures. Limited motion libraries produce the same head nod or shoulder movement every 8-10 seconds. The fix is clip length: keep individual generations under 30 seconds and cut between them.
Character drift. The same person looking different across multiple clips is a persistent identity problem, not a LipSync problem. The fix is to use a trained identity layer rather than re-uploading the same photo each time.
Cuando una toma está casi lograda, cambia una sola entrada y vuelve a ejecutarla. Si cambias varias a la vez, no sabes cuál lo arregló.
Videos hablados en anuncios
Tres formatos de anuncio se apoyan en el lip sync, y cada uno usa una parte distinta de Higgsfield.
El primero es el UGC de cabeza parlante: un creador sosteniendo tu producto y hablando a su teléfono. Crea el rostro una vez en Soul, fíjalo con Soul ID y luego hazlo hablar en Lipsync Studio o Seedance. El método completo, con prompts: personajes UGC con IA realistas en Higgsfield. Para un creador virtual recurrente, mira la guía de AI Influencer.
El segundo es el explicativo de producto: un presentador que recorre lo que hace el producto. La página de talking avatar de Higgsfield dice que Marketing Studio “suma 100+ avatares listos” para anuncios de producto, lo que ahorra el casting (guía de Marketing Studio). Cinema Studio crea “escenas cinematográficas de avatares hablantes de hasta 30 segundos, con referencias de imagen, video y audio para rostro, producto y estilo.”
El tercero es la versión traducida de un anuncio que ya vende. Translate en Audio vuelve a doblar un clip en 18 idiomas. En la página de clonación de voz, la herramienta de localización de Supercomputer traduce el habla “al inglés, español o francés” conservando la voz del hablante. Después Kling Lipsync vuelve a sincronizar la boca, a la tarifa más baja del estudio.
Cinco de 52 fuentes públicas atribuyen a Soul ID, Elements y las hojas de referencia que un personaje se mantenga igual entre tomas (YouTube, Reddit). Esa coherencia es lo que permite que un solo presentador lleve toda una campaña.
Dos reglas valen para todos los formatos. La primera es el consentimiento para cualquier rostro o voz real. La sección 5.3 de las condiciones de Higgsfield te obliga a garantizar “todos los consentimientos, autorizaciones y permisos exigidos por la ley aplicable de cada persona cuyo rostro o voz se incluya”.
La segunda es la honestidad sobre el presentador. La sección 5.2(xi) prohíbe presentar “que cualquier resultado ha sido generado por un humano cuando no lo es”. Etiquetas de las plataformas: etiqueta de IA de TikTok y divulgación de IA de Meta.
Cambiar un rostro en lugar de una voz es otra herramienta: face swap y Recast de Higgsfield. Todas las páginas de Higgsfield están en el hub de Higgsfield, y los planes y condiciones en el perfil de Higgsfield.
Preguntas sobre el lip sync en Higgsfield
¿Puede Higgsfield sincronizar los labios de mi propio video?
Sí. Los dos modelos de video de Lipsync Studio vuelven a sincronizar la boca en el material que subes. Kling Lipsync cuesta unos 2 créditos por 5 segundos a 720p; Sync Lipsync 3 llega hasta 4K. El blog de Higgsfield pide “material estable con un rostro claro y despejado y una posición de cabeza constante”.
¿Puedo usar mi propia voz?
Sí. En Audio, elige Create custom voice y graba o sube una muestra corta en MP3 o WAV. La regla de Higgsfield: “Clona solo tu propia voz o una que tengas permiso para usar.” La página de clonación añade un paso de consentimiento antes de crear el clon.
¿Cuánto puede durar un video hablado de Higgsfield?
El artículo de ayuda de lipsync no fija un máximo para Lipsync Studio; Infinite Talk es el modelo que lista para video hablado de larga duración. Las escenas habladas de Cinema Studio duran hasta 30 segundos. El consejo del propio Higgsfield es mantener cada generación por debajo de 30 segundos y cortar entre clips.
¿Debo usar Lipsync Studio o Seedance?
Usa Lipsync Studio cuando necesites controlar las palabras exactas y la voz, como en un anuncio con presentador y guion. Usa Seedance cuando importe más una sola toma: crea voz e imagen juntas. Seedance en Higgsfield, a fondo: guía de Seedance.
Todas las guías de Higgsfield, ordenadas por tarea, están en el centro de Higgsfield
Fuentes
- Centro de ayuda de Higgsfield: How do I use lipsync, voiceover, and aspect ratios?, los ocho modelos de Lipsync Studio por entrada, plantillas de escena, los tres modos de Audio, clonación de voz con permiso, traducción a 18 idiomas, seis proporciones, Reframe; con fecha del 1 de agosto de 2026. Revisado
- Blog de Higgsfield: How to make realistic AI talking and LipSync videos in 2026, seis elementos de un video hablado creíble, cinco problemas comunes y sus soluciones, un flujo de seis pasos y los límites; 7 de julio de 2026. Revisado
- Higgsfield: AI Talking Avatar, guion o audio más un retrato; escenas habladas de Cinema Studio de hasta 30 segundos; doblaje a 18 idiomas; Reframe a 9:16, 1:1 o 16:9 y escalado a 4K. Revisado
- Higgsfield: AI Voice Over, motores de voz, hasta 10,000 caracteres por ejecución y diálogo con hasta 10 hablantes en Eleven v4, Qwen Audio 3.0 TTS en 13 idiomas, exportación en MP3, WAV u OGG. Revisado
- Higgsfield: AI Voice Cloning, muestra corta, un paso de consentimiento, la herramienta de localización de Supercomputer para inglés, español o francés con la voz del propio hablante. Revisado
- Higgsfield: Higgsfield pricing, tabla comparativa leída en un navegador: tarifas de crédito de Lipsync Studio y la fila de Higgsfield Speak por plan el 9 de octubre de 2026; precios y créditos de los planes el 19 de octubre de 2026. Revisado
- Higgsfield: Condiciones de uso de Higgsfield (26 de julio de 2026), 5.3 sobre el consentimiento para cada rostro y voz subidos, 5.2(xi) sobre resultados presentados como generados por humanos. Revisado
- VirtualSpeech: Average speaking rate and words per minute, unas 150 palabras por minuto para la conversación en inglés estadounidense, atribuidas al National Center for Voice and Speech; 20 de agosto de 2026. Revisado
- Trustpilot, Reddit y YouTube: Reseñas de usuarios de Higgsfield, 52 fuentes públicas sintetizadas, revisadas el 28 de septiembre de 2026. Revisado el
Qué cambió en esta página
- Los precios de Higgsfield retrocedieron: Starter cuesta 15 dólares al mes por 200 créditos, Plus 49 al mes o 39 con facturación anual por 1,000 créditos, y Ultra 129 o 99 con facturación anual vuelve a tener tarjeta (antes Starter 19 por 270, Plus 59 o 47 por 1,200).

Alexandre S.
Alexandre S. es estratega creativo de anuncios y redactor publicitario, con diez años de experiencia en marketing digital en múltiples canales.
Páginas relacionadas
-
 Guía Plantilla de guion UGC para anuncios
Plantilla de guion UGC para copiar, 20 ganchos por tipo y ejemplos para 15, 30 y 45 s, con creadores o actores de IA. Revisado 15 oct 2026.
-
 Lista de las mejores Voz en off con IA para anuncios
El plan gratuito de ElevenLabs no permite anuncios; los anuncios de pago empiezan en su plan Starter de $6. Qué plan permite anuncios en diez herramientas de voz y video, revisado el 2 de octubre de 2026.
-
 Guía Seedance 2.0 en Higgsfield
Cuánto cuesta Seedance 2.0 en Higgsfield, cuándo es ilimitado, sus límites por clip y su precio frente a Dreamina y otras tiendas. Revisado 16 oct 2026.
-
 Guía Higgsfield Marketing Studio
Higgsfield Marketing Studio convierte un enlace de producto en videos UGC, tomas y anuncios de imagen. Pasos, créditos por clip y reglas, 18 oct 2026.


