Precios de GPU en la nube para imágenes y video con IA
Una GPU en la nube es una tarjeta gráfica en el centro de datos de otra persona que alquilas por horas para ejecutar modelos de IA. La VRAM, la memoria propia de la tarjeta, decide qué modelos caben.
De ocho nubes de GPU leídas el 24 de octubre de 2026, Community Cloud de Runpod lista la tarifa más baja para una RTX 4090, a $0.34 la hora. Su H100 PCIe, a $1.99, es la más baja por un centavo.
Los anfitriones verificados más baratos de Vast.ai quedan por debajo de todos los precios de lista en la 5090, la L40S, la A100 y la RTX PRO 6000. Su RTX PRO 6000 cuesta $1.08 frente a los $1.69 de Runpod. Las cifras de Vast.ai cuentan solo sus anfitriones verificados.
En nuestra propia cuenta de Runpod, el 17 de octubre de 2026, una imagen de FLUX 3 Klein de 1280 x 1280 tardó unos 28.5 segundos en una RTX 4090 de Secure Cloud. Con la tarifa de ese nivel cuesta $0.007 de tiempo de GPU por imagen.
| Proveedor y nivel | RTX 4090 (24 GB) | RTX 5090 (32 GB) | L40S (48 GB) | A100 (80 GB) | H100 (80 GB) | RTX PRO 6000 (96 GB) |
|---|---|---|---|---|---|---|
| Runpod Community Cloud Precio de lista; A100 SXM, H100 PCIe | $0.34 | $0.69 | $0.79 | $1.39 | $1.99 | $1.69 |
| Runpod Secure Cloud Precio de lista; A100 SXM, H100 PCIe | $0.89 | $1.19 | $1.09 | $1.79 | $2.89 | $2.49 |
| Runpod Serverless Worker flex, funciona solo con una petición | $1.10 | $1.58 | $1.75 | $2.72 | $4.79 | $3.49 |
| Vast.ai, la más baja verificada Marketplace; H100 PCIe, RTX PRO 6000 WS | $0.41 | $0.64 | $0.74 | $1.07 | $2.00 | $1.08 |
| Vast.ai, mediana verificada Marketplace; la oferta de en medio | $0.67 | $1.03 | $0.80 | $1.12 | $2.33 | $1.83 |
| TensorDock Precio habitual, varía según el anfitrión; A100 PCIe, H100 SXM5 | $0.35 | No aparece | No aparece | $1.50 | $2.25 | No aparece |
| Massed Compute Precio de lista; H100 80 GB | No aparece | No aparece | $0.97 | $1.35 | $2.73 | $2.19 |
| Modal Tarifa por segundo por 3,600; H100 SXM5 | No aparece | No aparece | $1.95 | $2.50 | $3.95 | $3.03 |
| Lambda Precio de lista; H100 PCIe | No aparece | No aparece | No aparece | No aparece | $3.29 | No aparece |
| DigitalOcean GPU Droplets Precio de lista; HGX H100 | No aparece | No aparece | $1.57 | No aparece | $4.41 | No aparece |
| Paperspace Precio promocional bajo demanda | No aparece | No aparece | No aparece | No aparece | $5.95 | No aparece |
Desliza hacia los lados para ver las 7 columnas
Por qué la misma H100 cuesta el triple según la nube
La diferencia viene de quién es el dueño de la máquina y de cuánto tiempo te comprometes. Una H100 va de $1.99 la hora en Community Cloud de Runpod a $5.95 en Paperspace bajo demanda.
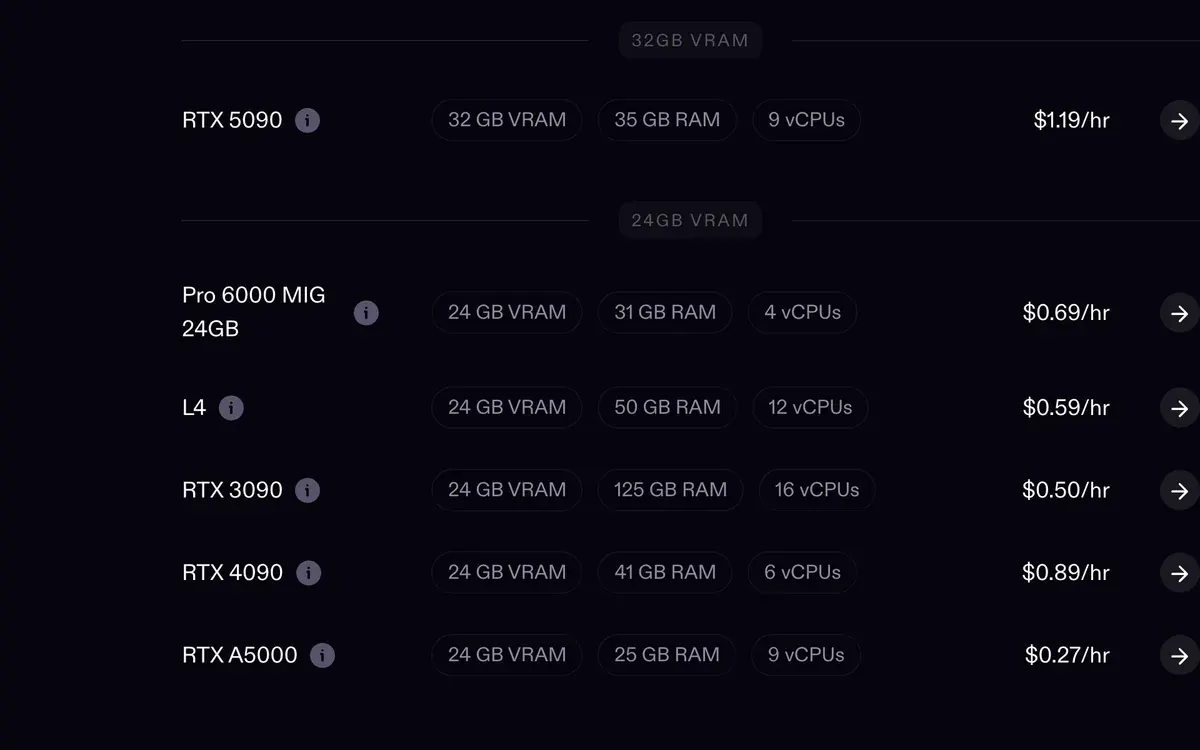
Community Cloud de Runpod y Vast.ai alquilan máquinas de anfitriones externos. La documentación de Choose a Pod de Runpod califica la fiabilidad de Community Cloud como «variable», y Runpod ya no acepta nuevos anfitriones de Community.

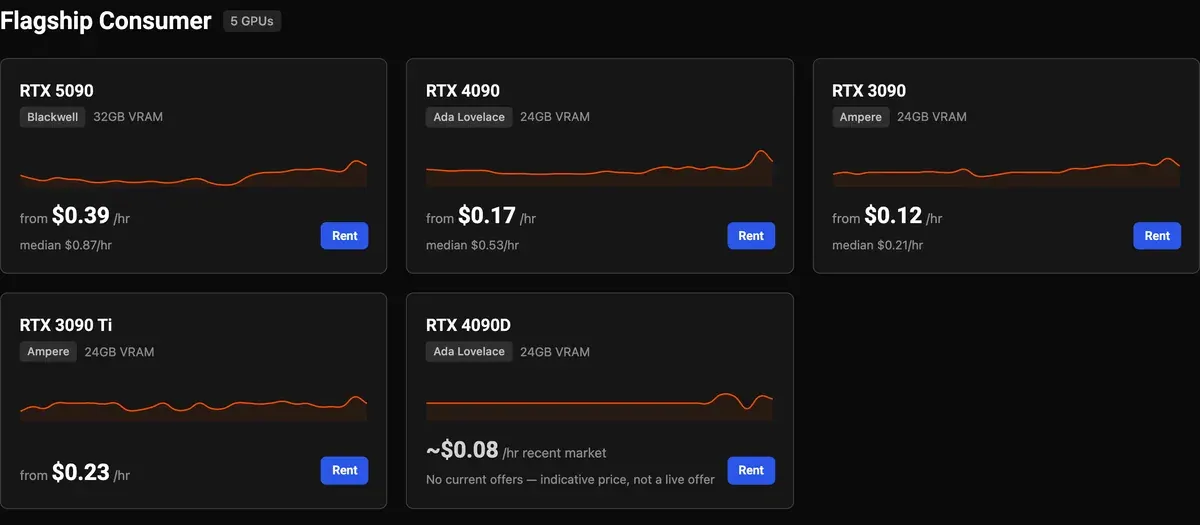
Los anfitriones de Vast.ai fijan sus propios precios: sus 39 ofertas verificadas de RTX 4090 iban de $0.41 a un precio medio de $0.67.
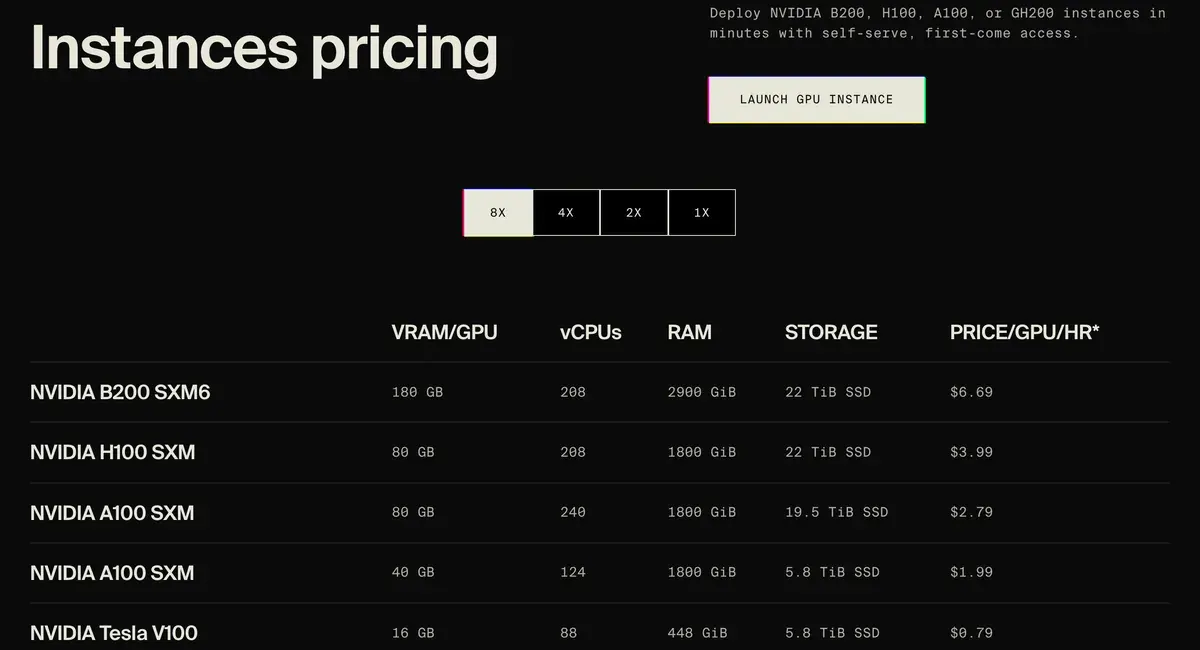
El compromiso es la segunda palanca. Paperspace muestra una A100 a $1.15 la hora, y solo con un plazo de tres años. Lambda fija el precio de su A100 SXM de 80 GB solo en máquinas de ocho tarjetas, a $2.79 por tarjeta.
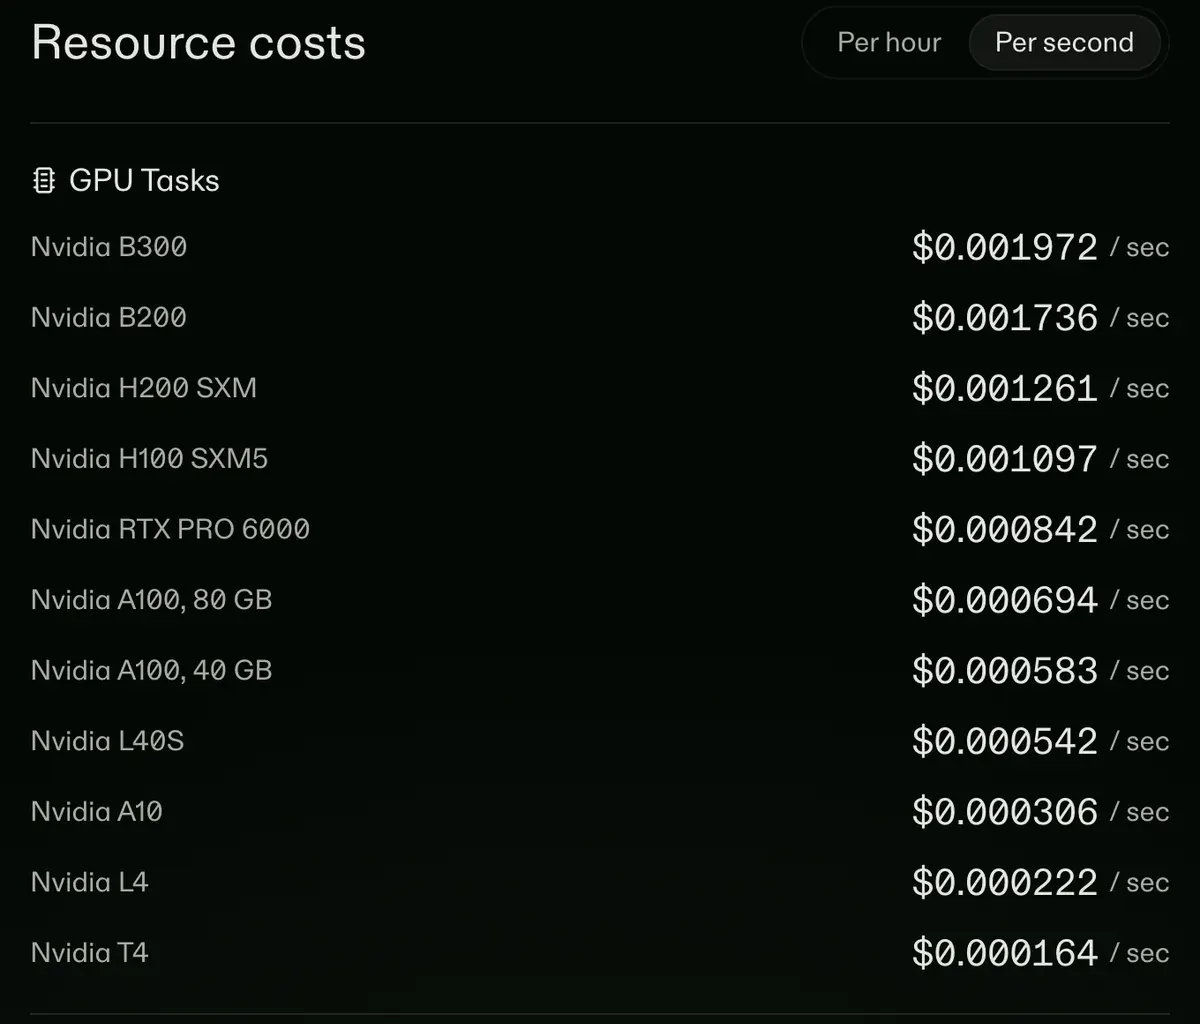
Serverless cuesta más por hora y menos al mes cuando las peticiones son raras. El worker flex de Runpod factura desde que arranca hasta que se detiene del todo y escala a cero entre trabajos (precios de Runpod). Modal factura cada segundo que corre una función, sin cargo entre peticiones: su tarifa de H100 de $0.0011 el segundo son $3.95 la hora (precios de Modal).
Cuánto cuesta una imagen o un clip
El precio por hora dice poco hasta que sabes lo rápido que trabaja la tarjeta. La cifra útil es el costo por resultado: el precio por hora dividido entre los resultados que terminas en una hora.
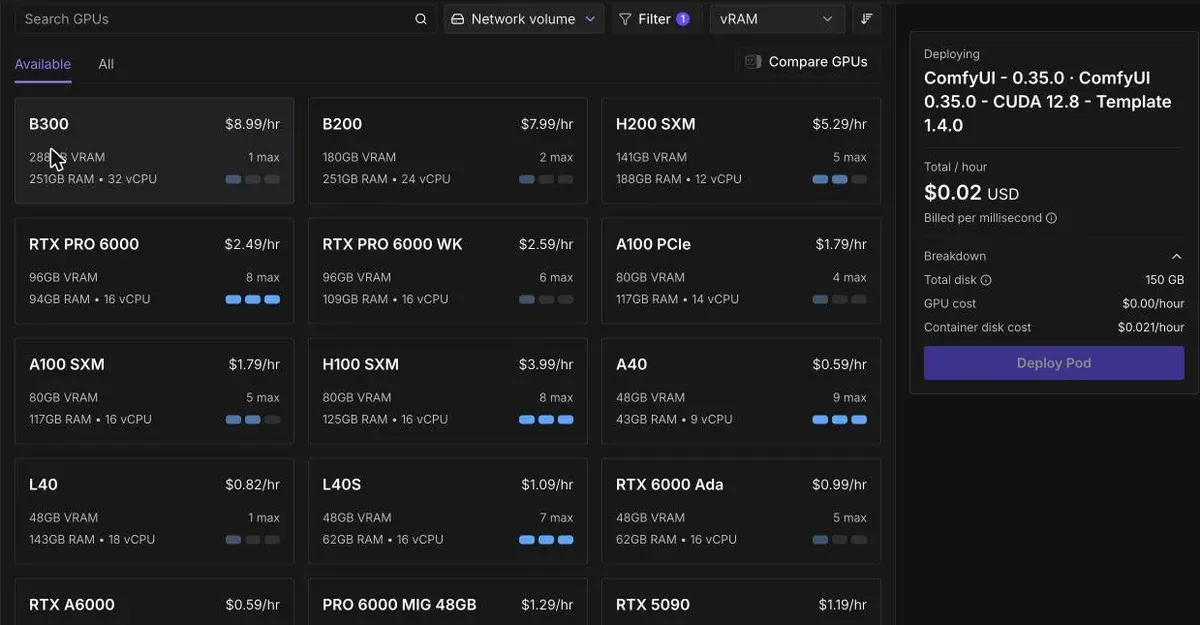
En nuestra propia cuenta de Runpod, el 17 de octubre de 2026, una RTX 4090 de Secure Cloud hizo 12 imágenes de FLUX 3 Klein en 342 segundos. Cada una era de 1280 x 1280 con 16 pasos, unos 28.5 segundos por imagen.
La tabla de abajo aplica ese tiempo a cada tarifa de 4090. Todas las filas suponen los 28.5 segundos medidos en Secure Cloud.
| Dónde funciona la 4090 | Por hora | Por 100 imágenes |
|---|---|---|
| Runpod Community Cloud | $0.34 | $0.27 |
| TensorDock, precio habitual | $0.35 | $0.28 |
| Vast.ai, la más baja verificada | $0.41 | $0.32 |
| Runpod Secure Cloud, medido | $0.89 | $0.70 |
| Runpod Serverless | $1.10 | $0.87 |
Desliza hacia los lados para ver las 3 columnas
Los ajustes cambian la factura más que la nube. El modelo completo FLUX 3 Klein con 50 pasos tardó unos 4 minutos por imagen en el mismo Pod, $0.06 cada una.
Estas cifras son solo tiempo de GPU. El arranque del Pod, la carga del modelo y el almacenamiento se suman. Nuestro desglose de precios de Runpod los suma.
Para video, mide un clip en tu propio Pod y divide. El Wan 2.2 alojado de Runpod hace un clip de 720p y 5 segundos por $0.30 (precios de Runpod). Una 5090 alquilada a $1.19 lo supera solo si cada clip tarda menos de 15 minutos (1.19 dividido entre 0.30 son 3.97 clips por hora).
Qué GPU para qué tarea
La VRAM es el primer filtro. Un modelo que no cabe pasa a la memoria principal del equipo (descarga a CPU), lo que funciona pero va más lento.
| Tarea | VRAM que necesita | Tarjetas que caben |
|---|---|---|
| Imágenes fijas de anuncios con FLUX o modelos de imagen similares | Modelos de 6 a 17 GB, en nuestra propia cuenta de Runpod | RTX 4090 o 5090 |
| Video de Wan 2.2 5B | Cabe en 8 GB con la descarga a CPU de ComfyUI, según la documentación de ComfyUI | Cualquier tarjeta de la tabla; la RTX 4090 es la más barata |
| Grandes modelos de video cercanos a 40 GB | Más de los 32 GB de una 5090, en nuestra propia cuenta de Runpod | L40S, A100 o RTX PRO 6000 |
Desliza hacia los lados para ver las 3 columnas
Un modelo de video de unos 40 GB desborda una 5090 y descarga a CPU. En nuestra propia cuenta, ese desborde es la razón por la que una tarjeta de 96 GB puede costar menos por clip a pesar de su mayor precio por hora. La ficha del modelo de Wan 2.2 dice que su versión de 5B «también puede ejecutarse en tarjetas gráficas de consumo como la 4090» (Hugging Face).
Las configuraciones paso a paso están en Wan 2.2 en Runpod con ComfyUI y ComfyUI en Runpod. Nuestro hub de Runpod reúne el resto.
La licencia del modelo acompaña a cada alquiler
La nube alquila hardware; la licencia del modelo decide si su resultado puede usarse en un anuncio. Wan 2.2 es Apache 2.0. LTX-2 necesita una licencia de pago cuando una empresa gana $10,000,000 al año o más (licencia, sección 2.1).
La licencia de MiniMax H3 excluye EE. UU., la UE, el Reino Unido y Corea del Sur, así que sus clips no pueden usarse como anuncios allí, sea cual sea la GPU que los hizo. Los anfitriones más baratos para el mismo trabajo se comparan en alternativas a Runpod.
Cómo se construye la tabla
Un precio entra en la tabla cuando la página o la API del propio proveedor lo muestra, para una tarjeta bajo demanda, leído el 24 de octubre de 2026. «No indicado» significa que esa página no muestra un precio bajo demanda de una sola tarjeta para esa GPU.
Los precios de Vast.ai salen de su búsqueda pública de ofertas: ofertas verificadas, alquilables, de una sola GPU, bajo demanda, ordenadas por precio total por hora con el disco por defecto. Modal publica tarifas por segundo; la tabla las multiplica por 3,600. La página de TensorDock da un precio habitual que varía según el anfitrión y dice que se actualizó por última vez el 24 de julio de 2024.
Cada fila conserva un ancla, así que un enlace como /data/cloud-gpu-prices/#runpod-community se mantiene estable. Las correcciones aparecen en la lista de cambios de esta página y en actualizaciones y correcciones.
Cómo citar estos datos
adtestbench, "Precios de GPU en la nube para imágenes y video con IA", https://adtestbench.com/data/cloud-gpu-prices/, actualizado el .
- Archivo CSV /data/cloud-gpu-prices.csv
Fuentes
- Runpod: Precios de Runpod, tarifas de Secure Cloud, Community Cloud y Serverless; la API de tipos de GPU de nuestra propia cuenta dio las mismas cifras. Revisado
- Vast.ai: API de búsqueda de ofertas de Vast.ai, ofertas verificadas, alquilables, de una sola GPU, bajo demanda; el precio total por hora incluye el disco por defecto. Revisado
- Vast.ai: Precios de Vast.ai, precios fijados por los anfitriones. Revisado
- Lambda: Precios de la nube de GPU de Lambda, precio por GPU y hora, facturación por minuto, más impuestos sobre ventas o IVA. Revisado
- Modal: Precios de Modal, tarifas de GPU por segundo. Revisado
- TensorDock: GPU en la nube de TensorDock, precio habitual por hora, varía según el anfitrión, facturación por segundo; página actualizada por última vez el 24 de julio de 2024. Revisado
- Massed Compute: Precios de Massed Compute. Revisado
- DigitalOcean: Precios de DigitalOcean GPU Droplets, facturación por segundo, mínimo de 5 minutos. Revisado
- Paperspace (DigitalOcean): Precios de Paperspace, H100 bajo demanda con precio promocional; la tarifa de A100 se muestra solo con un compromiso de tres años. Revisado
- Documentación de ComfyUI: Wan2.2 en ComfyUI, el modelo de 5B y la descarga nativa a CPU. Revisado
- Documentación de Runpod: Choose a Pod, fiabilidad de Community Cloud: variable; sin nuevos anfitriones de Community. Revisado
- Wan-AI en Hugging Face: Ficha del modelo Wan2.2 TI2V-5B, Apache 2.0; funciona en tarjetas de consumo como la 4090. Revisado
- Lightricks en GitHub: LTX-2 Community License Agreement, sección 2.1. Revisado

Alexandre S.
Alexandre S. es estratega creativo de anuncios y redactor publicitario, con diez años de experiencia en marketing digital en múltiples canales.
Páginas relacionadas
-
 Datos Rastreador de precios de herramientas de anuncios con IA
69 de 82 herramientas de anuncios con IA muestran un precio de lista leído en la propia página del proveedor, revisado por última vez el 16 de octubre de 2026, con el costo por clip o imagen cuando una tarifa lo permite.
-
 Guía Flujo de trabajo de ComfyUI para un influencer IA
Los bloques de ComfyUI detrás de un influencer IA, la licencia de cada modelo abierto, dónde encontrar flujos de trabajo y el costo por imagen en una GPU alquilada. Revisado el 24 oct 2026.
-
 Precios Precios de Higgsfield
Higgsfield desde $15 al mes por 200 créditos, unos $0.075 cada uno. Qué cubre Unlimited, plan gratuito, prueba y reembolsos. Revisado 21 oct 2026.


