Prix des GPU cloud pour images et vidéos IA
Un GPU cloud est une carte graphique dans le data center de quelqu'un d'autre, que vous louez à l'heure pour faire tourner des modèles d'IA. La VRAM, la mémoire propre à la carte, décide des modèles qui y tiennent.
Sur huit clouds GPU relevés le 24 octobre 2026, le Community Cloud de Runpod affiche le tarif le plus bas pour une RTX 4090, à 0,34 $ de l'heure. Son H100 PCIe, à 1,99 $, est le moins cher, avec un centime d'écart.
Les hébergeurs vérifiés les moins chers de Vast.ai passent sous tous les tarifs publics sur la 5090, la L40S, la A100 et la RTX PRO 6000. Sa RTX PRO 6000 est à 1,08 $ contre 1,69 $ chez Runpod. Les chiffres de Vast.ai ne comptent que ses hébergeurs vérifiés.
Sur notre propre compte Runpod le 17 octobre 2026, une image FLUX 3 Klein de 1280 x 1280 a pris environ 28.5 secondes sur une RTX 4090 Secure Cloud. Au tarif de cette offre, cela coûte 0,007 $ de temps GPU par image.
| Fournisseur et offre | RTX 4090 (24 Go) | RTX 5090 (32 Go) | L40S (48 Go) | A100 (80 Go) | H100 (80 Go) | RTX PRO 6000 (96 Go) |
|---|---|---|---|---|---|---|
| Runpod Community Cloud Tarif public ; A100 SXM, H100 PCIe | 0,34 $ | 0,69 $ | 0,79 $ | 1,39 $ | 1,99 $ | 1,69 $ |
| Runpod Secure Cloud Tarif public ; A100 SXM, H100 PCIe | 0,89 $ | 1,19 $ | 1,09 $ | 1,79 $ | 2,89 $ | 2,49 $ |
| Runpod Serverless Worker flex, ne tourne que sur requête | 1,10 $ | 1,58 $ | 1,75 $ | 2,72 $ | 4,79 $ | 3,49 $ |
| Vast.ai, le moins cher vérifié Marketplace ; H100 PCIe, RTX PRO 6000 WS | 0,41 $ | 0,64 $ | 0,74 $ | 1,07 $ | 2,00 $ | 1,08 $ |
| Vast.ai, médiane vérifiée Marketplace ; l'offre du milieu | 0,67 $ | 1,03 $ | 0,80 $ | 1,12 $ | 2,33 $ | 1,83 $ |
| TensorDock Prix habituel, variable selon l'hébergeur ; A100 PCIe, H100 SXM5 | 0,35 $ | Non cité | Non cité | 1,50 $ | 2,25 $ | Non cité |
| Massed Compute Tarif public ; H100 80 Go | Non cité | Non cité | 0,97 $ | 1,35 $ | 2,73 $ | 2,19 $ |
| Modal Tarif à la seconde multiplié par 3 600 ; H100 SXM5 | Non cité | Non cité | 1,95 $ | 2,50 $ | 3,95 $ | 3,03 $ |
| Lambda Tarif public ; H100 PCIe | Non cité | Non cité | Non cité | Non cité | 3,29 $ | Non cité |
| DigitalOcean GPU Droplets Tarif public ; HGX H100 | Non cité | Non cité | 1,57 $ | Non cité | 4,41 $ | Non cité |
| Paperspace Prix promo à la demande | Non cité | Non cité | Non cité | Non cité | 5,95 $ | Non cité |
Faites défiler sur le côté pour voir les 7 colonnes
Pourquoi le même H100 coûte trois fois plus cher selon les clouds
L'écart vient de qui possède la machine et de la durée d'engagement. Un H100 va de 1,99 $ de l'heure sur le Community Cloud de Runpod à 5,95 $ sur Paperspace à la demande.
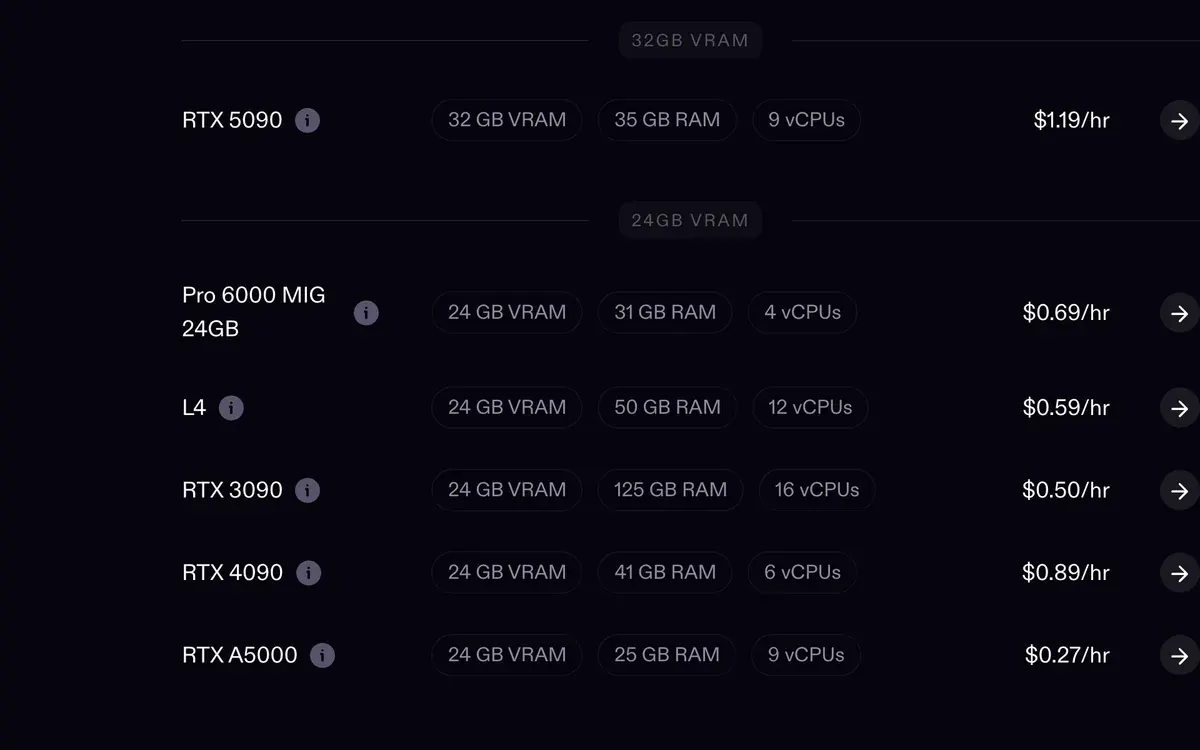
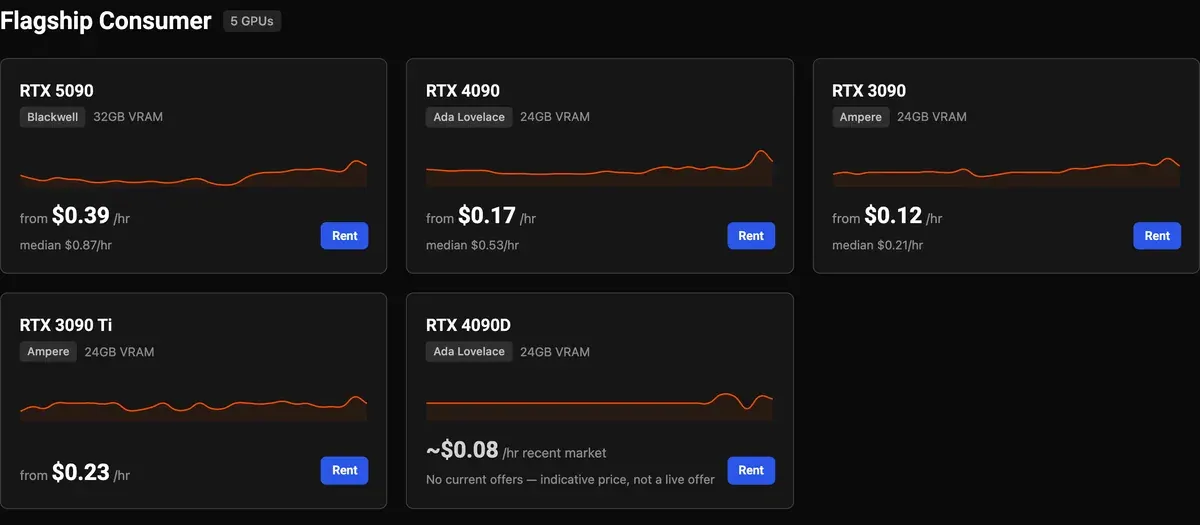
Le Community Cloud de Runpod et Vast.ai louent des machines détenues par des hébergeurs tiers. Les docs Choose a Pod de Runpod qualifient la fiabilité de Community Cloud de « variable », et Runpod n'accepte plus de nouveaux hébergeurs Community.

Les hébergeurs de Vast.ai fixent leurs propres prix : ses 39 offres RTX 4090 vérifiées allaient de 0,41 $ à un prix médian de 0,67 $.
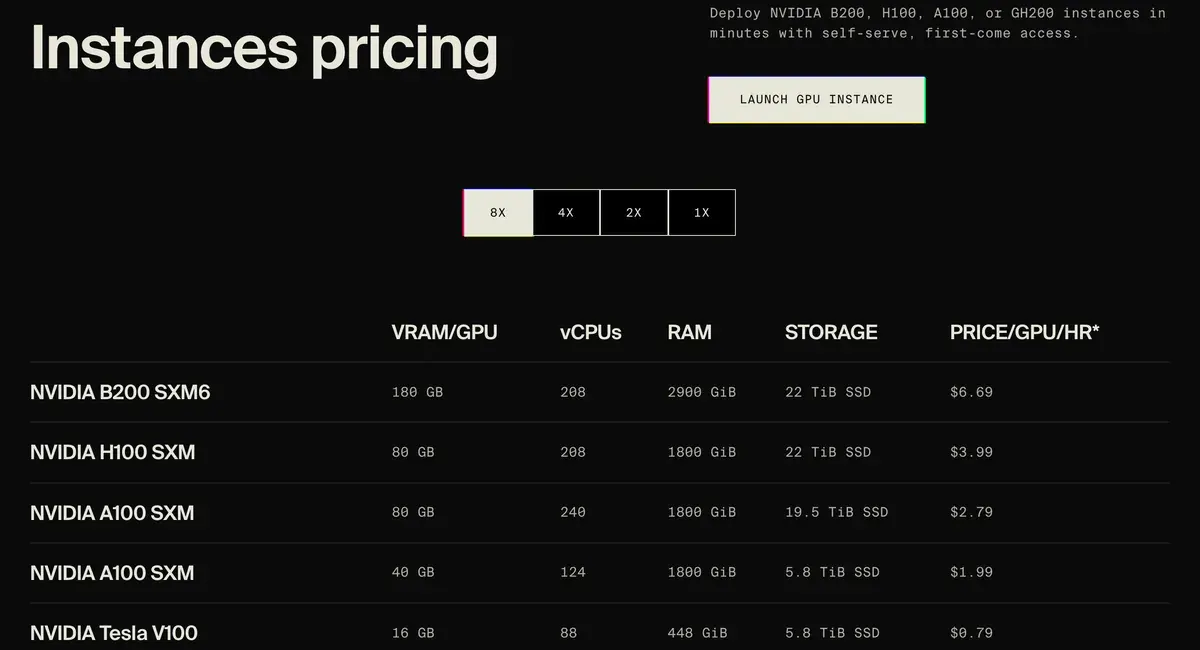
L'engagement est le deuxième levier. Paperspace affiche une A100 à 1,15 $ de l'heure, et seulement sur trois ans. Lambda ne tarife sa A100 SXM de 80 Go que dans des machines de huit cartes, à 2,79 $ par carte.
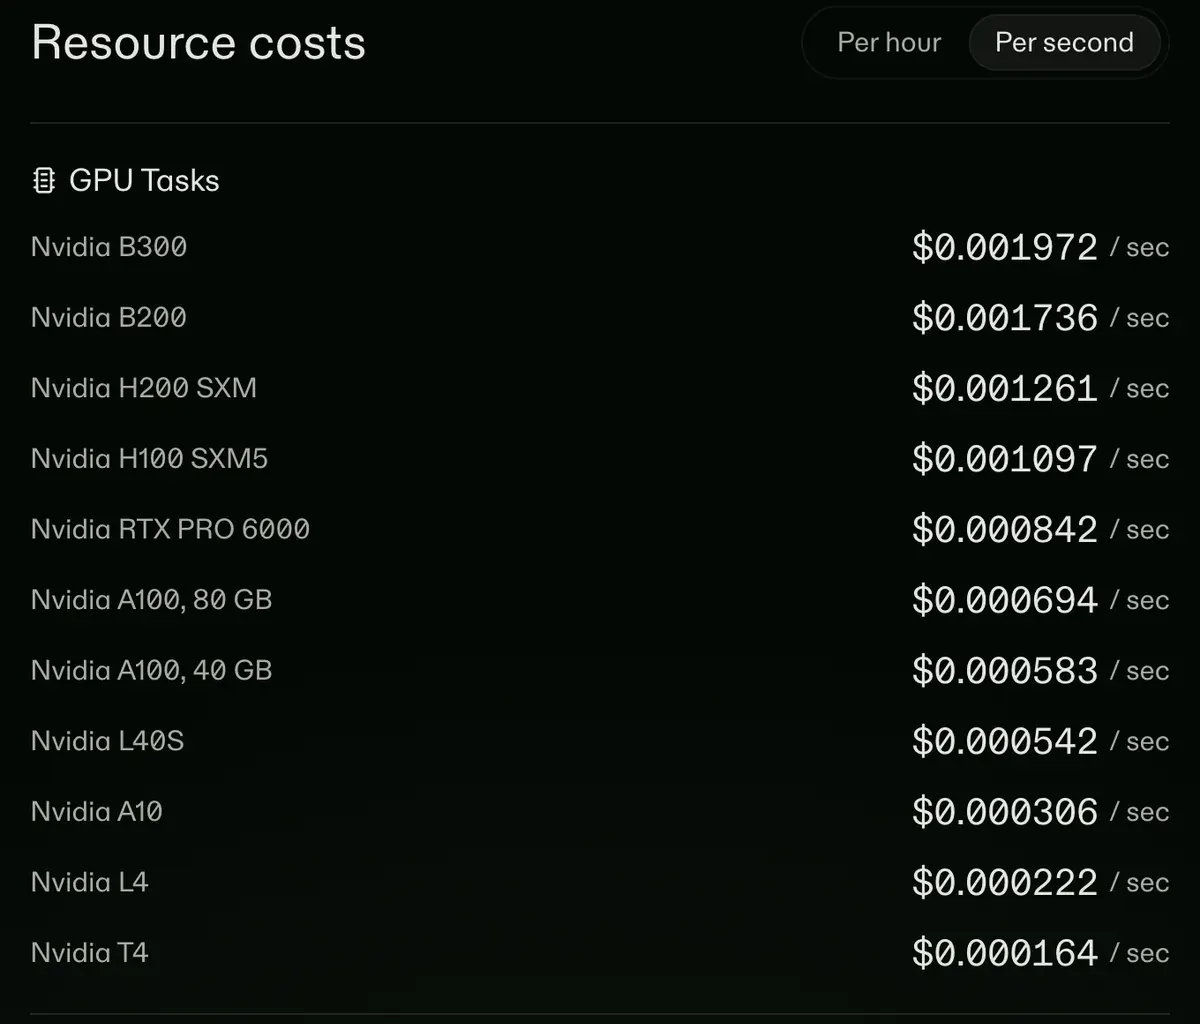
Le serverless coûte plus cher à l'heure et moins cher au mois quand les requêtes sont rares. Le worker flex de Runpod est facturé du démarrage à l'arrêt complet et revient à zéro entre deux tâches (prix de Runpod). Modal facture chaque seconde d'exécution d'une fonction, sans frais entre deux requêtes : son tarif H100 de 0,0011 $ la seconde fait 3,95 $ de l'heure (tarifs Modal).
Ce que coûte une image ou un clip
Le prix à l'heure vous apprend peu tant que vous ne savez pas à quelle vitesse la carte travaille. Le bon chiffre est le coût par résultat : le prix horaire divisé par le nombre de résultats terminés en une heure.
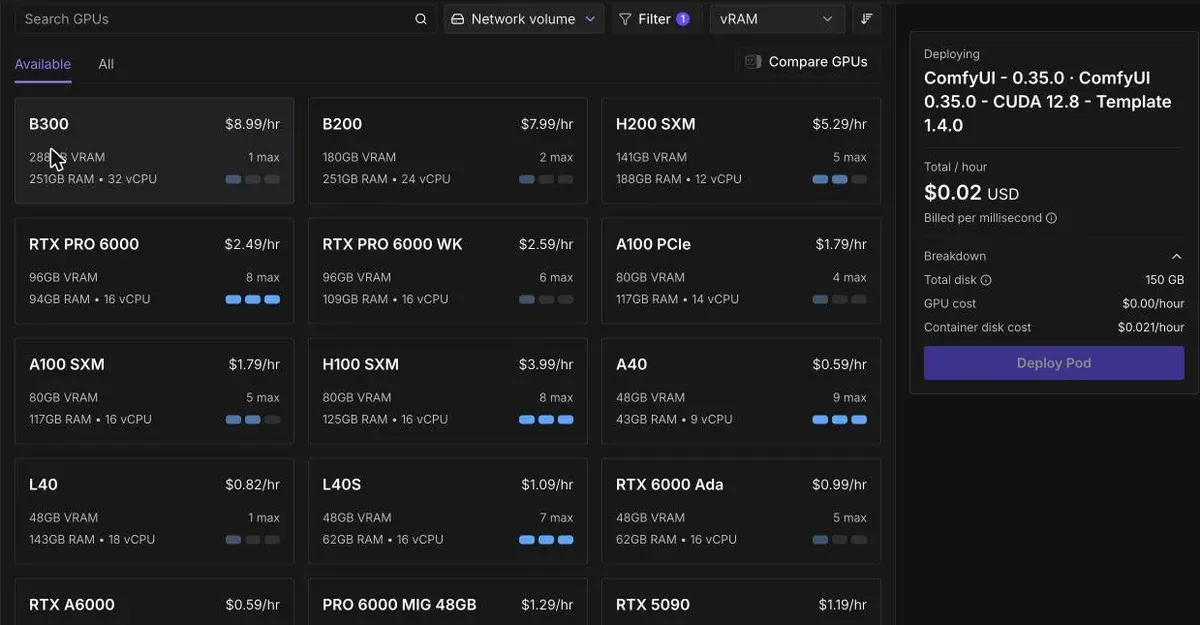
Sur notre propre compte Runpod le 17 octobre 2026, une RTX 4090 Secure Cloud a produit 12 images FLUX 3 Klein en 342 secondes. Chacune faisait 1280 x 1280 en 16 étapes, soit environ 28.5 secondes par image.
Le tableau ci-dessous applique ce temps à chaque tarif 4090. Chaque ligne suppose les 28.5 secondes mesurées sur Secure Cloud.
| Où tourne la 4090 | À l'heure | Pour 100 images |
|---|---|---|
| Runpod Community Cloud | 0,34 $ | 0,27 $ |
| TensorDock, prix habituel | 0,35 $ | 0,28 $ |
| Vast.ai, le moins cher vérifié | 0,41 $ | 0,32 $ |
| Runpod Secure Cloud, mesuré | 0,89 $ | 0,70 $ |
| Runpod Serverless | 1,10 $ | 0,87 $ |
Faites défiler sur le côté pour voir les 3 colonnes
Les réglages changent la facture plus que le cloud. Le modèle FLUX 3 Klein complet en 50 étapes a pris environ 4 minutes par image sur le même pod, 0,06 $ chacune.
Ces chiffres ne comptent que le temps GPU. Le démarrage du pod, le chargement du modèle et le stockage s'y ajoutent. Notre détail des prix de Runpod les additionne.
Pour la vidéo, chronométrez un clip sur votre propre pod et divisez. Le Wan 2.2 hébergé par Runpod fait un clip de 5 secondes en 720p pour 0,30 $ (prix de Runpod). Une 5090 louée à 1,19 $ ne fait mieux que si chaque clip prend moins de 15 minutes (1.19 divisé par 0.30 font 3.97 clips à l'heure).
Quel GPU pour quelle tâche
La VRAM est le premier filtre. Un modèle qui ne tient pas déborde dans la mémoire principale de l'ordinateur (déchargement) : cela fonctionne, mais plus lentement.
| Usage | VRAM nécessaire | Cartes adaptées |
|---|---|---|
| Images pub avec FLUX ou des modèles d'image similaires | Modèles de 6 à 17 Go, sur notre propre compte Runpod | RTX 4090 ou 5090 |
| Vidéo Wan 2.2 5B | Tient dans 8 Go avec le déchargement de ComfyUI, d'après la doc de ComfyUI | N'importe quelle carte du tableau ; la RTX 4090 est la moins chère |
| Gros modèles vidéo proches de 40 Go | Plus que les 32 Go d'une 5090, sur notre propre compte Runpod | L40S, A100 ou RTX PRO 6000 |
Faites défiler sur le côté pour voir les 3 colonnes
Un modèle vidéo d'environ 40 Go déborde d'une 5090 et se décharge. Sur notre propre compte, ce débordement explique qu'une carte de 96 Go puisse coûter moins par clip malgré son prix horaire plus élevé. La fiche du modèle Wan 2.2 dit que sa version 5B « peut aussi tourner sur des cartes graphiques grand public comme 4090 » (Hugging Face).
Les installations pas à pas sont dans Wan 2.2 sur Runpod avec ComfyUI et ComfyUI sur Runpod. Notre dossier Runpod rassemble le reste.
La licence du modèle suit chaque location
Le cloud loue du matériel ; la licence du modèle décide si son résultat peut passer dans une pub. Wan 2.2 est sous Apache 2.0. LTX-2 exige une licence payante dès qu'une entreprise gagne 10 000 000 $ par an ou plus (licence, section 2.1).
La licence de MiniMax H3 exclut les États-Unis, l'UE, le Royaume-Uni et la Corée du Sud : ses clips ne peuvent donc pas passer en pub là-bas, quel que soit le GPU qui les a produits. Des hébergeurs moins chers pour le même travail sont comparés dans alternatives à Runpod.
Comment le tableau est construit
Un prix entre dans le tableau quand la page ou l'API du fournisseur le montre, pour une carte à la demande, relevé le 24 octobre 2026. « Non listé » signifie que cette page n'affiche aucun prix à la demande pour une seule carte de ce GPU.
Les prix de Vast.ai viennent de sa recherche d'offres publique : offres vérifiées, louables, à un seul GPU, à la demande, triées par prix horaire total avec le disque par défaut. Modal publie des tarifs à la seconde ; le tableau les multiplie par 3 600. La page de TensorDock donne un prix habituel qui varie selon l'hébergeur et indique avoir été mise à jour le 24 juillet 2024.
Chaque ligne garde une ancre, si bien qu'un lien comme /data/cloud-gpu-prices/#runpod-community reste stable. Les corrections figurent dans la liste des modifications de cette page et sur la page Mises à jour et corrections.
Comment citer ces données
adtestbench, « Prix des GPU cloud pour images et vidéos IA », https://adtestbench.com/data/cloud-gpu-prices/, mis à jour le .
- Fichier CSV /data/cloud-gpu-prices.csv
Sources
- Runpod : Runpod pricing, tarifs Secure Cloud, Community Cloud et Serverless ; l'API des types de GPU sur notre propre compte a donné les mêmes chiffres. Vérifié le
- Vast.ai : Vast.ai offer search API, offres vérifiées, louables, à un seul GPU, à la demande ; le prix horaire total inclut le disque par défaut. Vérifié le
- Vast.ai : Vast.ai pricing, prix fixés par les hébergeurs. Vérifié le
- Lambda : Lambda GPU cloud pricing, prix par GPU et par heure, facturé à la minute, plus TVA ou taxe de vente. Vérifié le
- Modal : Modal pricing, tarifs GPU à la seconde. Vérifié le
- TensorDock : TensorDock cloud GPUs, prix horaire habituel, variable selon l'hébergeur, facturé à la seconde ; page mise à jour le 24 juillet 2024. Vérifié le
- Massed Compute : Massed Compute pricing. Vérifié le
- DigitalOcean : DigitalOcean GPU Droplets pricing, facturé à la seconde, minimum de 5 minutes. Vérifié le
- Paperspace (DigitalOcean) : Paperspace pricing, H100 à la demande à un prix promo ; tarif A100 affiché seulement avec un engagement de trois ans. Vérifié le
- ComfyUI docs : Wan2.2 in ComfyUI, le modèle 5B et le déchargement natif. Vérifié le
- Runpod docs : Choose a Pod, fiabilité de Community Cloud variable ; plus de nouveaux hébergeurs Community. Vérifié le
- Wan-AI on Hugging Face : Wan2.2 TI2V-5B model card, Apache 2.0 ; tourne sur des cartes grand public comme la 4090. Vérifié le
- Lightricks on GitHub : LTX-2 Community License Agreement, section 2.1. Vérifié le

Alexandre S.
Alexandre S. est stratège créatif en publicité et copywriter, avec dix ans d’expérience en marketing digital sur plusieurs canaux.
Pages associées
-
 Données Suivi des prix des outils de pub IA
69 outils de pub IA sur 82 affichent un prix catalogue lu sur la page du vendeur, dernier contrôle le 16 octobre 2026, avec le coût par clip ou par image quand un tarif le permet.
-
 Guide Workflow ComfyUI pour influenceur IA
Les blocs ComfyUI derrière un influenceur IA, la licence de chaque modèle ouvert, où trouver des workflows et le coût du GPU loué par image. Vérifié le 24 oct. 2026.
-
 Tarifs Prix de Higgsfield
Les formules Higgsfield démarrent à 15 $ par mois pour 200 crédits, soit environ 0,075 $ le crédit. Ce que couvre l'Unlimited, l'offre gratuite, l'essai et les remboursements. Vérifié le 21 oct. 2026.


