Alternativas ao Runpod
Veredito sobre as alternativas ao Runpod
Fique no Runpod para ComfyUI em uma 4090: a 4090 verificada mais barata da Vast.ai custa US$ 0,41 por hora, contra US$ 0,34 do Runpod. Em uma 5090, o host verificado mais barato da Vast.ai sai US$ 0,05 por hora mais barato (lido em ).
O problema é a disponibilidade: 13 de 48 fontes de usuários relatam GPUs populares que não conseguiram alugar (Trustpilot, Reddit).
Para ComfyUI em uma RTX 4090 ou 5090 alugada, com modelos mantidos entre sessões: Runpod
Template oficial do ComfyUI, modelos em um network volume. Na nossa própria conta do Runpod em 17 de out. de 2026, uma imagem FLUX levou 28.5 s em uma 4090 da Secure Cloud.
Para vídeo e imagens de anúncio sem GPU, modelo ou workflow para configurar:  Higgsfield
Kling, Veo e Seedance no navegador, com um único saldo de créditos; você paga por geração, nunca por hora.
| Ferramenta | A partir de (US$/mês) | Verificado em | O que faz | Site oficial |
|---|---|---|---|---|
| Runpod A ferramenta que você quer substituir | Pagamento por uso | Nuvem de GPU cobrada por segundo: alugue uma RTX 4090 a partir de US$ 0,34 por hora e rode ComfyUI, Wan 2.2, LTX-2 ou FLUX por conta própria. | Visitar o Runpod | |
 Higgsfield | US$ 19 | Estúdio multimodelo com Seedance, Kling, Veo e os próprios modelos Soul, além de ferramentas de anúncio e UGC e um agente. | Visitar Higgsfield |
Role para o lado para ver as 5 colunas
Por que as pessoas buscam uma alternativa ao Runpod
Uma GPU é o chip gráfico que roda modelos de imagem e vídeo, e a VRAM é a memória dela: o modelo precisa caber nela. O Runpod aluga as duas por hora. Você inicia um pod (uma máquina alugada com uma ou mais GPUs) a partir de um template (uma configuração de software pronta, como o ComfyUI). Nossa central do Runpod cobre o caminho todo.
Nossa contagem se apoia em 48 fontes de usuários: as 24 avaliações da primeira página do Runpod no Trustpilot e 24 discussões do Reddit de fevereiro a outubro de 2026.
A disponibilidade lidera as reclamações: 13 de 48 fontes relatam GPUs populares que não conseguiram alugar (Trustpilot, Reddit). Oito descrevem pods que nunca funcionaram ou lançamentos que falharam (Trustpilot, Reddit).
O preço é o segundo motivo: 7 de 48 fontes descrevem aumentos na RTX 5090 e na 4090, ou chamam o serviço de caro (Reddit, Trustpilot).
Os elogios são sobre a configuração. Cinco de 48 fontes acham o Runpod fácil de configurar, e 3 elogiam as respostas rápidas do suporte (Trustpilot). Quatro de 48 valorizam alugar uma GPU topo de linha por segundo (Trustpilot, Reddit).
Preço por hora de uma RTX 4090, 5090 e H100
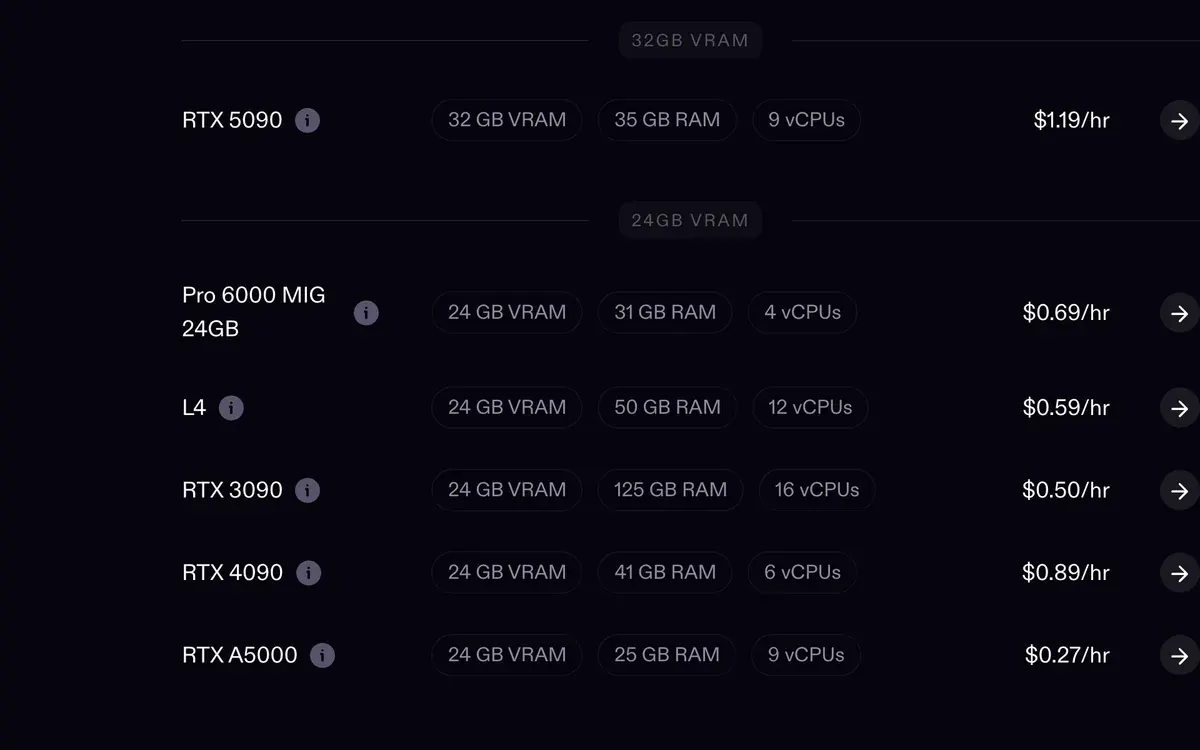
A Community Cloud do Runpod lista a menor tarifa da RTX 4090 e a menor da H100, por um centavo. Os hosts verificados da Vast.ai listam a menor RTX 5090. Para a Vast.ai, a tabela conta só hosts verificados, e todo preço vem da página ou da API do próprio fornecedor em 24 de outubro de 2026.
| Nuvem e plano | RTX 4090 (24 GB) | RTX 5090 (32 GB) | H100 (80 GB) |
|---|---|---|---|
| Runpod Community H100 PCIe, cobrança por segundo | US$ 0,34 | US$ 0,69 | US$ 1,99 |
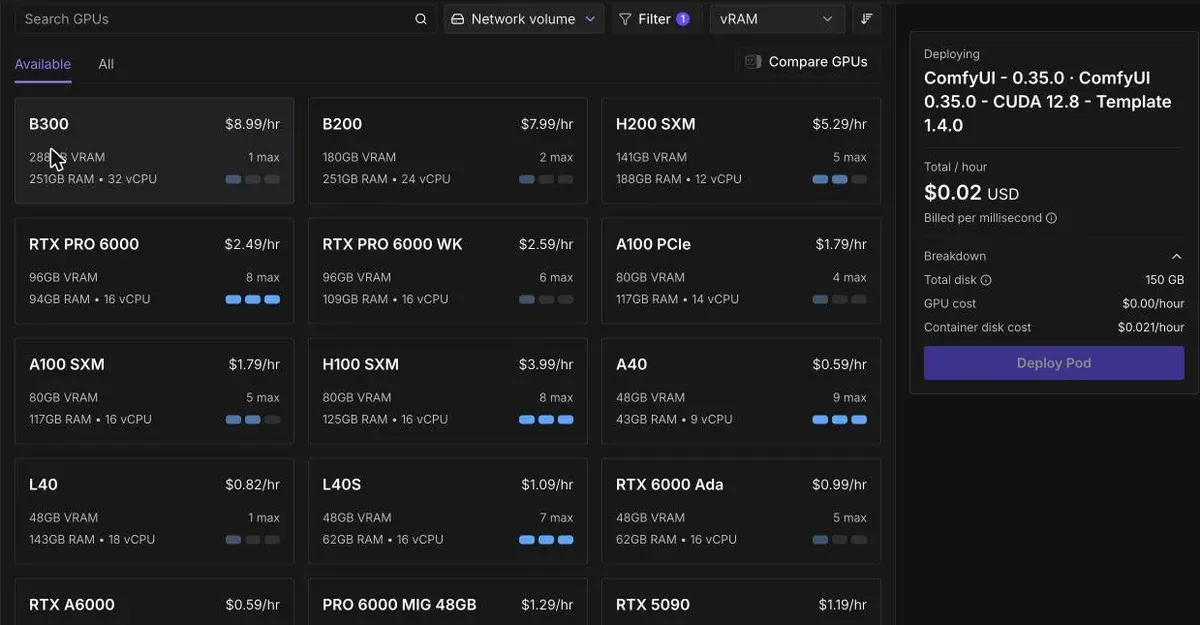
| Runpod Secure H100 PCIe, cobrança por segundo | US$ 0,89 | US$ 1,19 | US$ 2,89 |
| Vast.ai Menor oferta verificada, H100 PCIe | US$ 0,41 | US$ 0,64 | US$ 2,00 |
| TensorDock Preço típico, varia conforme o host; H100 SXM5, cobrança por segundo | US$ 0,35 | Não listado | US$ 2,25 |
| Massed Compute H100 80 GB, preço por hora | Não listado | Não listado | US$ 2,73 |
| Lambda H100 PCIe, cobrança por minuto | Não listado | Não listado | US$ 3,29 |
| Modal H100 SXM5, cobrança por segundo | Não listado | Não listado | US$ 3,95 |
| DigitalOcean GPU Droplets HGX H100, por segundo, mínimo de 5 minutos | Não listado | Não listado | US$ 4,41 |
| Paperspace H100 sob demanda a preço promocional, cobrança por hora | Não listado | Não listado | US$ 5,95 |
Role para o lado para ver as 4 colunas
A linha mais barata nem sempre é a imagem mais barata. Uma placa mais lenta com tarifa menor pode custar mais por resultado. Divida o preço por hora pelo número de resultados que você obtém em uma hora antes de trocar.
Runpod vs Vast.ai: as mesmas placas, dois tipos de host
A Vast.ai é um marketplace: hosts independentes listam suas próprias máquinas e definem seus preços. A página de preços dela diz que os preços “são definidos pelo mercado, não pela Vast.” O Runpod lista um preço por placa na Secure Cloud e outro na Community Cloud, de hosts peer-to-peer.
A busca de ofertas da Vast.ai em 24 de outubro de 2026 retornou 39 máquinas RTX 4090 verificadas para uma GPU sob demanda. A mais barata custava US$ 0,41 por hora e a mediana, US$ 0,67. Hosts não verificados listavam menos, a partir de US$ 0,17.
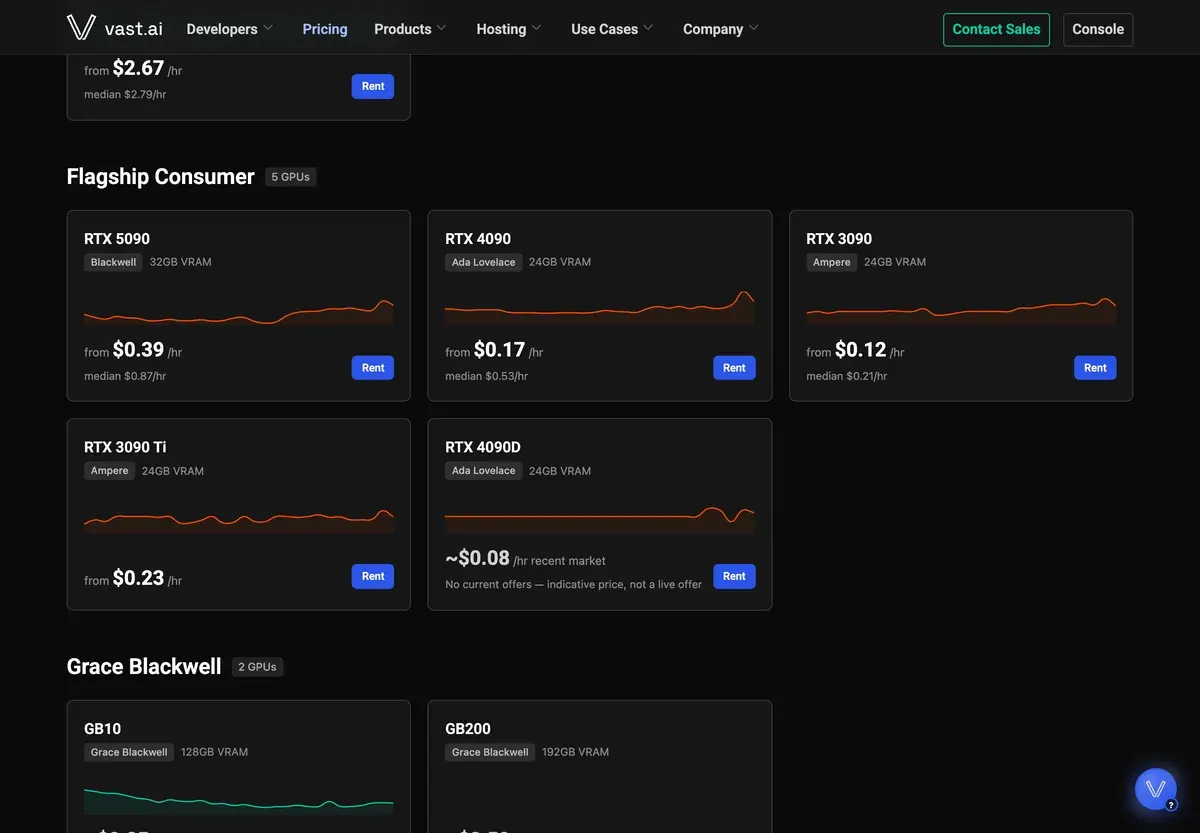
A Vast.ai também vende máquinas Interruptible, que, segundo a página de preços, “podem ser recuperadas”. Serve para um lote de imagens que você pode reiniciar. Atrapalha na renderização de um vídeo de 20 minutos.
No Trustpilot, a Vast.ai tem 262 avaliações e TrustScore 3.8, contra 387 avaliações e TrustScore 3.5 do Runpod. Ambos foram lidos em 24 de outubro de 2026.
As duas nuvens rodam ComfyUI a partir de um template. O guia de geração de vídeo da Vast.ai manda buscar por “ComfyUI” na aba Templates. O seletor de templates do Runpod mostra primeiro o template oficial do ComfyUI, com templates da comunidade para Wan 2.2 ao lado.
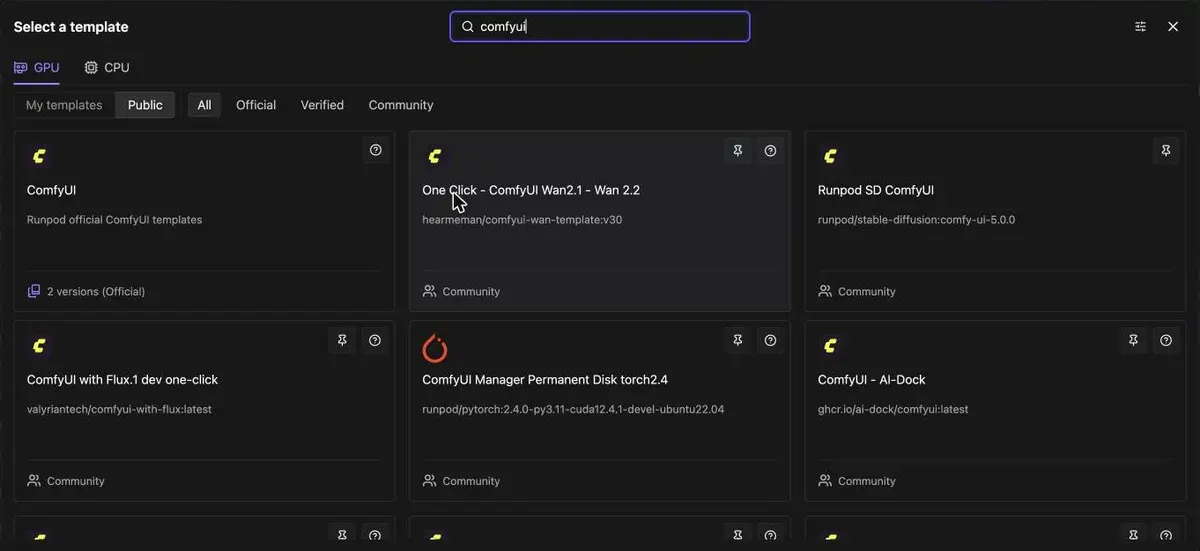
O Runpod guarda seus modelos em um network volume, armazenamento que sobrevive a qualquer pod. Na nossa própria conta do Runpod, 28 sessões curtas de pod entre 16 e 21 de outubro de 2026 custaram US$ 9,26 no total.
O armazenamento em rede dos modelos acrescentou US$ 2,21 em outubro até o dia 24, o único custo que continua rodando quando nenhum pod está ligado. Nossa página de preços do Runpod detalha a conta, e ComfyUI no Runpod mostra a configuração passo a passo.
Um novo usuário do Runpod que se cadastra com o Google por um link de indicação e depois carrega US$ 10 recebe um crédito único. Quem o indicou também.
O crédito vai de US$ 5 a US$ 500, e a maioria das pessoas recebe US$ 5 (documentação de indicação). Usuários na Europa recebem US$ 5 fixos. Nosso guia do código de indicação do Runpod traz os passos.
Modal: GPUs por segundo a partir de código Python
Modal executa sua função Python em uma GPU e cobra por segundo de execução, então uma configuração parada entre requisições não custa nada. Serve para uma equipe que quer transformar um workflow do ComfyUI em API para uma ferramenta de anúncios.
O Modal lista apenas placas de data center. A H100 sai a US$ 3,95 por hora e a L40S a US$ 1,95, contra US$ 1,09 da Secure Cloud do Runpod pela mesma L40S (preços do Modal).
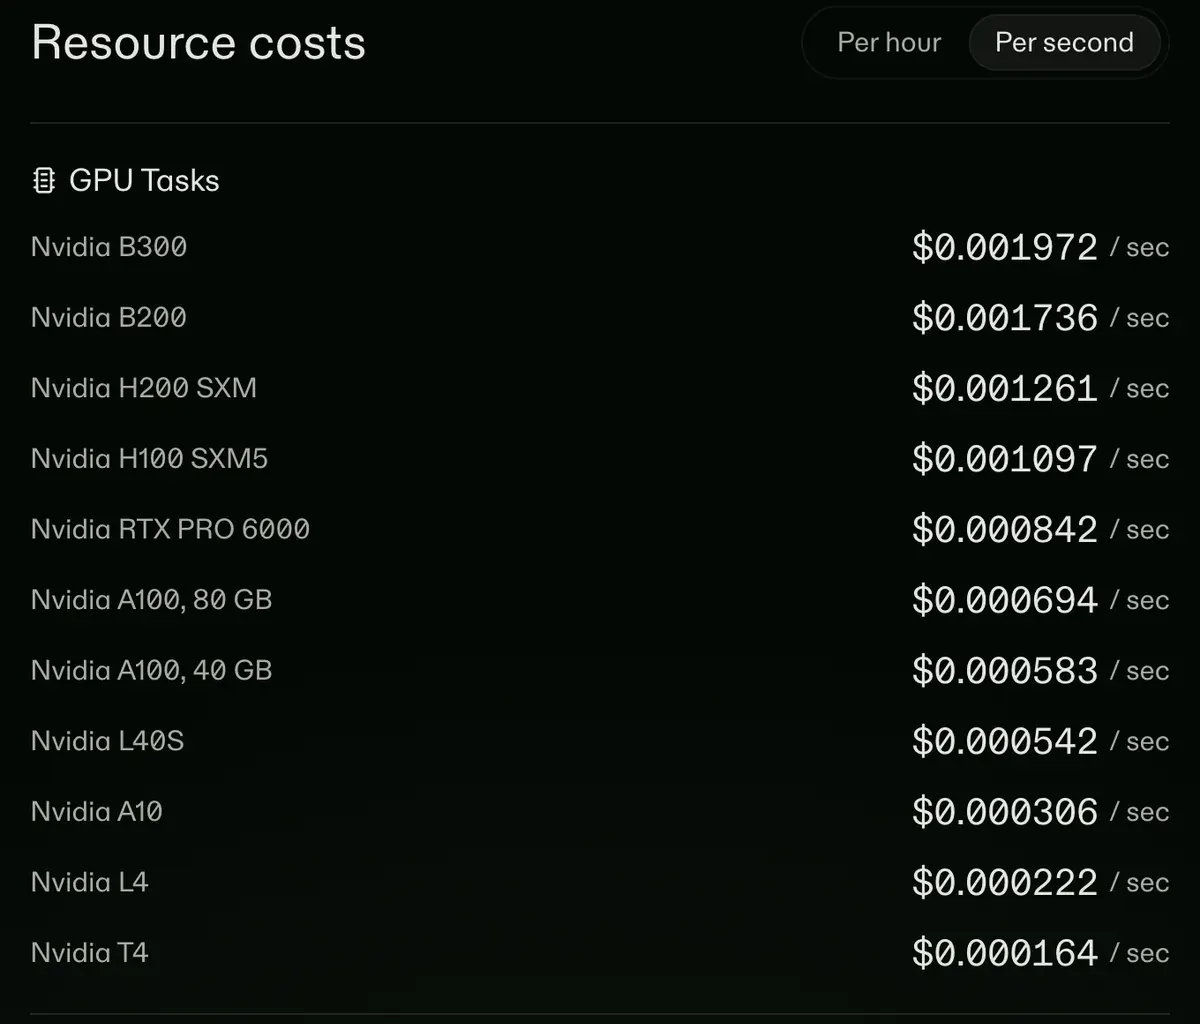
O plano gratuito Starter inclui US$ 30 em créditos de computação por mês. Escolha o Modal se você escreve código e não quer nada rodando entre requisições.
Lambda: H100 e B200 para jobs do porte de um treinamento
A Lambda aluga GPUs de data center por minuto, de uma única placa a clusters de oito. Uma H100 PCIe custa US$ 3,29 por hora e uma B200, US$ 6,99.
A placa de 24 GB mais barata dela é uma Quadro RTX 6000, por US$ 0,69, duas gerações mais velha que uma 4090. A Lambda serve para treinar um modelo com oito GPUs ao mesmo tempo. Para uma pessoa que faz imagens, as tarifas da 4090 acima custam menos.
TensorDock: preços de marketplace e uma página desatualizada
A TensorDock é um marketplace como a Vast.ai. Sua página pública traz um preço típico por hora de US$ 0,35 para uma RTX 4090 e de US$ 2,25 para uma H100 SXM5, com cobrança por segundo.
A mesma página diz que o preço “varia conforme o host” e que foi atualizada pela última vez em 24 de julho de 2024. As tarifas ao vivo ficam atrás do painel dela.
Massed Compute: tarifas fixas por hora em placas de 48 a 96 GB
A Massed Compute cobra cada máquina com GPU por hora. Uma L40S com 48 GB custa US$ 0,97 e uma RTX PRO 6000 Blackwell com 96 GB, US$ 2,19.
A Community Cloud do Runpod lista a mesma RTX PRO 6000 por US$ 1,69. A Massed Compute não lista RTX 4090 nem 5090, então serve para modelos de vídeo grandes que precisam dos 96 GB.
Paperspace e DigitalOcean GPU Droplets
A Paperspace agora pertence à DigitalOcean, cujo banner diz “Paperspace is now part of DigitalOcean!” A página de preços dela traz uma H100 sob demanda a US$ 5,95 por hora com um “special promo price”. As tarifas menores da H100 e da A100 exigem compromisso de três anos.
Os GPU Droplets da própria DigitalOcean listam uma L40S a US$ 1,57 por hora, com cobrança por segundo e mínimo de 5 minutos. Um Droplet desligado continua cobrando até você destruí-lo.
Baseten: modelos implantados como APIs, com preço por minuto
A Baseten hospeda um modelo como endpoint e cobra “com precisão de minuto” enquanto ele computa. Uma H100 custa US$ 0,108 por minuto, ou seja, US$ 6,50 por hora. A Baseten roda e escala o servidor do modelo para você. Em um pod do Runpod, é você quem o roda, e o Serverless do Runpod fica entre os dois.
Comfy Cloud: ComfyUI no navegador com plano mensal
O Comfy Cloud é o ComfyUI rodado pelos próprios criadores, sem pod para iniciar. O Standard custa US$ 20 por mês e todos os planos rodam em uma RTX 6000 Pro com 96 GB.
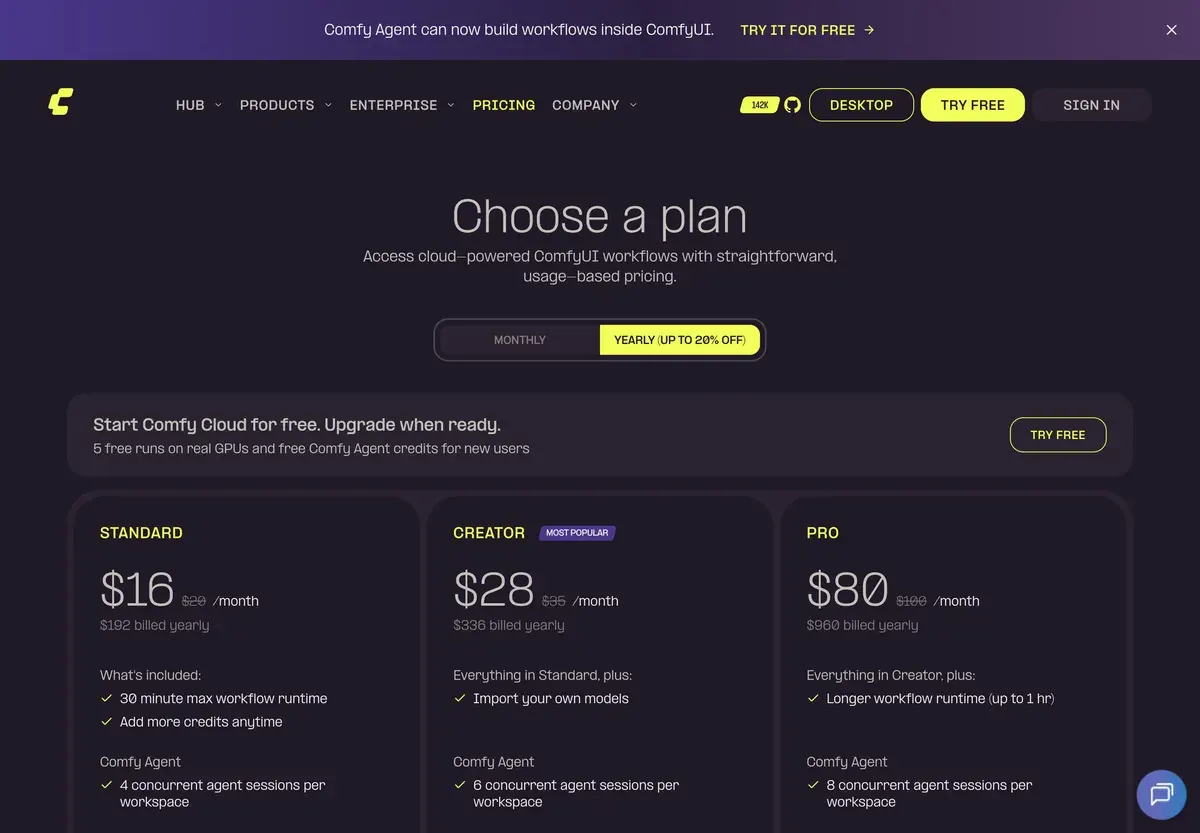
Cada job no Standard para em 30 minutos, e o Pro eleva esse limite para uma hora. Escolha-o se seus jobs terminam em 30 minutos e você prefere pagar US$ 20 por mês a pagar por hora.
 Higgsfield: apps por crédito em vez de uma GPU
Higgsfield vende gerações prontas de Kling, Veo, Seedance e dos próprios modelos Soul em um único plano de créditos. O Starter custa US$ 19 por mês (página de preços, verificada em ).
Você nunca escolhe uma GPU nem carrega um modelo. A contrapartida é a lista de modelos: modelos abertos como Wan 2.2 ou LTX-2 com configurações próprias exigem uma GPU alugada. Nosso perfil do Higgsfield cobre créditos e termos.
As licenças dos modelos vão com você
Toda nuvem acima aluga hardware, então a licença do modelo que você roda decide o que seu anúncio pode fazer. O Wan 2.2 é Apache 2.0. O LTX-2 é gratuito para uso comercial abaixo de US$ 10.000.000 de receita anual (licença, seção 2.1).
A licença comunitária do MiniMax H3 exclui EUA, UE, Reino Unido e Coreia do Sul, então ele não serve para anúncios nesses mercados em nenhuma nuvem. Wan 2.2 no Runpod configura o modelo Apache passo a passo.
O que ficou de fora e por quê
Google Cloud, AWS e Azure precificam GPUs dentro de famílias inteiras de máquinas virtuais, região por região e sujeitas a cotas. Nenhum valor por hora isolado delas se compara com as linhas acima.
Fontes
- Runpod: Runpod pricing, tarifas por hora da Secure Cloud, da Community Cloud e do Serverless; a API da nossa própria conta deu as mesmas tarifas. Verificado em
- Documentação do Runpod: Runpod referral programme, cadastro pelo Google, um valor mínimo na primeira recarga, um crédito único para as duas pessoas. Verificado em
- Vast.ai: Vast.ai pricing, preços definidos pelos hosts; faixas On-Demand, Interruptible e Reserved. Verificado em
- Vast.ai: Vast.ai offer search API, ofertas verificadas, alugáveis, de GPU única sob demanda, ordenadas pelo preço total por hora. Verificado em
- Documentação da Vast.ai: Vast.ai video generation guide, o template do ComfyUI na aba Templates. Verificado em
- Modal: Modal pricing, tarifas de GPU por segundo; créditos mensais grátis no Starter. Verificado em
- Lambda: Lambda GPU cloud pricing, preço sob demanda por GPU por hora, cobrança por minuto. Verificado em
- TensorDock: TensorDock cloud GPUs, preço típico por hora, varia conforme o host, cobrança por segundo; a página diz ter sido atualizada pela última vez em 24 de julho de 2024. Verificado em
- Massed Compute: Massed Compute pricing. Verificado em
- Paperspace (DigitalOcean): Paperspace pricing, H100 sob demanda a preço promocional; as demais tarifas exibidas são de compromisso de três anos. Verificado em
- DigitalOcean: DigitalOcean GPU Droplets pricing, cobrança por segundo com mínimo de 5 minutos. Verificado em
- Baseten: Baseten pricing, implantações dedicadas com preço por minuto. Verificado em
- Comfy Org: Comfy Cloud pricing, quatro planos em uma RTX 6000 Pro com 96 GB; 30 minutos por job no Standard. Verificado em
- Trustpilot: Runpod reviews, 387 avaliações, TrustScore 3.5; achados contados nas 24 avaliações da primeira página. Verificado em
- Reddit, lido pelo arquivo Arctic Shift: Threads sobre o Runpod em r/RunPod e r/comfyui, 24 threads, de fevereiro a outubro de 2026. Verificado em
- Trustpilot: Avaliações da Vast.ai, 262 avaliações, TrustScore 3.8. Verificado em
- MiniMax no Hugging Face: MiniMax H3 Community License Agreement, Excluded Territories. Verificado em
- Lightricks no GitHub: LTX-2 Community License Agreement, seção 2.1, licença paga acima de um limite de receita anual. Verificado em

Alexandre S.
Alexandre S. é estrategista criativo de anúncios e redator publicitário, com dez anos de experiência em marketing digital em vários canais.
Páginas relacionadas
-
 Categoria Melhores geradores de vídeo com IA para anúncios
23 geradores de vídeo com IA e plataformas multimodelo comparados em custo por clipe e termos de uso em anúncios, verificados em 25 de setembro de 2026.
-
 Perfil Runpod
Runpod para imagens e vídeos de anúncios: Secure ou Community Cloud, Pods ou Serverless, licenças de modelos e o que 48 fontes de usuários relatam. Verificado em 24 de out. de 2026.
-
 Preços Preços do Runpod
Preços por hora de GPU do Runpod na Secure, na Community e no Serverless, tarifas de armazenamento e quanto custa uma imagem no nosso próprio Pod com RTX 4090. Verificado em 30 de out. de 2026.
-
 Guia Fluxo de trabalho de influenciador de IA no ComfyUI
Os blocos do ComfyUI por trás de um influenciador de IA, a licença de cada modelo aberto, onde encontrar fluxos de trabalho e o custo da GPU alugada por imagem. Verificado em 24 de out. de 2026.
-
 Alternativas Alternativas ao Higgsfield
Outros estúdios que revendem Kling, Veo e Seedance num só plano, comparados ao Higgsfield em custo por clipe, termos de treinamento e reembolsos, verificado em 2 de outubro de 2026.
-
 Dados Monitor de preços de ferramentas de IA para anúncios
69 de 82 ferramentas de IA para anúncios mostram preço de tabela lido na página do próprio fornecedor, verificado pela última vez em 16 de outubro de 2026, com o custo por clipe ou imagem quando a tarifa permite calcular.


