Wan 2.2 e LTX-2 na Runpod
Wan 2.2 e LTX-2 são modelos de vídeo abertos. Você baixa os arquivos e roda por conta própria no ComfyUI, em uma placa de vídeo sua ou alugada. A Runpod aluga essas placas por segundo.
O modelo pequeno de 5B do Wan 2.2 e o LTX-2 cabem em uma placa de 24 ou 32 GB, como a RTX 4090 ou a RTX 5090. A 720p, os modelos de 14B do Wan pedem 48 GB no formato mais leve, fp8. No tamanho completo, pedem 80 GB ou mais, como a RTX PRO 6000 de 96 GB.
Calculado a partir dos tempos de geração publicados, um clipe curto custa de menos de um centavo a cerca de um dólar de tempo de GPU. O dólar vem do script de referência da Alibaba.
| Modelo | O que gera | Memória de vídeo (fonte) | Placa da Runpod compatível | Licença para anúncios |
|---|---|---|---|---|
| Wan 2.2 TI2V-5B | Texto ou imagem para vídeo, 720P a 24 FPS | 24 GB (equipe da Wan), cerca de 8 GB com offloading (ComfyUI) | RTX 4090, 24 GB | Apache 2.0 |
| Wan 2.2 T2V e I2V A14B | Texto para vídeo, imagem para vídeo, 480P e 720P | 80 GB em uma GPU (equipe da Wan); 24 GB em fp8 a 480p (Runpod) | RTX PRO 6000, 96 GB, para 720p | Apache 2.0 |
| LTX-2 e LTX-2.3 | Vídeo com som sincronizado | Clipe de 720p e 4 segundos dentro de 32 GB (NVIDIA) | RTX 5090, 32 GB | Grátis abaixo de US$ 10.000.000 de receita anual |
Role para o lado para ver as 5 colunas
O que são o Wan 2.2 e o LTX-2?
O Wan 2.2 é a família de modelos de vídeo abertos da Alibaba. A versão mais nova, o Wan 3.0, é vendida por segundo pela API da Alibaba Cloud. A página do Wan 2.2 no GitHub lista um modelo de 5B que transforma texto ou imagem em vídeo de 720P (Wan2.2 no GitHub). Os modelos de 14B cobrem texto para vídeo, imagem para vídeo, fala para vídeo e animação de personagens.
O “B” significa bilhões de parâmetros, uma medida aproximada do tamanho do modelo. Modelos maiores exigem mais memória de vídeo, a VRAM, que é o número decisivo na hora de alugar uma placa.
O LTX-2 é o modelo aberto da Lightricks, e a versão 2.3 gera vídeo e som em uma só passada. A ficha do modelo LTX-2.3 diz que ele foi “projetado para gerar vídeo e áudio sincronizados em um único modelo” e indica aos usuários do ComfyUI os nós LTXVideo nativos.

Os dois rodam no ComfyUI, um app gratuito em que cada etapa do trabalho é uma caixa em uma tela, ligada à seguinte. O Wan 2.2 está no ComfyUI desde 28 de julho de 2025.
Dá para usar clipes do Wan 2.2 e do LTX-2 em anúncios?
Sim, nos dois casos, com uma condição de receita e uma lista de usos proibidos no LTX-2. A Runpod só aluga o hardware; quem define o que você pode fazer com os clipes é a licença do próprio modelo.
O Wan 2.2 usa a licença Apache 2.0, permissiva, que permite uso comercial. O repositório da equipe do Wan afirma: “Os modelos deste repositório são licenciados sob a Licença Apache 2.0.”
Licence
Licence The models in this repository are licensed under the Apache 2.0 License.
Outputs We claim no rights over the your generated contents, granting you the freedom to use them.
5B model The TI2V-5B model can also run on consumer-grade graphics cards like 4090.
O LTX-2 segue o Contrato de Licença Comunitária do LTX-2, de 5 de janeiro de 2026. Ele permite uso “para qualquer finalidade”, sujeito aos usos proibidos do Anexo A, como deepfakes feitos sem consentimento. O contrato vale para todas as versões do LTX-2 lançadas desde essa data, incluindo o LTX-2.3.
Para anúncios, a condição a verificar é o limite de receita. Entidades com receita anual de pelo menos US$ 10.000.000 “são obrigadas a obter uma licença comercial paga” (licença do LTX-2).
Section 2.1, grant of rights (dated 5 January 2026)
Entities with annual revenues of at least $10,000,000 (the “Commercial Entities”) are required to obtain a paid commercial use license in order to use LTX-2 and Derivatives of LTX-2.
O limite vale para o grupo inteiro, subsidiárias incluídas. Abaixo dele, o uso em anúncios não paga royalties, e a Lightricks “não reivindica direitos sobre o Output que você gera”.
A licença aberta do MiniMax H3 exclui os EUA, a União Europeia, o Reino Unido e a Coreia do Sul (licença do MiniMax H3). Para anúncios nesses locais, ele fica fora da lista.
Quanta VRAM é preciso e qual GPU da Runpod serve?
Primeiro ajuste o modelo e a resolução à memória da placa; só depois compare o preço. Quando o modelo não cabe, o ComfyUI joga parte dele na memória comum do pod, o que funciona, mas fica bem mais lento.
Wan2.2 in ComfyUI
Templates Workflows in this guide can be found in the Workflow Templates.
5B memory The Wan2.2 5B version should fit well on 8GB vram with the ComfyUI native offloading.
Licence The Wan2.2 series models are based on the Apache 2.0 open source license and support commercial use.
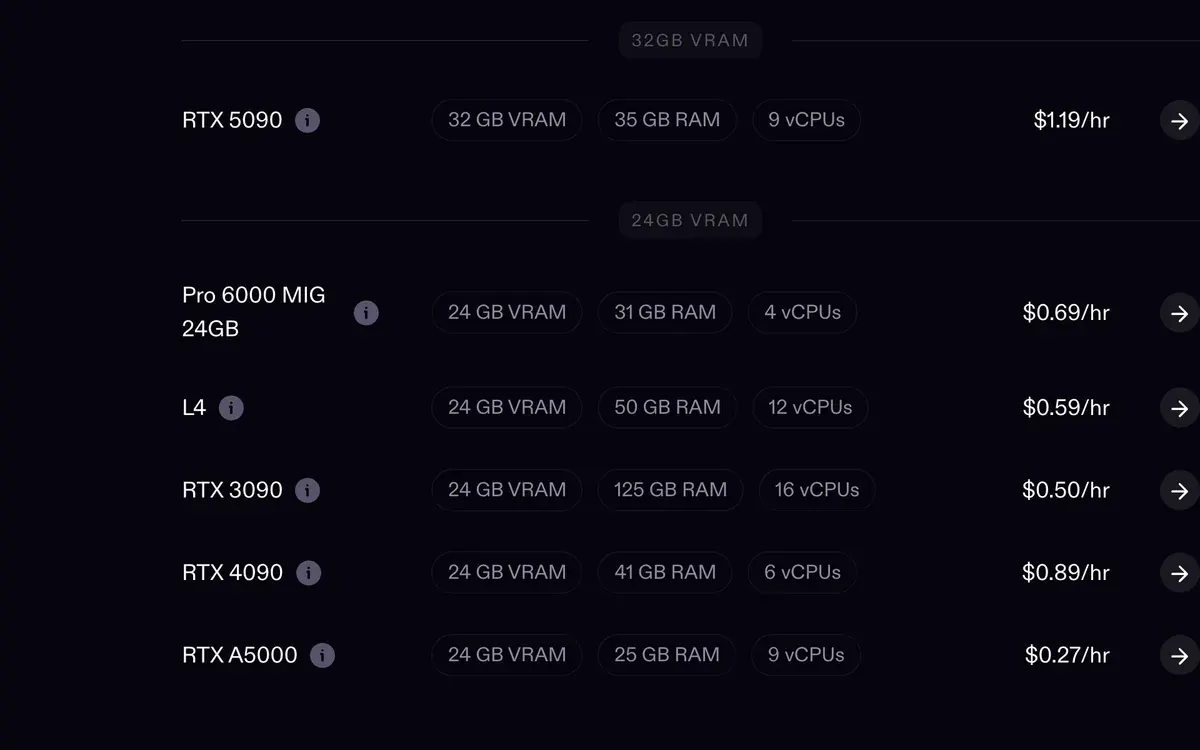
O guia da própria Runpod sobre o Wan 2.2, atualizado em 22 de outubro de 2026, traz faixas de memória por tipo de trabalho (guia do Wan 2.2 da Runpod). Os valores da tabela vêm da página de preços da Runpod.
| Função | Memória | Placa | Secure Cloud por hora | Community Cloud por hora |
|---|---|---|---|---|
| TI2V-5B em 1280 por 704 | 24 GB | RTX 4090 | US$ 0,89 | US$ 0,34 |
| 14B em fp8 a 480p ou 640 por 640 | 24 GB | RTX 4090 | US$ 0,89 | US$ 0,34 |
| 14B em fp8, clipes mais longos ou LoRAs | 32 GB | RTX 5090 | US$ 1,19 | US$ 0,69 |
| 14B em fp8 a 720p | 48 GB | L40S | US$ 1,09 | US$ 0,79 |
| 14B a 720p sem offloading | 80 GB ou mais | RTX PRO 6000, 96 GB | US$ 2,49 | US$ 1,69 |
Role para o lado para ver as 5 colunas
O fp8 da tabela é um formato de arquivo mais leve: os números do modelo são guardados com menos precisão, e por isso ele ocupa cerca de metade da memória.
Na nossa própria conta da Runpod, vemos o mesmo limite do lado das imagens. Modelos de imagem de 6 a 17 GB cabem folgados nos 32 GB da 5090. Um modelo de vídeo de cerca de 40 GB estoura essa memória e passa a usar offloading.
Por isso, uma placa de 96 GB pode sair mais barata por clipe do que uma placa mais barata que precisa recorrer ao offloading.
Quanto custa um clipe na Runpod?
De menos de um centavo por um clipe curto do LTX-2 a cerca de um dólar por um clipe do Wan 14B em 720p, no script de referência da Alibaba. Cada valor abaixo é calculado: o tempo de geração publicado multiplicado pelo preço por hora da Runpod.
| Clipe | Tempo publicado (fonte) | Placa | Secure Cloud | Community Cloud |
|---|---|---|---|---|
| LTX-2, 4 segundos, 720p, 24 fps | Cerca de 25 segundos (NVIDIA) | RTX 5090 | US$ 0,008 | US$ 0,005 |
| LTX-2, 8 segundos, 720p | Cerca de 3 minutos (NVIDIA) | RTX 5090 | US$ 0,06 | US$ 0,03 |
| Wan 2.2 14B, 5 segundos, 640 por 640, Lightning LoRA | Cerca de 71 segundos (Runpod, em uma RTX 4090D) | RTX 4090 | US$ 0,018 | US$ 0,007 |
| Wan 2.2 14B, 5 segundos, 640 por 640, 20 passos | Cerca de 513 segundos (Runpod, em uma RTX 4090D) | RTX 4090 | US$ 0,13 | US$ 0,05 |
| Wan 2.2 TI2V-5B, 5 segundos, 720P | Menos de 9 minutos (equipe da Wan, GPU de consumo) | RTX 4090 | US$ 0,13 | US$ 0,05 |
| Wan 2.2 14B, 720p, 40 passos, duração do clipe não informada | 17.4 minutos (benchmark da Alibaba) | H100 SXM | US$ 1,16 | US$ 0,78 |
Role para o lado para ver as 5 colunas
A Runpod mediu os 71 e 513 segundos em uma execução já aquecida (modelos já carregados) em uma RTX 4090D, a versão de exportação da 4090, com menos núcleos. Aqui, o custo usa o preço da 4090.
Os três minutos da NVIDIA para 8 segundos incluem a lentidão que surge quando o clipe passa de 32 GB. Os 9 minutos da equipe da Wan são um valor “abaixo de”, então essa linha é um teto. O carregamento dos modelos antes do primeiro clipe também é cobrado e fica fora destas linhas.
O Lightning LoRA, um pequeno arquivo complementar que reduz a amostragem do Wan para 4 passos, leva o mesmo clipe de cerca de 513 segundos para cerca de 71.
Para ter uma ideia de escala, este número foi medido na nossa própria conta. Uma imagem rápida do FLUX 3 Klein em uma RTX 4090 na Secure Cloud leva cerca de 28.5 segundos, ou US$ 0,007 cada. A tabela está no guia do ComfyUI na Runpod.
RTX 5090 ou RTX 4090 para o Wan no ComfyUI?
A RTX 4090 serve para o modelo de 5B e para o de 14B a 480p; a RTX 5090 entra quando 24 GB não bastam. A 5090 custa cerca de um terço a mais por hora na Secure Cloud, então só compensa quando os 8 GB extras evitam o offloading no ComfyUI. Na Community Cloud, custa cerca do dobro (US$ 0,69 contra US$ 0,34).
O guia da Runpod indica os 32 GB da 5090 para os trabalhos de 14B que pedem folga: clipes mais longos ou LoRAs carregados por cima. Para o LTX-2, a 5090 é a placa a alugar, já que o clipe de 720p e 4 segundos da NVIDIA cabe na memória dela.
Acima de 32 GB, descarte as duas. Uma L40S de 48 GB custa menos por hora do que uma 5090 na Secure Cloud. Para o 14B completo a 720p, a RTX PRO 6000 de 96 GB comporta o modelo inteiro.
Como configurar o Wan 2.2 com o template da HearmemanAI
Neste caminho, o pod baixa os modelos e os workflows sozinho na primeira inicialização. Ele usa um template da comunidade, publicado na Runpod pela HearmemanAI. Conecte um network volume (o disco permanente da Runpod, que continua existindo depois que o pod some) para o download acontecer uma só vez.
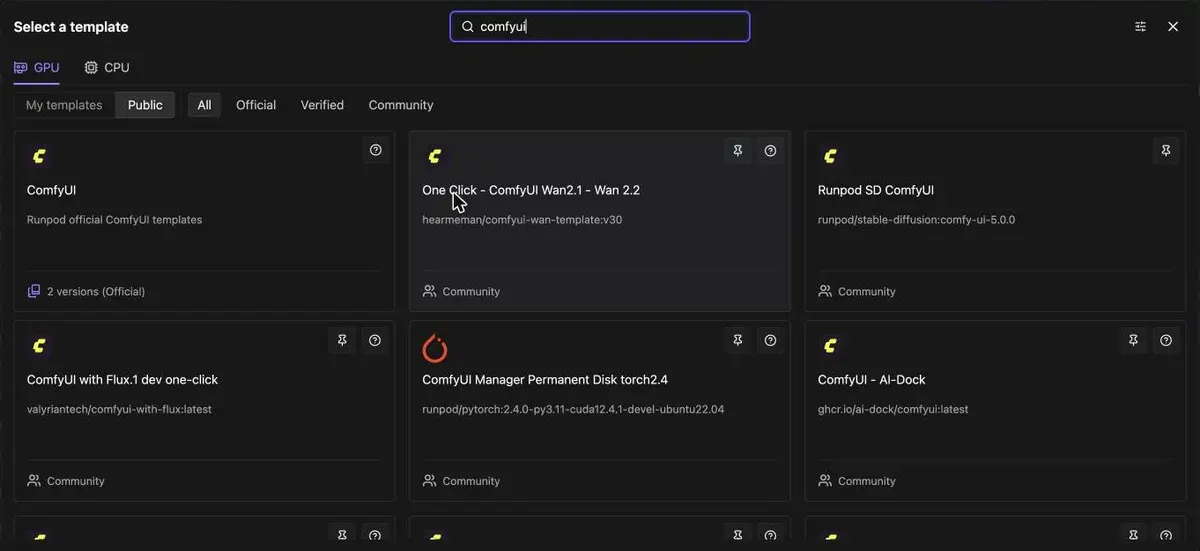
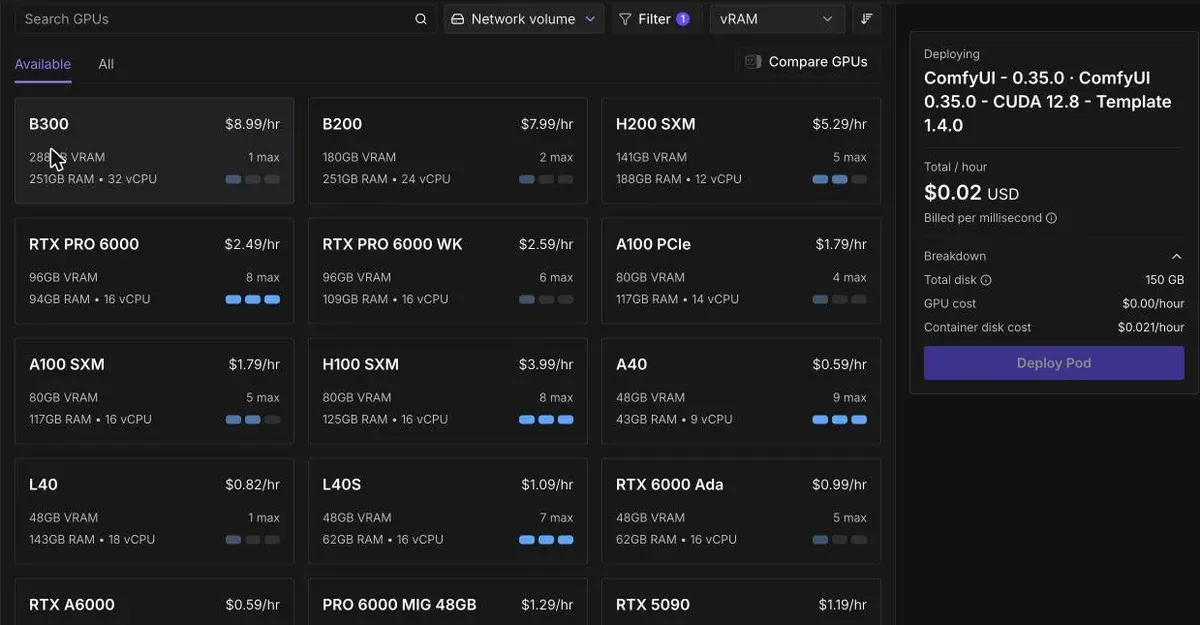
- Encontre o template. No console da Runpod, abra Pods, depois Deploy, e busque por “comfyui”. Escolha “One Click - ComfyUI Wan2.1 - Wan 2.2” entre os templates da comunidade, ao lado do oficial.
-
Ative o download do Wan 2.2. Abra Edit Template antes de fazer o deploy. Todas as flags de download começam como false, então defina
download_wan22como true,download_wan21também se quiser os workflows do Wan 2.1, edownload_wan_animatepara animação de personagens. -
Escolha uma placa compatível com CUDA 13. O guia da Runpod diz que o template “foi feito para CUDA 13.0 ou superior”; CUDA é a camada de drivers da GPU. Filtre a lista por versão do CUDA. Na nossa conta, a versão de CUDA fixada em um template foi uma das causas do erro “no instances available”.
-
Faça o deploy e espere a primeira inicialização. O pod baixa os modelos antes de o ComfyUI abrir. Depois, clique em Connect e abra o link do ComfyUI.
-
Carregue um workflow do Wan 2.2 e execute. O template já vem com os workflows prontos: basta definir o prompt ou a imagem, o tamanho e a duração do clipe e colocar na fila.

- Pare o pod quando os clipes estiverem salvos. Ele cobra por segundo enquanto estiver ligado, mesmo parado.
O caminho do template oficial do ComfyUI
O template oficial entrega um ComfyUI limpo, e você adiciona os arquivos do Wan por conta própria. Na primeira vez demora mais e deixa cada arquivo por sua conta.
-
Faça o deploy do template oficial do ComfyUI na mesma lista, ou da Blackwell Edition em uma RTX 5090. Defina o disco do contêiner em 50 GB; na nossa conta, esse valor funcionou, enquanto o padrão de 150 GB muitas vezes não encontrava placa.
-
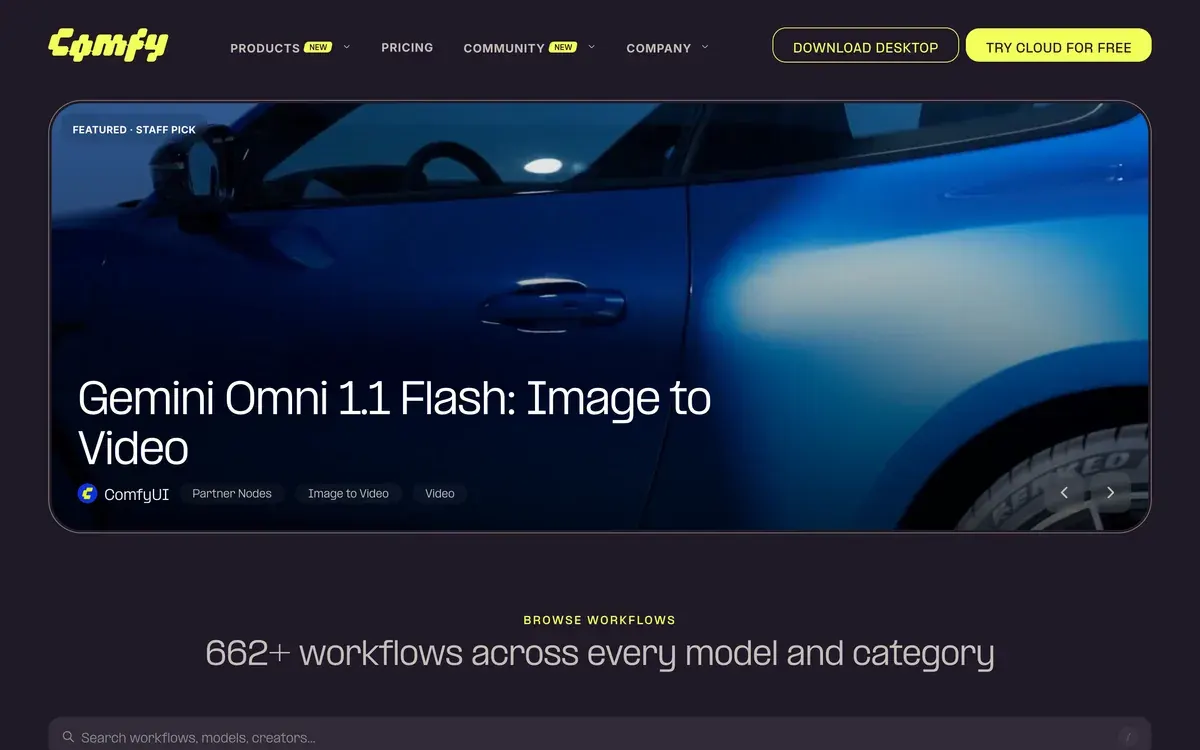
Abra a biblioteca de templates. No ComfyUI, busque “Wan2.2 5B” na Template Library. Se nada aparecer, a documentação do ComfyUI diz que sua versão está desatualizada. Os mesmos workflows estão na galeria pública do comfy.org, com busca por modelo.
-
Coloque cada arquivo na sua pasta. Para o modelo de 5B, a documentação do ComfyUI lista
wan2.2_ti2v_5B_fp16.safetensorsemmodels/diffusion_models/,wan2.2_vae.safetensorsemmodels/vae/eumt5_xxl_fp8_e4m3fn_scaled.safetensorsemmodels/text_encoders/(documentação do ComfyUI sobre o Wan 2.2). -
Defina o tamanho e a duração no nó
Wan22ImageToVideoLatent. Nos modelos de 14B, é o nóEmptyHunyuanLatentVideo. -
Execute a fila e salve o clipe. Depois, pare o pod.
Para o LTX-2, o mesmo template oficial serve. Instale os nós LTXVideo pelo ComfyUI Manager, como a ficha do modelo recomenda. Depois, carregue um workflow de texto para vídeo ou de imagem para vídeo em Template Library e, em seguida, Video.
LTX-2 in ComfyUI
Go to Template Library > Video > choose any LTX-2 workflow

Dá para rodar o Wan 2.2 no ComfyUI no Google Colab?
Não de forma confiável no plano gratuito. A FAQ do Google proíbe o uso de interface web em ambientes gratuitos e diz que eles costumam ser encerrados (FAQ do Colab). O ComfyUI é uma interface web. Um pod alugado não tem essa regra, e a GPU só é cobrada enquanto o pod está ligado.
Nossa central da Runpod reúne as outras páginas sobre a Runpod, e a tabela de preços de GPU na nuvem compara essas placas entre as nuvens de GPU.
Perguntas sobre o Wan 2.2 e o LTX-2 na Runpod
Qual GPU preciso para o Wan 2.2 no ComfyUI?
Uma placa de 24 GB, como a RTX 4090, roda o modelo de 5B a 720P e os modelos de 14B em fp8 a 480p. A 720p, os modelos de 14B pedem 48 GB em fp8, ou 80 GB ou mais no tamanho completo, em uma única placa.
Posso usar vídeos do Wan 2.2 em anúncios pagos?
Sim. O Wan 2.2 usa a licença Apache 2.0, que permite uso comercial. A Runpod só aluga a placa, então quem rege os clipes é a licença do modelo.
O LTX-2 é gratuito para uso comercial?
Sim, para receita anual abaixo de US$ 10.000.000 somando todo o seu grupo, respeitando a lista de usos proibidos. Acima disso, a licença da Lightricks exige uma licença comercial paga.
Quanto tempo leva um clipe do Wan 2.2 em uma GPU alugada?
O guia da Runpod indica cerca de 71 segundos para um clipe de 5 segundos em 640 por 640, em uma RTX 4090D com o Lightning LoRA. Com os 20 passos padrão, leva cerca de 513 segundos.
O template também roda o Wan 2.1?
Sim. O Wan 2.1 é a geração anterior, e o template da HearmemanAI baixa os workflows dele quando você define download_wan21 como true. Comece pelo 2.2, o modelo mais novo.
Fontes
- GitHub: Wan2.2, Apache 2.0; o TI2V-5B gera 720P a 24 FPS em uma GPU com pelo menos 24 GB, um vídeo de 5 segundos em 720P em menos de 9 minutos em uma GPU de consumo; o A14B e o S2V pedem pelo menos 80 GB em uma GPU; no ComfyUI desde 28 de julho de 2025. Verificado em
- Documentação do ComfyUI: Wan2.2 Video Generation ComfyUI Official Native Workflow Example, a versão de 5B deve caber bem em 8 GB de VRAM com o offloading nativo do ComfyUI; arquivos e pastas do modelo; templates encontrados na busca da Template Library. Verificado em
- Runpod: Wan 2.2 no ComfyUI na Runpod (atualizado em 22 de outubro de 2026), template de um clique da HearmemanAI, flags de download download_wan22, download_wan21 e download_wan_animate, todas false por padrão; CUDA 13.0 ou superior; faixas de VRAM por GPU; clipe de 5 segundos em 640x640 em uma RTX 4090D em cerca de 71 segundos com o Lightning LoRA, ou 513 com 20 passos, execuções aquecidas; benchmark da Alibaba em 720p com 17.4 minutos em uma H100, script de referência com 40 passos, duração do clipe não informada; a Runpod mantém esse dado separado dos tempos do ComfyUI. Verificado em
- Lightricks no Hugging Face: LTX-2.3, vídeo e áudio sincronizados em um só modelo; nós LTXVideo nativos no ComfyUI; versão destilada com 8 passos. Verificado em
- Lightricks no GitHub: LTX-2 Community License Agreement (5 de janeiro de 2026), cobre todas as versões do LTX-2 lançadas desde 5 de janeiro de 2026, a licença citada na ficha do modelo LTX-2.3; entidades com receita anual de pelo menos US$ 10 milhões precisam de licença de uso comercial paga; o Anexo A lista os usos proibidos; a Lightricks não reivindica direitos sobre os resultados. Verificado em
- MiniMax no Hugging Face: MiniMax H3 Community License Agreement, o território aplicável é o mundo todo, exceto a União Europeia, o Reino Unido, a República da Coreia e os Estados Unidos. Verificado em
- NVIDIA: Guia de início rápido do LTX-2 no ComfyUI (5 de janeiro de 2026, edição em espanhol), uma RTX 5090 com 32 GB gera um clipe de 720p, 24 fps e 4 segundos dentro da memória da GPU em cerca de 25 segundos; um clipe de 8 segundos leva cerca de três minutos. Verificado em
- Runpod: Preços da Runpod (atualizado em 8 de outubro de 2026), RTX 4090: US$ 0,89 por hora na Secure e US$ 0,34 na Community; RTX 5090: US$ 1,19 e US$ 0,69; L40S: US$ 1,09 e US$ 0,79; RTX PRO 6000: US$ 2,49 e US$ 1,69; H100 SXM: US$ 3,99 e US$ 2,69. Verificado em
- Google: FAQ do Colab, usar uma interface web em vez do notebook é proibido em ambientes gratuitos, que costumam ser encerrados quando usados para rodar uma interface web de geração de conteúdo. Verificado em

Alexandre S.
Alexandre S. é estrategista criativo de anúncios e redator publicitário, com dez anos de experiência em marketing digital em vários canais.
Páginas relacionadas
-
 Guia Wan no Higgsfield
O Higgsfield roda seis modelos de vídeo Wan. Um clipe de 5 segundos do Wan 3.0 a 720p custa 8.75 créditos, perto do preço da Alibaba. Quando o Wan supera o Kling ou o Seedance, e os passos.
-
 Categoria Melhores geradores de vídeo com IA para anúncios
23 geradores de vídeo com IA e plataformas multimodelo comparados em custo por clipe e termos de uso em anúncios, verificados em 25 de setembro de 2026.
-
 Perfil Runpod
Runpod para imagens e vídeos de anúncios: Secure ou Community Cloud, Pods ou Serverless, licenças de modelos e o que 48 fontes de usuários relatam. Verificado em 24 de out. de 2026.
-
 Alternativas Alternativas à Runpod
Vast.ai, Modal, Lambda, TensorDock, Massed Compute, Paperspace e Comfy Cloud comparados com a Runpod nos preços de RTX 4090, 5090 e H100, verificados em 24 de outubro de 2026.


