Preços de GPU na nuvem para imagens e vídeos com IA
Uma GPU na nuvem é uma placa de vídeo no data center de outra empresa que você aluga por hora para rodar modelos de IA. A VRAM, a memória da própria placa, decide quais modelos cabem.
Entre oito nuvens de GPU lidas em 24 de outubro de 2026, a Community Cloud da Runpod tem o menor preço para uma RTX 4090, a US$ 0,34 por hora. A H100 PCIe, a US$ 1,99, é a mais barata por um centavo.
Os hosts verificados mais baratos da Vast.ai ficam abaixo de todos os preços de tabela na 5090, na L40S, na A100 e na RTX PRO 6000. A RTX PRO 6000 sai por US$ 1,08, contra US$ 1,69 na Runpod. Os números da Vast.ai consideram só hosts verificados.
Na nossa própria conta da Runpod, em 17 de outubro de 2026, uma imagem de 1280 x 1280 do FLUX 3 Klein levou cerca de 28.5 segundos em uma RTX 4090 da Secure Cloud. Pela tarifa desse nível, isso custa US$ 0,007 de tempo de GPU por imagem.
| Provedor e nível | RTX 4090 (24 GB) | RTX 5090 (32 GB) | L40S (48 GB) | A100 (80 GB) | H100 (80 GB) | RTX PRO 6000 (96 GB) |
|---|---|---|---|---|---|---|
| Runpod Community Cloud Preço de tabela; A100 SXM, H100 PCIe | US$ 0,34 | US$ 0,69 | US$ 0,79 | US$ 1,39 | US$ 1,99 | US$ 1,69 |
| Runpod Secure Cloud Preço de tabela; A100 SXM, H100 PCIe | US$ 0,89 | US$ 1,19 | US$ 1,09 | US$ 1,79 | US$ 2,89 | US$ 2,49 |
| Runpod Serverless Worker Flex, só roda quando há uma requisição | US$ 1,34 | US$ 1,79 | US$ 1,75 | US$ 2,72 | US$ 5,39 | US$ 3,49 |
| Vast.ai, menor preço verificado Marketplace; H100 PCIe, RTX PRO 6000 WS | US$ 0,41 | US$ 0,64 | US$ 0,74 | US$ 1,07 | US$ 2,00 | US$ 1,08 |
| Vast.ai, mediana verificada Marketplace; a oferta do meio | US$ 0,67 | US$ 1,03 | US$ 0,80 | US$ 1,12 | US$ 2,33 | US$ 1,83 |
| TensorDock Preço típico, varia conforme o host; A100 PCIe, H100 SXM5 | US$ 0,35 | Não listado | Não listado | US$ 1,50 | US$ 2,25 | Não listado |
| Massed Compute Preço de tabela; H100 80 GB | Não listado | Não listado | US$ 0,97 | US$ 1,35 | US$ 2,73 | US$ 2,19 |
| Modal Tarifa por segundo vezes 3.600; H100 SXM5 | Não listado | Não listado | US$ 1,95 | US$ 2,50 | US$ 3,95 | US$ 3,03 |
| Lambda Preço de tabela; H100 PCIe | Não listado | Não listado | Não listado | Não listado | US$ 3,29 | Não listado |
| DigitalOcean GPU Droplets Preço de tabela; HGX H100 | Não listado | Não listado | US$ 1,57 | Não listado | US$ 4,41 | Não listado |
| Paperspace Preço promocional sob demanda | Não listado | Não listado | Não listado | Não listado | US$ 5,95 | Não listado |
Role para o lado para ver as 7 colunas
Por que a mesma H100 custa três vezes mais conforme a nuvem
A diferença vem de quem é dono da máquina e de por quanto tempo você se compromete. Uma H100 vai de US$ 1,99 por hora na Community Cloud da Runpod a US$ 5,95 na Paperspace sob demanda.
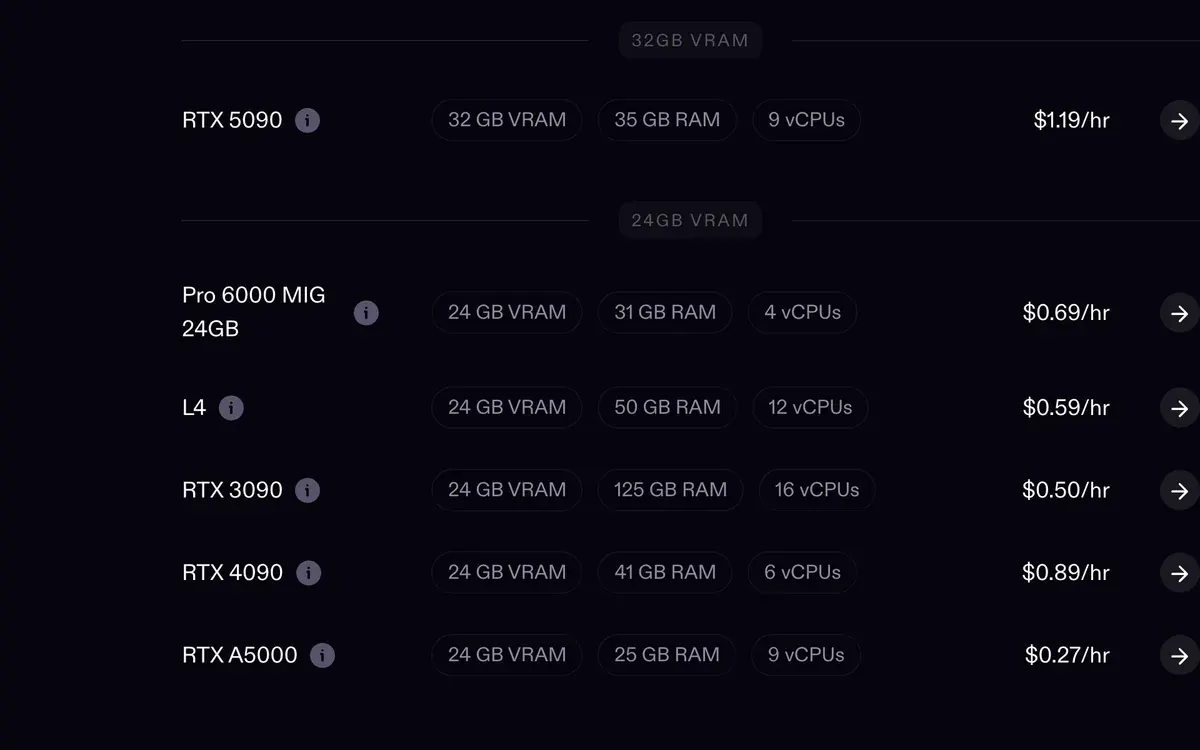
A Community Cloud da Runpod e a Vast.ai alugam máquinas de hosts terceiros. A documentação Choose a Pod da Runpod classifica a confiabilidade da Community Cloud como “Variable”, e a Runpod não aceita mais novos hosts na Community Cloud.

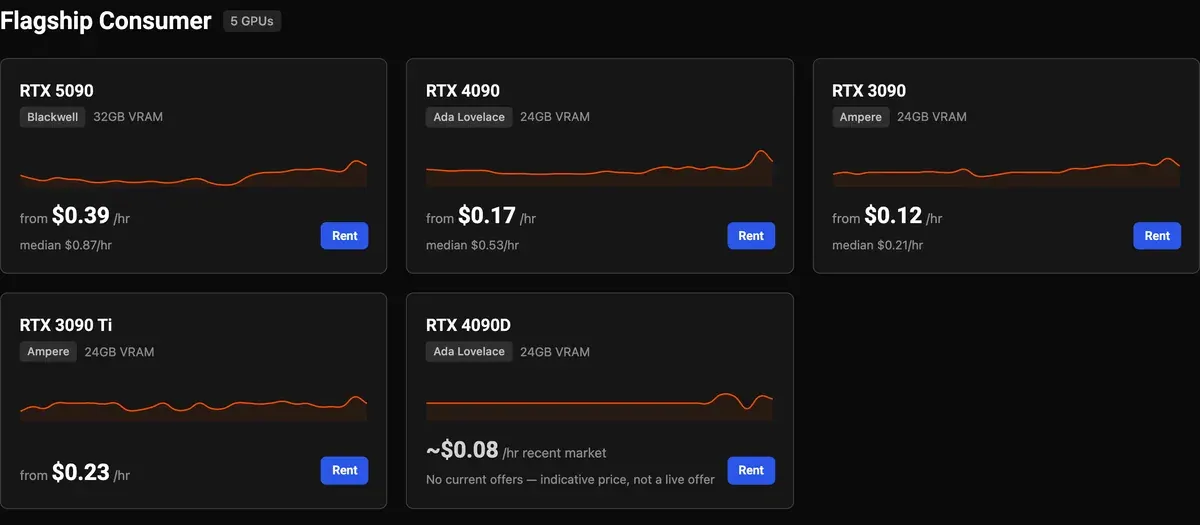
Os hosts da Vast.ai definem os próprios preços: suas 39 ofertas verificadas de RTX 4090 foram de US$ 0,41 até um preço mediano de US$ 0,67.
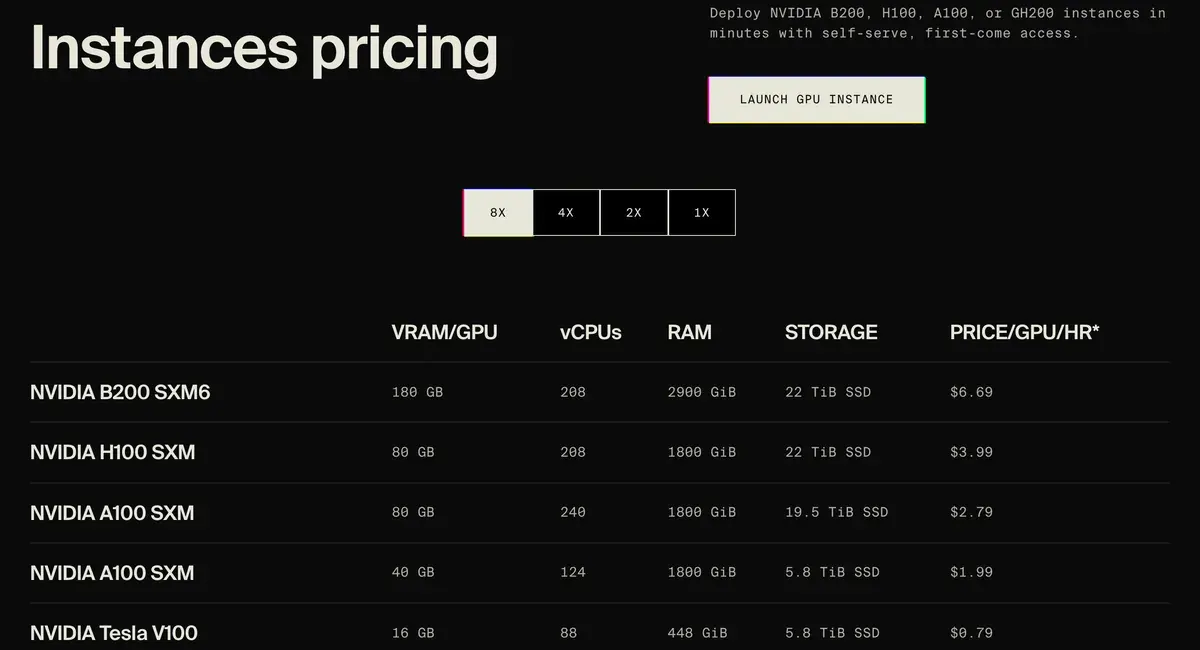
O compromisso é a segunda alavanca. A Paperspace mostra uma A100 a US$ 1,15 por hora, e só em contrato de três anos. A Lambda só lista a A100 SXM de 80 GB em máquinas de oito placas, a US$ 2,79 por placa.
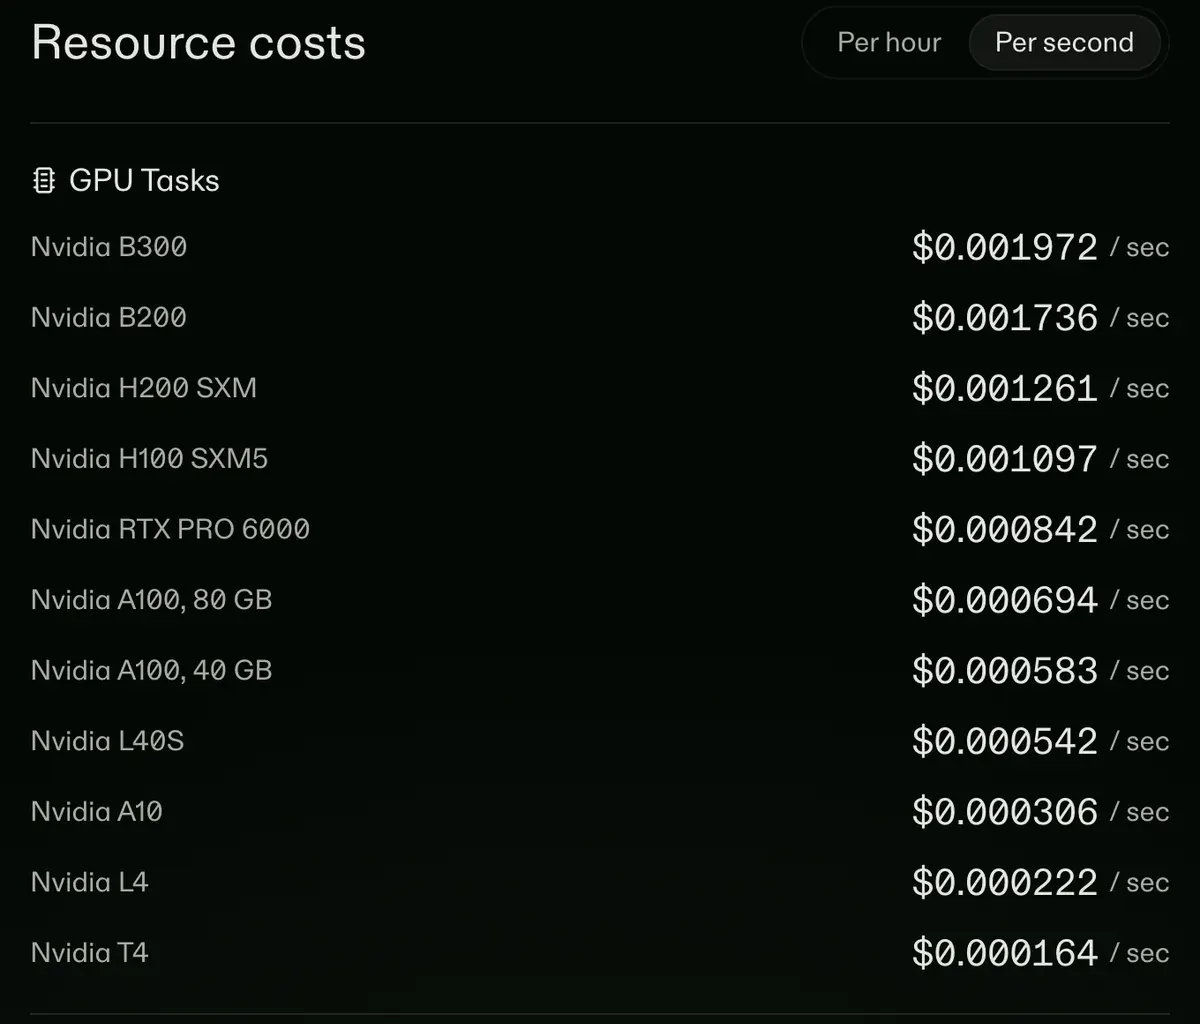
O serverless custa mais por hora e menos por mês quando as requisições são raras. O worker flex da Runpod cobra do início ao fim da execução e escala a zero entre os jobs (preços da Runpod). A Modal cobra cada segundo em que uma função roda, sem custo entre requisições: a tarifa da H100, de US$ 0,0011 por segundo, equivale a US$ 3,95 por hora (preços da Modal).
Quanto custa uma imagem ou um clipe
O preço por hora diz pouco até você saber a velocidade da placa. O número útil é o custo por geração: o preço por hora dividido pelo número de resultados concluídos em uma hora.
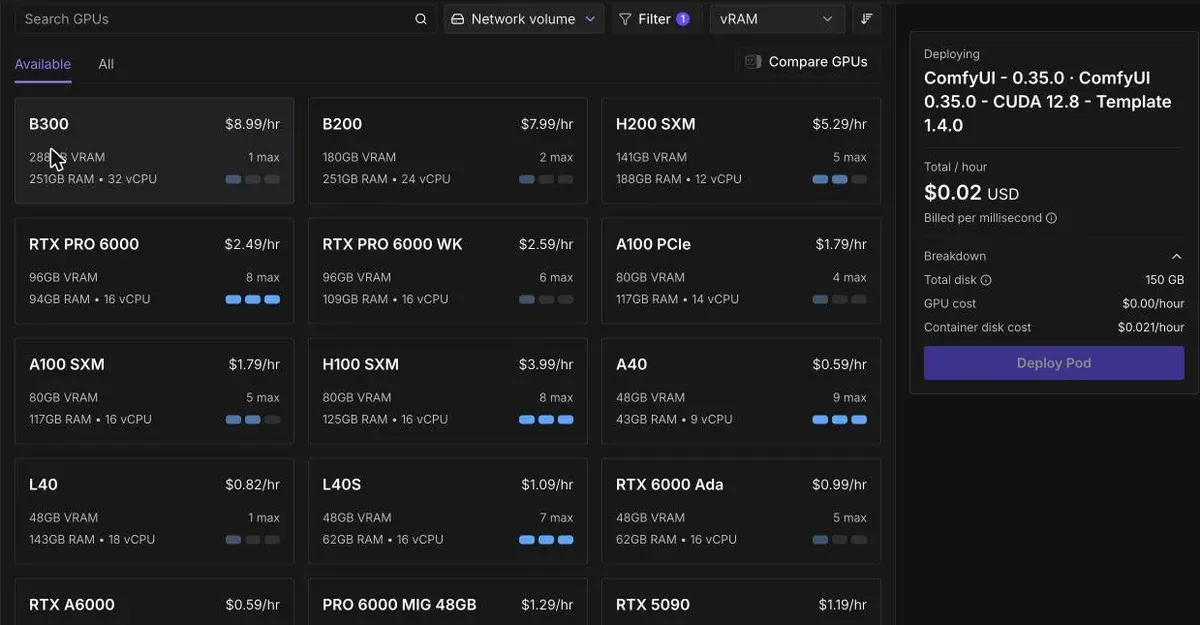
Na nossa própria conta da Runpod, em 17 de outubro de 2026, uma RTX 4090 na Secure Cloud gerou 12 imagens do FLUX 3 Klein em 342 segundos. Cada uma tinha 1280 x 1280 com 16 passos, cerca de 28.5 segundos por imagem.
A tabela abaixo aplica esse tempo a cada tarifa da 4090. Todas as linhas partem dos 28.5 segundos medidos na Secure Cloud.
| Onde a 4090 roda | Por hora | Por 100 imagens |
|---|---|---|
| Runpod Community Cloud | US$ 0,34 | US$ 0,27 |
| TensorDock, preço típico | US$ 0,35 | US$ 0,28 |
| Vast.ai, menor preço verificado | US$ 0,41 | US$ 0,32 |
| Runpod Secure Cloud, medido | US$ 0,89 | US$ 0,70 |
| Runpod Serverless | US$ 1,34 | US$ 1,06 |
Role para o lado para ver as 3 colunas
As configurações mudam a conta mais do que a nuvem. O modelo FLUX 3 Klein completo, com 50 passos, levou cerca de 4 minutos por imagem no mesmo pod, a US$ 0,06 cada.
Esses valores são só tempo de GPU. Iniciar o pod, carregar o modelo e o armazenamento entram por cima. Nossa análise dos preços da Runpod soma tudo isso.
Para vídeo, cronometre um clipe no seu próprio pod e divida. O Wan 2.2 hospedado pela própria Runpod gera um clipe de 5 segundos em 720p por US$ 0,30 (preços da Runpod). Uma 5090 alugada a US$ 1,19 só sai mais barata se cada clipe levar menos de 15 minutos (1.19 dividido por 0.30 dá 3.97 clipes por hora).
Qual GPU para qual trabalho
A VRAM é o primeiro filtro. Um modelo que não cabe transborda para a memória principal do computador (offloading), o que funciona, mas fica mais lento.
| Função | VRAM necessária | Placas que servem |
|---|---|---|
| Imagens para anúncios com FLUX ou modelos de imagem parecidos | Modelos de 6 a 17 GB, na nossa própria conta da Runpod | RTX 4090 ou 5090 |
| Vídeo Wan 2.2 5B | Cabe em 8 GB com o offloading do ComfyUI, segundo a documentação do ComfyUI | Qualquer placa da tabela; a RTX 4090 é a mais barata |
| Modelos de vídeo grandes perto de 40 GB | Mais do que os 32 GB de uma 5090, na nossa própria conta da Runpod | L40S, A100 ou RTX PRO 6000 |
Role para o lado para ver as 3 colunas
Um modelo de vídeo de cerca de 40 GB estoura uma 5090 e passa a fazer offload. Na nossa própria conta, esse estouro é o motivo de uma placa de 96 GB poder custar menos por clipe, apesar do preço por hora mais alto. O model card do Wan 2.2 diz que a versão de 5B “também pode rodar em placas de vídeo de consumo como a 4090” (Hugging Face).
Configurações passo a passo estão em Wan 2.2 na Runpod com ComfyUI e ComfyUI na Runpod. Nossa central da Runpod reúne o resto.
A licença do modelo vale em qualquer aluguel
A nuvem aluga hardware; é a licença do modelo que define se o resultado pode virar anúncio. O Wan 2.2 usa Apache 2.0. O LTX-2 exige licença paga quando a empresa fatura US$ 10.000.000 por ano ou mais (licença, seção 2.1).
A licença do MiniMax H3 exclui os EUA, a União Europeia, o Reino Unido e a Coreia do Sul; por isso, os clipes não podem rodar como anúncios nesses lugares, seja qual for a GPU usada para gerá-los. Hospedagens mais baratas para o mesmo trabalho estão comparadas em alternativas ao Runpod.
Como a tabela foi montada
Um preço entra na tabela quando a página ou a API do próprio provedor o mostra, para uma placa sob demanda, lido em 24 de outubro de 2026. “Não listado” significa que essa página não mostra preço sob demanda de uma única placa para aquela GPU.
Os preços da Vast.ai vêm da busca pública de ofertas: ofertas verificadas, alugáveis, de GPU única e sob demanda, ordenadas pelo preço total por hora com o disco padrão. A Modal publica tarifas por segundo; a tabela multiplica por 3.600. A página da TensorDock mostra um preço típico, que varia conforme o host, e diz ter sido atualizada em 24 de julho de 2024.
Cada linha tem uma âncora fixa, então um link como /data/cloud-gpu-prices/#runpod-community não muda. As correções aparecem na lista de alterações desta página e em atualizações e correções.
Como citar estes dados
adtestbench, “Preços de GPU na nuvem para imagens e vídeos com IA”, https://adtestbench.com/data/cloud-gpu-prices/, atualizado em .
- Arquivo CSV /data/cloud-gpu-prices.csv
Fontes
- Runpod: Runpod pricing, tarifas de Secure Cloud, Community Cloud e Serverless; a API de tipos de GPU, consultada em nossa própria conta, trouxe os mesmos valores. Verificado em
- Vast.ai: Vast.ai offer search API, ofertas verificadas, alugáveis, de GPU única e sob demanda; o preço total por hora inclui o disco padrão. Verificado em
- Vast.ai: Vast.ai pricing, preços definidos pelos hosts. Verificado em
- Lambda: Lambda GPU cloud pricing, preço por GPU por hora, cobrado por minuto, mais imposto sobre vendas ou IVA. Verificado em
- Modal: Modal pricing, tarifas de GPU por segundo. Verificado em
- TensorDock: TensorDock cloud GPUs, preço típico por hora, varia conforme o host, cobrado por segundo; página atualizada em 24 de julho de 2024. Verificado em
- Massed Compute: Massed Compute pricing. Verificado em
- DigitalOcean: DigitalOcean GPU Droplets pricing, cobrado por segundo, mínimo de 5 minutos. Verificado em
- Paperspace (DigitalOcean): Paperspace pricing, H100 sob demanda a preço promocional; tarifa do A100 exibida apenas com contrato de três anos. Verificado em
- ComfyUI docs: Wan2.2 in ComfyUI, o modelo de 5B e o offloading nativo. Verificado em
- Runpod docs: Choose a Pod, confiabilidade da Community Cloud: variável; não há novos hosts Community. Verificado em
- Wan-AI on Hugging Face: Wan2.2 TI2V-5B model card, Apache 2.0; roda em placas de nível consumidor, como a 4090. Verificado em
- Lightricks on GitHub: LTX-2 Community License Agreement, seção 2.1. Verificado em
O que mudou nesta página
- A Runpod aumentou os preços flex do Serverless em 30 de outubro de 2026 (4090 PRO a US$ 1,34 por hora, 5090 PRO a US$ 1,79, H100 PRO a US$ 5,39); a linha do Serverless e o custo de 100 imagens acompanham o aumento. As demais linhas seguem como em 24 de outubro de 2026.

Alexandre S.
Alexandre S. é estrategista criativo de anúncios e redator publicitário, com dez anos de experiência em marketing digital em vários canais.
Páginas relacionadas
-
 Dados Monitor de preços de ferramentas de IA para anúncios
69 de 82 ferramentas de IA para anúncios mostram preço de tabela lido na página do próprio fornecedor, verificado pela última vez em 16 de outubro de 2026, com o custo por clipe ou imagem quando a tarifa permite calcular.
-
 Guia Fluxo de trabalho de influenciador de IA no ComfyUI
Os blocos do ComfyUI por trás de um influenciador de IA, a licença de cada modelo aberto, onde encontrar fluxos de trabalho e o custo da GPU alugada por imagem. Verificado em 24 de out. de 2026.
-
 Preços Preços do Higgsfield
Os planos do Higgsfield começam em US$ 19 por mês por 270 créditos, cerca de US$ 0,07 por crédito. O que o Unlimited cobre, o plano gratuito, o teste e os reembolsos. Verificado em 25 de out. de 2026.


