Runpod 上的 Wan 2.2 與 LTX-2
Wan 2.2 和 LTX-2 都是開源影片模型。你下載模型檔案,自己在 ComfyUI 裡用自有或租來的顯示卡執行。Runpod 就是按秒出租這類顯示卡的服務。
Wan 2.2 的小型 5B 模型和 LTX-2,用 24 或 32 GB 的顯示卡就跑得動,也就是 RTX 4090 或 RTX 5090。在 720p 下,Wan 的 14B 模型用較輕量的 fp8 格式要 48 GB;用完整大小則要 80 GB 以上,例如 96 GB 的 RTX PRO 6000。
根據公布的生成時間推算,一支短影片的 GPU 成本從不到一美分到約一美元不等。約一美元那一端,是用Alibaba 的參考腳本算出來的。
| 模型 | 能做什麼 | 顯示記憶體(來源) | 適用的 Runpod 顯卡 | 廣告授權 |
|---|---|---|---|---|
| Wan 2.2 TI2V-5B | 文字或圖片生成影片,720P、24 FPS | 24 GB(Wan 團隊),搭配卸載(offloading)約 8 GB(ComfyUI) | RTX 4090,24 GB | Apache 2.0 |
| Wan 2.2 T2V 與 I2V A14B | 文字生成影片、圖片生成影片,480P 與 720P | 單張 GPU 需 80 GB(Wan 團隊);480p 下用 fp8 需 24 GB(Runpod) | RTX PRO 6000,96 GB,適用 720p | Apache 2.0 |
| LTX-2 與 LTX-2.3 | 影片與同步音訊 | 32 GB 內可跑 720p、4 秒的影片(NVIDIA) | RTX 5090,32 GB | 年營收低於 10,000,000 美元可免費使用 |
左右滑動查看全部 5 欄
Wan 2.2 與 LTX-2 是什麼?
Wan 2.2 是 Alibaba 的開源影片模型系列。較新的版本 Wan 3.0 改成透過Alibaba Cloud 的 API 按秒販售。Wan 2.2 的 GitHub 頁面列出一個 5B 模型,可把文字或圖片變成 720P 影片(Wan2.2 on GitHub)。它的 14B 模型則涵蓋文字生成影片、圖片生成影片、語音生成影片和角色動畫。
「B」代表十億個參數,是衡量模型大小的粗略指標。模型越大,需要的顯示記憶體(VRAM)越多,租顯卡時最關鍵的就是這個數字。
LTX-2 是 Lightricks 的開源模型,2.3 版可以一次生成影片和聲音。LTX-2.3 的模型卡寫道,它「設計用途是在單一模型內生成同步的影片與音訊」,並指引 ComfyUI 使用者使用內建的 LTXVideo 節點。

兩者都能在 ComfyUI 裡執行。ComfyUI 是一套免費軟體,工作流程的每個步驟都是畫布上的一個方塊,再一個接一個連起來。Wan 2.2 自 2025 年 7 月 28 日起已支援 ComfyUI。
Wan 2.2 與 LTX-2 的影片可以用在廣告嗎?
兩者都可以,但 LTX-2 有一項營收條件,並列有禁止用途清單。Runpod 只出租硬體,影片能怎麼用,要看模型本身的授權。
Wan 2.2 採用 Apache 2.0 授權,這是允許商業使用的寬鬆授權。Wan 團隊的程式庫寫明:「本程式庫中的模型採用 Apache 2.0 授權」。
Licence
Licence The models in this repository are licensed under the Apache 2.0 License.
Outputs We claim no rights over the your generated contents, granting you the freedom to use them.
5B model The TI2V-5B model can also run on consumer-grade graphics cards like 4090.
LTX-2 採用 LTX-2 Community License Agreement(社群授權協議),日期為 2026 年 1 月 5 日。協議允許「用於任何目的」,但須遵守附件 A 列出的禁止用途,例如未經同意製作的深偽影片。自該日起發布的每個 LTX-2 版本都適用,包括 LTX-2.3。
做廣告用途時,要檢查的就是營收門檻。年營收達 10,000,000 美元以上的實體,「必須取得付費商業使用授權」(LTX-2 授權)。
Section 2.1, grant of rights (dated 5 January 2026)
Entities with annual revenues of at least $10,000,000 (the “Commercial Entities”) are required to obtain a paid commercial use license in order to use LTX-2 and Derivatives of LTX-2.
門檻是以整個集團計算,含子公司。低於門檻的話,用在廣告免權利金,Lightricks 也「不對你生成的輸出內容主張任何權利」。
MiniMax H3 的開源授權把美國、歐盟、英國和南韓排除在外(MiniMax H3 授權)。這些地區的廣告用途,就不要列入考慮。
需要多少 VRAM?Runpod 該選哪張 GPU?
先依顯示卡的記憶體選好模型和解析度,再比價格。模型放不下時,ComfyUI 會把一部分移到 pod 的一般記憶體,雖然還能跑,但速度會慢很多。
Wan2.2 in ComfyUI
Templates Workflows in this guide can be found in the Workflow Templates.
5B memory The Wan2.2 5B version should fit well on 8GB vram with the ComfyUI native offloading.
Licence The Wan2.2 series models are based on the Apache 2.0 open source license and support commercial use.
Runpod 自己的 Wan 2.2 指南(2026 年 10 月 22 日更新)依工作類型列出了記憶體等級(Runpod 的 Wan 2.2 指南)。表中的費率來自 Runpod 價格頁。
| 工作 | 記憶體 | 顯卡 | Secure Cloud 每小時 | Community Cloud 每小時 |
|---|---|---|---|---|
| TI2V-5B,1280 × 704 | 24 GB | RTX 4090 | $0.89 | $0.34 |
| fp8 版 14B,480p 或 640 × 640 | 24 GB | RTX 4090 | $0.89 | $0.34 |
| fp8 版 14B,較長影片或搭配 LoRA | 32 GB | RTX 5090 | $1.19 | $0.69 |
| 720p 的 fp8 版 14B | 48 GB | L40S | $1.09 | $0.79 |
| 720p 的 14B,不卸載 | 80 GB 以上 | RTX PRO 6000,96 GB | $2.49 | $1.69 |
左右滑動查看全部 5 欄
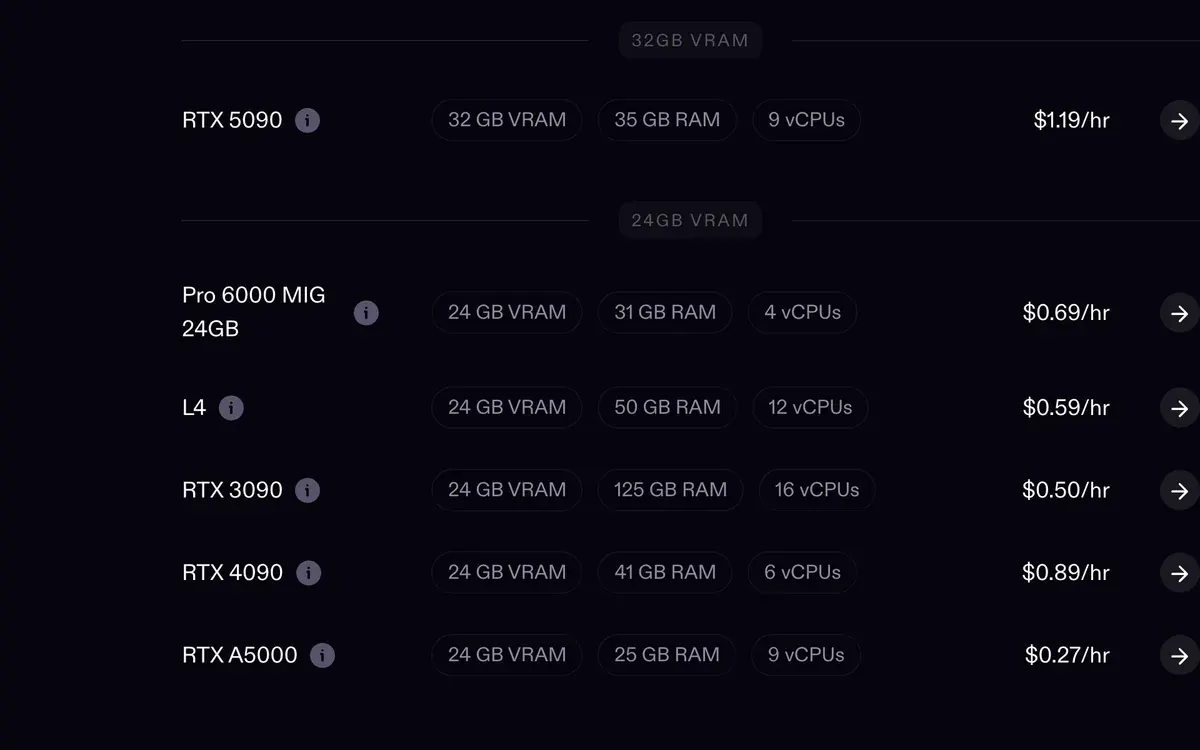
表中的 fp8 是比較輕量的檔案格式:模型的數值以較低精度儲存,所以記憶體用量約少一半。
從圖片模型這一側,我們自己的 Runpod 帳號也看到同樣的限制。6 到 17 GB 的圖片模型放在 5090 的 32 GB 上綽綽有餘;一個約 40 GB 的影片模型就會爆掉,只好卸載。
所以 96 GB 的顯卡,每支影片的成本可能比較便宜的顯卡還低,因為便宜的卡得靠卸載。
在 Runpod 上生成一支影片要多少錢?
從短的 LTX-2 影片不到一美分,到用 Alibaba 參考腳本生成 720p 的 Wan 14B 影片約一美元。下面每個數字都是算出來的:公布的生成時間乘以 Runpod 的每小時費率。
| 影片 | 公布的生成時間(來源) | 顯卡 | Secure Cloud | Community Cloud |
|---|---|---|---|---|
| LTX-2,4 秒,720p,24 fps | 約 25 秒(NVIDIA) | RTX 5090 | $0.008 | $0.005 |
| LTX-2,8 秒,720p | 約 3 分鐘(NVIDIA) | RTX 5090 | $0.06 | $0.03 |
| Wan 2.2 14B,5 秒,640 × 640,Lightning LoRA | 約 71 秒(Runpod,使用 RTX 4090D) | RTX 4090 | $0.018 | $0.007 |
| Wan 2.2 14B,5 秒,640 × 640,20 步 | 約 513 秒(Runpod,使用 RTX 4090D) | RTX 4090 | $0.13 | $0.05 |
| Wan 2.2 TI2V-5B,5 秒,720P | 9 分鐘內(Wan 團隊,消費級 GPU) | RTX 4090 | $0.13 | $0.05 |
| Wan 2.2 14B,720p,40 步,未說明影片長度 | 17.4 分鐘(Alibaba 基準測試) | H100 SXM | $1.16 | $0.78 |
左右滑動查看全部 5 欄
Runpod 是在熱啟動(模型已載入)的狀態下,用 RTX 4090D 量測出 71 秒和 513 秒的,這張卡是 4090 的出口版,核心數較少。這裡是以 4090 的費率計價。
NVIDIA 給的「8 秒影片三分鐘」,已經包含影片超出 32 GB 後變慢的部分。Wan 團隊的 9 分鐘是「不到」的數字,所以那一列是上限。第一支影片之前的模型載入時間同樣會計費,不在這幾列之內。
Lightning LoRA 是一個小型的附加檔案,能把 Wan 的取樣步數降到 4 步,同一支影片的時間就從約 513 秒縮短到約 71 秒。
為了方便比較,這是我們自己帳號上量到的數字:在 Secure Cloud 的 RTX 4090 上生成一張 FLUX 3 Klein fast 圖片,約需 28.5 秒,每張 0.007 美元。Runpod 上的 ComfyUI 指南有完整表格。
ComfyUI 跑 Wan,該選 RTX 5090 還是 RTX 4090?
5B 模型,以及 480p 的 14B,選 RTX 4090;24 GB 不夠用時,才改選 RTX 5090。5090 在 Secure Cloud 每小時約貴三分之一,所以只有多出來的 8 GB 能讓 ComfyUI 不用卸載時才划算。在 Community Cloud 上價格約是兩倍(0.69 美元 vs 0.34 美元)。
Runpod 的指南建議,5090 的 32 GB 適合需要餘裕的 14B 任務:較長的片段,或額外載入 LoRA。若是 LTX-2,建議租用 5090,NVIDIA 的 4 秒 720p 片段可以完整放進它的記憶體。
超過 32 GB 就兩張都別選。48 GB 的 L40S 每小時比 Secure Cloud 的 5090 便宜。要跑完整的 14B、720p,96 GB 的 RTX PRO 6000 能容納整個模型。
怎麼用 HearmemanAI 的範本設定 Wan 2.2
這條路線會在 Pod 第一次啟動時,替你下載模型和工作流程。它用的是 HearmemanAI 發布在 Runpod 的社群範本。記得掛上網路磁碟區(network volume,Runpod 的永久磁碟,Pod 刪除後仍會保留),下載就只需要做一次。
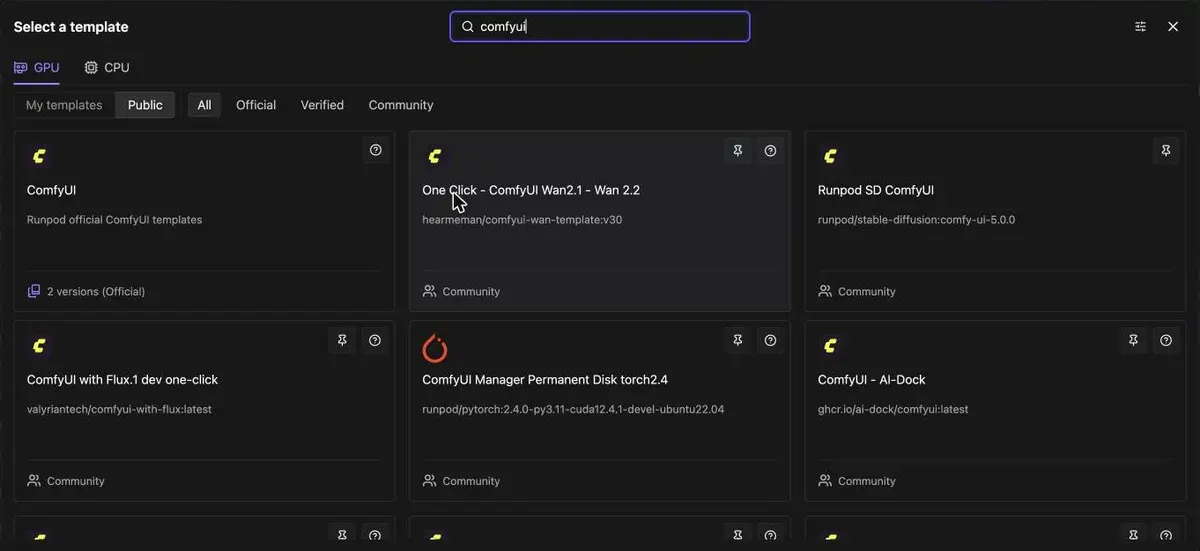
- 找到範本。在 Runpod 控制台依序開啟 Pods、Deploy,搜尋「comfyui」,然後在官方範本旁邊的社群範本中,選「One Click - ComfyUI Wan2.1 - Wan 2.2」。
-
啟用 Wan 2.2 的下載。部署前先開啟 Edit Template。所有下載開關預設都是 false,所以要把
download_wan22設為 true;如果也想要 Wan 2.1 的工作流程,就連download_wan21一起設;要做角色動畫,則設download_wan_animate。 -
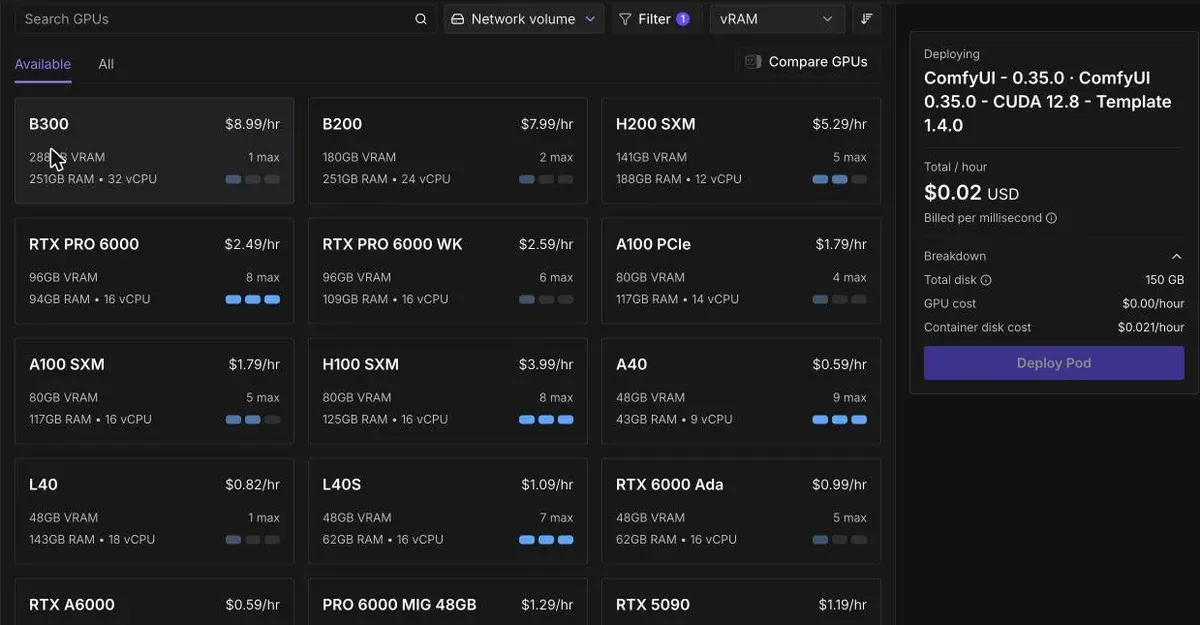
選擇支援 CUDA 13 的顯示卡。Runpod 的指南表示,這個範本「專為 CUDA 13.0 以上版本打造」,CUDA 是 GPU 的驅動層。選卡時可以用 CUDA 版本篩選。在我們的帳號上,範本鎖定的 CUDA 版本,是出現「no instances available」的原因之一。
-
按下 Deploy,等待第一次開機。Pod 會先下載模型,ComfyUI 才會開啟。之後點 Connect,開啟 ComfyUI 連結。
-
載入 Wan 2.2 工作流程並執行。範本已內建現成的工作流程,你只要設定提示詞或圖片、尺寸和片段長度,再加入佇列即可。

- 片段存好後就停止 Pod。只要 Pod 在運作,就按秒計費,閒置時也一樣。
ComfyUI 官方範本的做法
官方範本提供乾淨的 ComfyUI,Wan 的檔案要自己補。第一次會花比較久的時間,而且每個檔案都得自己管。
-
從同一個選單部署 ComfyUI 官方範本,若用 RTX 5090,就選它的 Blackwell Edition。把容器磁碟設為 50 GB:在我們的帳號上,這個容量能順利部署,而預設的 150 GB 常常找不到卡。
-
開啟範本庫。在 ComfyUI 的 Template Library 搜尋「Wan2.2 5B」。如果什麼都沒出現,ComfyUI 文件說明是你的 ComfyUI 版本過舊。comfy.org 的公開圖庫也有相同的工作流程,可以依模型搜尋。
-
把每個檔案放進對應的資料夾。以 5B 模型為例,ComfyUI 文件列出的對應是:
wan2.2_ti2v_5B_fp16.safetensors放在models/diffusion_models/、wan2.2_vae.safetensors放在models/vae/、umt5_xxl_fp8_e4m3fn_scaled.safetensors放在models/text_encoders/(ComfyUI Wan 2.2 文件)。 -
在
Wan22ImageToVideoLatent節點設定尺寸和長度。14B 模型則是在EmptyHunyuanLatentVideo節點。 -
執行佇列,存下片段,然後停止 Pod。
LTX-2 同樣可以用這個官方範本。照模型卡的建議,先從 ComfyUI Manager 安裝 LTXVideo 節點,再從 Template Library 的 Video 分類載入文字生成影片或圖片生成影片的工作流程。
LTX-2 in ComfyUI
Go to Template Library > Video > choose any LTX-2 workflow

Wan 2.2 能在 Google Colab 上用 ComfyUI 跑嗎?
免費版不穩定。Google 的 FAQ 把透過網頁介面操作列為免費運行環境不允許的用法,並表示這類環境經常被終止(Colab FAQ)。ComfyUI 正是網頁介面。租用的 Pod 沒有這種限制,GPU 也只在 Pod 運作期間計費。
其他 Runpod 相關頁面整理在 Runpod 專區,雲端 GPU 價格表則比較這些顯示卡在各家 GPU 雲端的價格。
Runpod 上的 Wan 2.2 與 LTX-2 常見問題
在 ComfyUI 跑 Wan 2.2 需要什麼 GPU?
像 RTX 4090 這種 24 GB 的卡,能以 720P 跑 5B 模型,也能以 fp8 跑 480p 的 14B 模型。若是 720p,14B 模型用 fp8 需要 48 GB;以完整精度在單張卡上跑,則需要 80 GB 以上。
Wan 2.2 的影片可以用在付費廣告嗎?
可以。Wan 2.2 採用 Apache 2.0 授權,允許商業用途。Runpod 只是出租顯示卡,所以片段適用的是模型本身的授權。
LTX-2 可以免費商用嗎?
可以,條件是整個集團的年營收低於 10,000,000 美元,且不得用於授權列出的禁止用途。超過這個金額,依 Lightricks 的授權就必須購買付費商用授權。
Wan 2.2 在租用的 GPU 上生成一支片段要多久?
Runpod 的指南給出的數字是:在 RTX 4090D 上搭配 Lightning LoRA,生成一支 5 秒、640×640 的片段約需 71 秒。用預設的 20 步,則約需 513 秒。
這個範本也能跑 Wan 2.1 嗎?
可以。Wan 2.1 是較早的世代,把 download_wan21 設為 true,HearmemanAI 的範本就會下載它的工作流程。建議先從較新的 2.2 開始。
資料來源
- GitHub:Wan2.2,Apache 2.0;TI2V-5B 在至少 24 GB 的 GPU 上可產出 720P、24 FPS 的影片,在單張消費級 GPU 上可於 9 分鐘內產出 5 秒、720P 的影片;A14B 與 S2V 在單張 GPU 上至少需要 80 GB;自 2025 年 7 月 28 日起支援 ComfyUI。確認於
- ComfyUI 文件:Wan2.2 Video Generation ComfyUI Official Native Workflow Example,搭配 ComfyUI 原生卸載(offloading),5B 版本應可順利跑在 8 GB VRAM 上;另列出模型檔案與資料夾,以及從 Template Library 搜尋範本的方式。確認於
- Runpod:Wan 2.2 in ComfyUI on Runpod(更新於 2026 年 10 月 22 日),HearmemanAI 一鍵範本,下載開關 download_wan22、download_wan21 和 download_wan_animate,預設全為 false;CUDA 13.0 以上;依 GPU 劃分的 VRAM 等級;在 RTX 4090D 上搭配 Lightning LoRA,生成 5 秒、640x640 的片段約需 71 秒,用 20 步則約需 513 秒,皆為暖機後的執行;Alibaba 的 720p 基準測試在單張 H100 上約需 17.4 分鐘,參考腳本為 40 步,未標明片段長度;Runpod 將這項數據與 ComfyUI 的耗時分開列示。確認於
- Hugging Face 上的 Lightricks:LTX-2.3,單一模型同步生成影片與音訊;ComfyUI 內建 LTXVideo 節點;蒸餾版本只需 8 步。確認於
- GitHub 上的 Lightricks:LTX-2 Community License Agreement(2026 年 1 月 5 日),涵蓋自 2026 年 1 月 5 日起發布的所有 LTX-2 版本,也是 LTX-2.3 模型卡所連結的授權;年營收達 10 百萬美元以上的實體,須取得付費商用授權;附件 A 列出禁止用途;Lightricks 不主張對產出內容的任何權利。確認於
- Hugging Face 上的 MiniMax:MiniMax H3 Community License Agreement,適用地區為全球,但不含歐盟、英國、南韓與美國。確認於
- NVIDIA:Quick start guide for LTX-2 in ComfyUI(2026 年 1 月 5 日,西班牙文版),配備 32 GB 的 RTX 5090 可在 GPU 記憶體內生成 720p、24 fps、4 秒的片段,約需 25 秒;8 秒的片段約需三分鐘。確認於
- Runpod:Runpod pricing(更新於 2026 年 10 月 8 日),RTX 4090 每小時 0.89 美元(Secure)、0.34 美元(Community);RTX 5090 為 1.19、0.69 美元;L40S 為 1.09、0.79 美元;RTX PRO 6000 為 2.49、1.69 美元;H100 SXM 為 3.99、2.69 美元。確認於
- Google:Colab FAQ,免費運行環境不允許繞過 notebook、改用網頁介面操作;用來跑內容生成的網頁介面時,常被終止。確認於

相關頁面
-
 指南 Higgsfield 上的 Wan
Higgsfield 提供六款 Wan 影片模型。一支 5 秒、720p 的 Wan 3.0 影片要 8.75 點,與阿里巴巴的定價相近。Wan 何時勝過 Kling 或 Seedance,以及操作步驟。
-
-
 工具介紹 Runpod
Runpod 用於廣告圖片與影片:Secure Cloud 或 Community Cloud、Pods 或 Serverless、模型授權,以及 48 個使用者來源的反映。確認於 2026 年 10 月 24 日。
-
 替代方案 Runpod 替代方案
Vast.ai、Modal、Lambda、TensorDock、Massed Compute、Paperspace 與 Comfy Cloud 對比 Runpod 的 RTX 4090、5090 與 H100 價格,2026 年 10 月 24 日查閱。


