Wan 2.2 y LTX-2 en Runpod
Wan 2.2 y LTX-2 son modelos de video abiertos. Descargas los archivos y los ejecutas tú mismo en ComfyUI, en una tarjeta gráfica propia o alquilada. Runpod alquila esas tarjetas por segundo.
El modelo pequeño de 5B de Wan 2.2 y LTX-2 caben en una tarjeta de 24 o 32 GB, la RTX 4090 o la RTX 5090. A 720p, los modelos de 14B de Wan piden 48 GB en el formato más ligero fp8. A tamaño completo piden 80 GB o más, como los 96 GB de la RTX PRO 6000.
Calculado a partir de tiempos de generación publicados, un clip corto cuesta desde menos de un centavo hasta alrededor de un dólar de tiempo de GPU. El dólar sale del script de referencia de Alibaba.
| Modelo | Qué genera | Memoria gráfica (fuente) | Tarjeta de Runpod que cabe | Licencia para anuncios |
|---|---|---|---|---|
| Wan 2.2 TI2V-5B | Texto o imagen a video, 720P a 24 FPS | 24 GB (equipo de Wan), unos 8 GB con descarga a CPU (ComfyUI) | RTX 4090, 24 GB | Apache 2.0 |
| Wan 2.2 T2V e I2V A14B | Texto a video, imagen a video, 480P y 720P | 80 GB en una sola GPU (equipo de Wan); 24 GB en fp8 a 480p (Runpod) | RTX PRO 6000, 96 GB, para 720p | Apache 2.0 |
| LTX-2 y LTX-2.3 | Video con sonido sincronizado | Un clip de 720p y 4 segundos dentro de 32 GB (NVIDIA) | RTX 5090, 32 GB | Gratis por debajo de $10,000,000 de ingresos anuales |
Desliza hacia los lados para ver las 5 columnas
¿Qué son Wan 2.2 y LTX-2?
Wan 2.2 es la familia de video abierta de Alibaba. Su versión más nueva, Wan 3.0, se vende por segundo mediante la API de Alibaba Cloud. La página de GitHub de Wan 2.2 lista un modelo de 5B que convierte texto o una imagen en video de 720P (Wan2.2 en GitHub). Sus modelos de 14B cubren texto a video, imagen a video, voz a video y animación de personajes.
La «B» son miles de millones de parámetros, una medida aproximada del tamaño del modelo. Los modelos más grandes necesitan más memoria gráfica, llamada VRAM, que es el número decisivo cuando alquilas una tarjeta.
LTX-2 es el modelo abierto de Lightricks, y su versión 2.3 genera video y sonido de una sola vez. La ficha del modelo LTX-2.3 dice que está «diseñado para generar video y audio sincronizados dentro de un único modelo», y remite a los usuarios de ComfyUI a los nodos LTXVideo integrados.

Los dos funcionan en ComfyUI, una aplicación gratuita donde cada paso del trabajo es una caja en un lienzo, conectada con la siguiente. Wan 2.2 está en ComfyUI desde el 28 de julio de 2025.
¿Se pueden usar clips de Wan 2.2 y LTX-2 en anuncios?
Sí en ambos, con una condición de ingresos y una lista de usos prohibidos en LTX-2. Runpod alquila el hardware, así que la propia licencia del modelo decide qué puedes hacer con los clips.
Wan 2.2 tiene licencia Apache 2.0, una licencia permisiva que permite el uso comercial. El repositorio del equipo de Wan dice: «Los modelos de este repositorio tienen licencia Apache 2.0».
Licence
Licence The models in this repository are licensed under the Apache 2.0 License.
Outputs We claim no rights over the your generated contents, granting you the freedom to use them.
5B model The TI2V-5B model can also run on consumer-grade graphics cards like 4090.
LTX-2 tiene la LTX-2 Community License Agreement, con fecha del 5 de enero de 2026. Concede el uso «para cualquier fin», sujeto a los usos prohibidos de su Attachment A, como los deepfakes hechos sin consentimiento. Cubre todas las versiones de LTX-2 publicadas desde esa fecha, incluida LTX-2.3.
Para el trabajo con anuncios, el límite de ingresos es la condición que hay que comprobar. Las entidades con ingresos anuales de al menos $10,000,000 «deben obtener una licencia de uso comercial de pago» (licencia de LTX-2).
Section 2.1, grant of rights (dated 5 January 2026)
Entities with annual revenues of at least $10,000,000 (the “Commercial Entities”) are required to obtain a paid commercial use license in order to use LTX-2 and Derivatives of LTX-2.
El umbral cuenta todo el grupo, filiales incluidas. Por debajo, el uso en anuncios está libre de regalías, y Lightricks «no reclama ningún derecho sobre el Output que generes».
La licencia abierta de MiniMax H3 excluye EE. UU., la UE, el Reino Unido y Corea del Sur (licencia de MiniMax H3). Para anuncios allí, queda fuera de la lista.
¿Cuánta VRAM necesitas y qué GPU de Runpod encaja?
Ajusta primero el modelo y la resolución a la memoria de la tarjeta, y luego compara precios. Cuando un modelo no cabe, ComfyUI mueve parte a la memoria ordinaria del Pod, lo que funciona pero va mucho más lento.
Wan2.2 in ComfyUI
Templates Workflows in this guide can be found in the Workflow Templates.
5B memory The Wan2.2 5B version should fit well on 8GB vram with the ComfyUI native offloading.
Licence The Wan2.2 series models are based on the Apache 2.0 open source license and support commercial use.
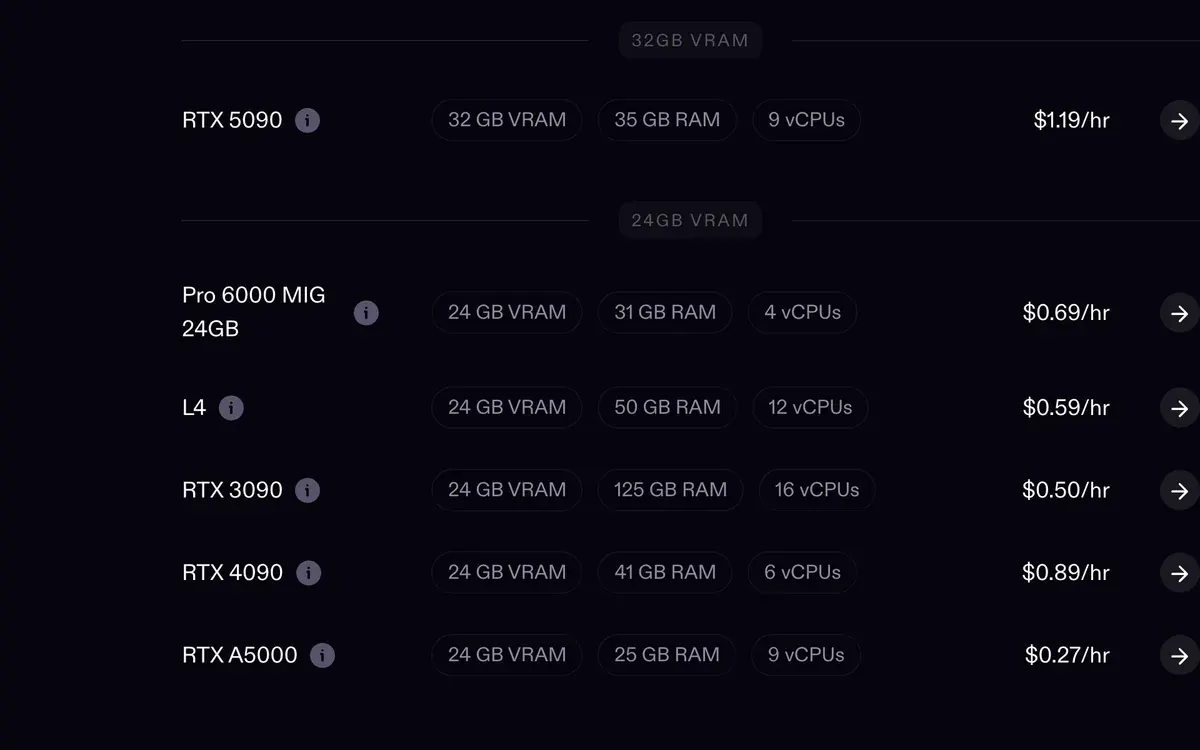
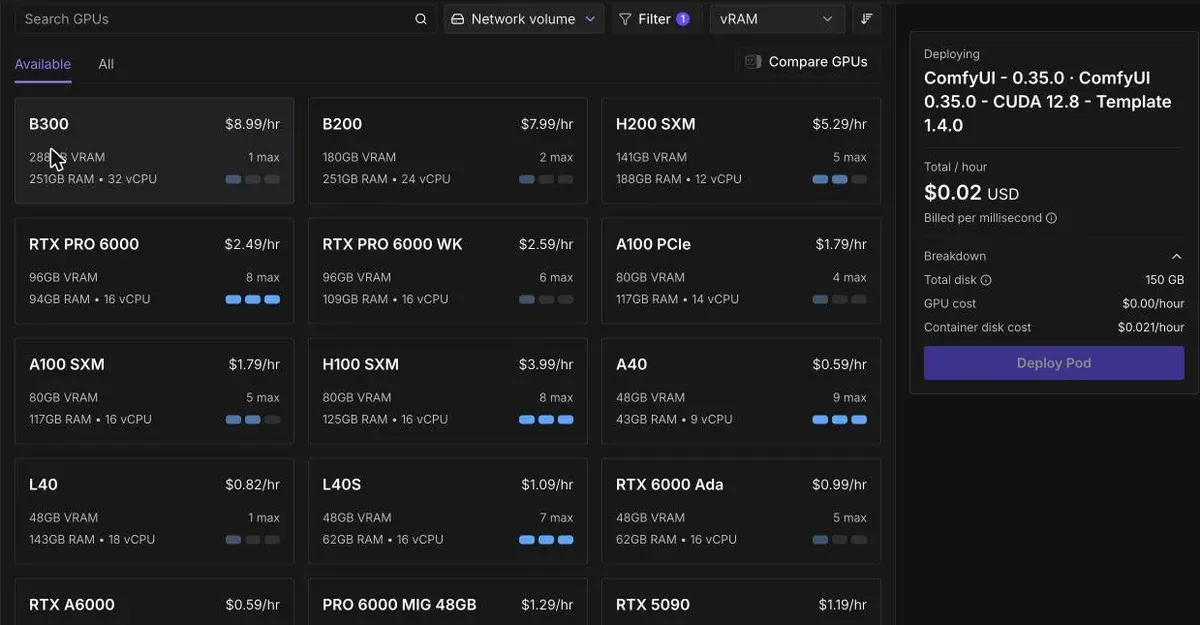
La propia guía de Wan 2.2 de Runpod, actualizada el 22 de octubre de 2026, da niveles de memoria según la tarea (guía de Wan 2.2 de Runpod). Las tarifas de la tabla salen de la página de precios de Runpod.
| Tarea | Memoria | Tarjeta | Secure Cloud por hora | Community Cloud por hora |
|---|---|---|---|---|
| TI2V-5B a 1280 por 704 | 24 GB | RTX 4090 | $0.89 | $0.34 |
| 14B en fp8 a 480p o 640 por 640 | 24 GB | RTX 4090 | $0.89 | $0.34 |
| 14B en fp8, clips más largos o LoRA | 32 GB | RTX 5090 | $1.19 | $0.69 |
| 14B en fp8 a 720p | 48 GB | L40S | $1.09 | $0.79 |
| 14B a 720p sin descarga a CPU | 80 GB o más | RTX PRO 6000, 96 GB | $2.49 | $1.69 |
Desliza hacia los lados para ver las 5 columnas
El fp8 de la tabla es un formato de archivo más ligero: los números del modelo se guardan con menos precisión, así que ocupa más o menos la mitad de memoria.
En nuestra propia cuenta de Runpod vemos el mismo muro desde el lado de las imágenes. Los modelos de imagen de 6 a 17 GB caben cómodamente en los 32 GB de una 5090. Un modelo de video de unos 40 GB la desborda y descarga a CPU.
Por eso una tarjeta de 96 GB puede costar menos por clip que una más barata que tiene que descargar a CPU.
¿Cuánto cuesta un clip en Runpod?
Desde menos de un centavo por un clip corto de LTX-2 hasta alrededor de un dólar por un clip de Wan 14B a 720p con el script de referencia de Alibaba. Cada cifra de abajo está calculada: un tiempo de generación publicado multiplicado por la tarifa por hora de Runpod.
| Clip | Tiempo publicado (fuente) | Tarjeta | Secure Cloud | Community Cloud |
|---|---|---|---|---|
| LTX-2, 4 segundos, 720p, 24 fps | Unos 25 segundos (NVIDIA) | RTX 5090 | $0.008 | $0.005 |
| LTX-2, 8 segundos, 720p | Unos 3 minutos (NVIDIA) | RTX 5090 | $0.06 | $0.03 |
| Wan 2.2 14B, 5 segundos, 640 por 640, Lightning LoRA | Unos 71 segundos (Runpod, en una RTX 4090D) | RTX 4090 | $0.018 | $0.007 |
| Wan 2.2 14B, 5 segundos, 640 por 640, 20 pasos | Unos 513 segundos (Runpod, en una RTX 4090D) | RTX 4090 | $0.13 | $0.05 |
| Wan 2.2 TI2V-5B, 5 segundos, 720P | Menos de 9 minutos (equipo de Wan, GPU de consumo) | RTX 4090 | $0.13 | $0.05 |
| Wan 2.2 14B, 720p, 40 pasos, duración del clip no indicada | 17.4 minutos (referencia de Alibaba) | H100 SXM | $1.16 | $0.78 |
Desliza hacia los lados para ver las 5 columnas
Runpod midió los 71 y 513 segundos en una ejecución en caliente (modelos ya cargados) en una RTX 4090D, la versión de exportación de la 4090 con menos núcleos. Aquí se calculan con la tarifa de 4090.
Los tres minutos de NVIDIA para 8 segundos incluyen la ralentización cuando el clip supera los 32 GB. Los 9 minutos del equipo de Wan son una cifra «de menos de», así que esa línea es un techo. Cargar los modelos antes del primer clip también se factura y queda fuera de estas filas.
El Lightning LoRA, un pequeño archivo complementario que reduce el muestreo de Wan a 4 pasos, pasa el mismo clip de unos 513 segundos a unos 71.
Como referencia, esta es una cifra medida en nuestra propia cuenta. Una imagen rápida de FLUX 3 Klein en una RTX 4090 de Secure Cloud tarda unos 28.5 segundos, o $0.007 cada una. La guía de ComfyUI en Runpod tiene esa tabla.
¿RTX 5090 o RTX 4090 para Wan en ComfyUI?
La RTX 4090 para el modelo de 5B y para 14B a 480p; la RTX 5090 cuando se agotan los 24 GB. La 5090 cuesta alrededor de un tercio más por hora en Secure Cloud, así que solo compensa cuando los 8 GB adicionales evitan que ComfyUI descargue a CPU. En Community Cloud cuesta aproximadamente el doble ($0.69 frente a $0.34).
La guía de Runpod sitúa los 32 GB de la 5090 en las tareas de 14B que necesitan margen: clips más largos, o LoRA cargados encima. Para LTX-2 la 5090 es la tarjeta que hay que alquilar, ya que el clip de 720p y 4 segundos de NVIDIA cabe dentro de su memoria.
Pasados los 32 GB, descarta ambas. Una L40S de 48 GB cuesta menos por hora que una 5090 de Secure Cloud. Para 14B completo a 720p, la RTX PRO 6000 de 96 GB contiene el modelo entero.
Cómo configurar Wan 2.2 con la plantilla de HearmemanAI
Esta vía descarga por ti los modelos y los flujos de trabajo en el primer arranque del Pod. Usa una plantilla de la comunidad, publicada en Runpod por HearmemanAI. Conecta un volumen de red (el disco permanente de Runpod, que se conserva cuando el Pod ya no está) para que la descarga ocurra una sola vez.
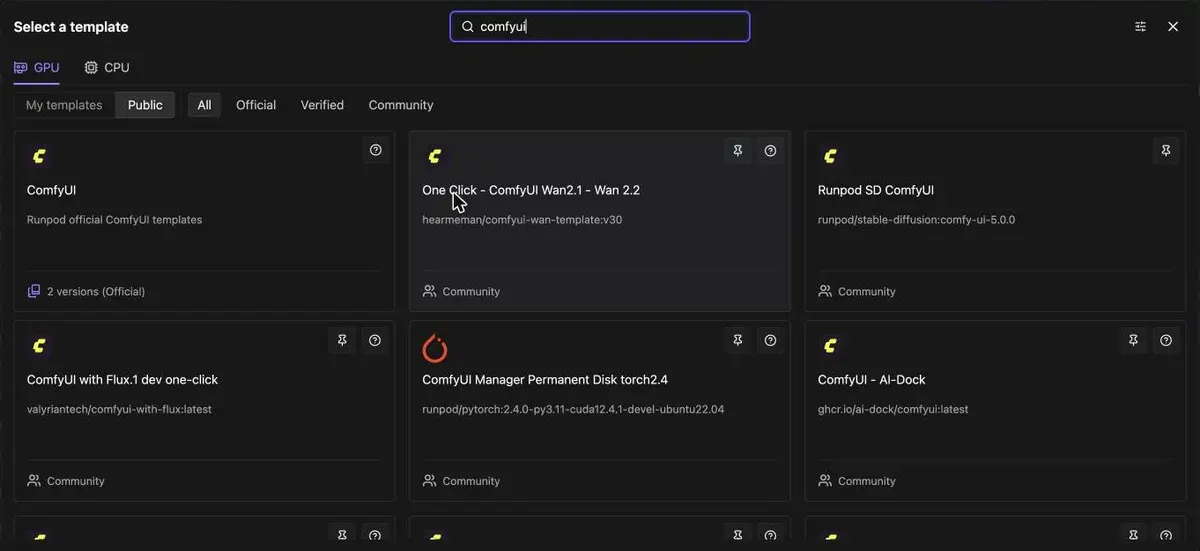
- Encuentra la plantilla. En la consola de Runpod, abre Pods, luego Deploy, y busca «comfyui». Elige «One Click - ComfyUI Wan2.1 - Wan 2.2» entre las plantillas de la comunidad junto a la oficial.
-
Activa la descarga de Wan 2.2. Abre Edit Template antes de desplegar. Todos los indicadores de descarga empiezan en false, así que pon
download_wan22en true,download_wan21también si quieres los flujos de trabajo de Wan 2.1, ydownload_wan_animatepara animación de personajes. -
Elige una tarjeta que ejecute CUDA 13. La guía de Runpod dice que la plantilla «está creada para CUDA 13.0 y superior», siendo CUDA la capa de controladores de la GPU. Filtra el selector por versión de CUDA. En nuestra cuenta, la versión fijada de CUDA de una plantilla fue una causa de «no instances available».
-
Despliega y espera al primer arranque. El Pod descarga los modelos antes de que se abra ComfyUI. Luego haz clic en Connect y abre el enlace de ComfyUI.
-
Carga un flujo de trabajo de Wan 2.2 y ejecútalo. La plantilla trae sus flujos de trabajo ya listos, así que fijas el prompt o la imagen, el tamaño y la duración del clip, y lo pones en cola.

- Detén el Pod cuando los clips estén guardados. Factura cada segundo que funciona, aunque esté inactivo.
La vía de la plantilla oficial de ComfyUI
La plantilla oficial te da un ComfyUI limpio y tú añades los archivos de Wan. Lleva más tiempo la primera vez y te deja a cargo de cada archivo.
-
Despliega la plantilla oficial de ComfyUI desde el mismo selector, o su Blackwell Edition en una RTX 5090. Pon el disco del contenedor en 50 GB, que funcionó en nuestra cuenta, donde el valor por defecto de 150 GB a menudo no encontraba tarjeta.
-
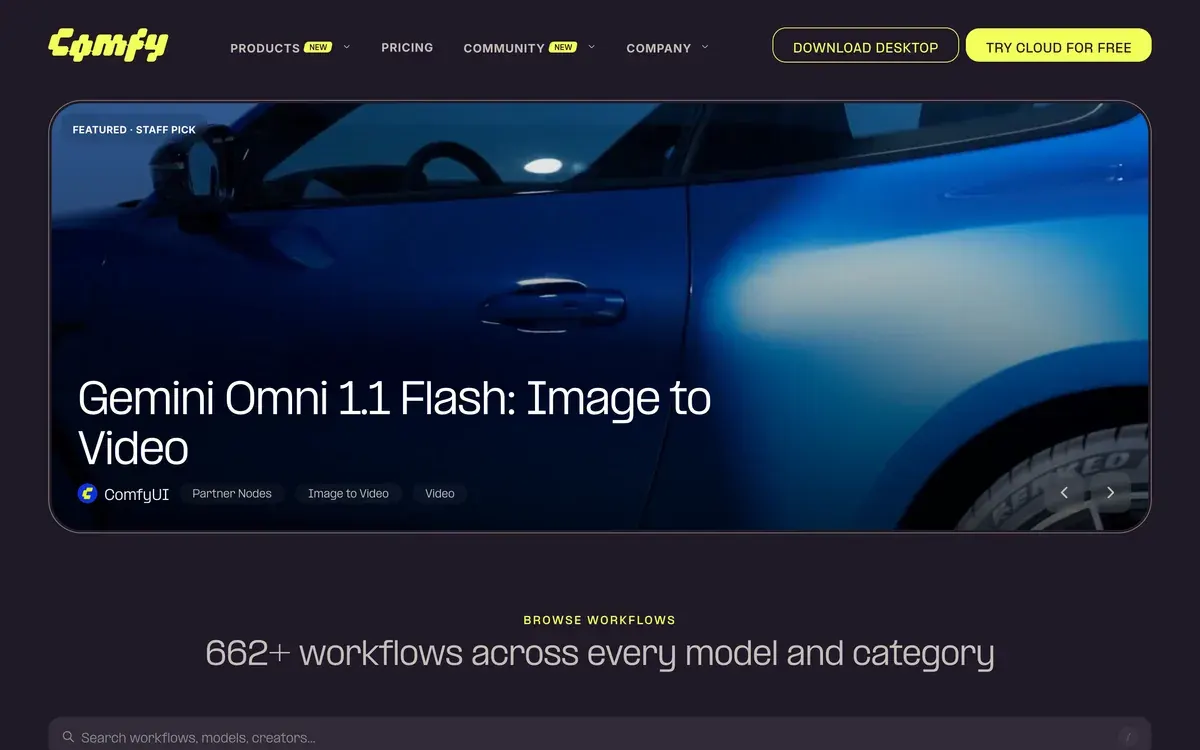
Abre la biblioteca de plantillas. En ComfyUI, busca «Wan2.2 5B» en la Template Library. Si no aparece nada, la documentación de ComfyUI dice que tu ComfyUI está desactualizado. Los mismos flujos de trabajo están en la galería pública de comfy.org, con búsqueda por modelo.
-
Pon cada archivo en su carpeta. Para el modelo de 5B, la documentación de ComfyUI lista
wan2.2_ti2v_5B_fp16.safetensorsenmodels/diffusion_models/,wan2.2_vae.safetensorsenmodels/vae/yumt5_xxl_fp8_e4m3fn_scaled.safetensorsenmodels/text_encoders/(documentación de ComfyUI sobre Wan 2.2). -
Fija el tamaño y la duración en el nodo
Wan22ImageToVideoLatent. Para los modelos de 14B es el nodoEmptyHunyuanLatentVideo. -
Ejecuta la cola y guarda el clip. Luego detén el Pod.
Para LTX-2 funciona la misma plantilla oficial. Instala los nodos LTXVideo desde ComfyUI Manager, como aconseja la ficha del modelo. Luego carga un flujo de trabajo de texto a video o imagen a video desde Template Library y luego Video.
LTX-2 in ComfyUI
Go to Template Library > Video > choose any LTX-2 workflow

¿Se puede ejecutar Wan 2.2 en ComfyUI en Google Colab?
No de forma fiable en el nivel gratuito. Las preguntas frecuentes de Google listan como no permitido trabajar con una interfaz web en los entornos gratuitos, y dicen que esos entornos a menudo se terminan (preguntas frecuentes de Colab). ComfyUI es una interfaz web. Un Pod alquilado no tiene esa regla, y su GPU se factura solo mientras funciona el Pod.
Nuestro hub de Runpod explica las demás páginas de Runpod, y la tabla de precios de GPU en la nube compara estas tarjetas entre nubes de GPU.
Preguntas sobre Wan 2.2 y LTX-2 en Runpod
¿Qué GPU necesito para Wan 2.2 en ComfyUI?
Una tarjeta de 24 GB como la RTX 4090 ejecuta el modelo de 5B a 720P y los modelos de 14B en fp8 a 480p. A 720p, los modelos de 14B necesitan 48 GB en fp8, o 80 GB o más a tamaño completo en una sola tarjeta.
¿Puedo usar videos de Wan 2.2 en anuncios de pago?
Sí. Wan 2.2 tiene licencia Apache 2.0, que permite el uso comercial. Runpod solo alquila la tarjeta, así que la licencia del modelo es la que rige los clips.
¿Es LTX-2 gratis para uso comercial?
Sí, por debajo de $10,000,000 de ingresos anuales de todo tu grupo, dentro de su lista de usos prohibidos. Por encima, la licencia de Lightricks exige una licencia comercial de pago.
¿Cuánto tarda un clip de Wan 2.2 en una GPU alquilada?
La guía de Runpod da unos 71 segundos para un clip de 5 segundos y 640 por 640 en una RTX 4090D con el Lightning LoRA. Con los 20 pasos por defecto tarda unos 513 segundos.
¿Ejecuta la plantilla también Wan 2.1?
Sí. Wan 2.1 es la generación anterior, y la plantilla de HearmemanAI descarga sus flujos de trabajo cuando pones download_wan21 en true. Empieza con 2.2, el modelo más nuevo.
Fuentes
- GitHub: Wan2.2, Apache 2.0; TI2V-5B genera 720P a 24 FPS en una GPU con al menos 24 GB, un video de 720P y 5 segundos en menos de 9 minutos en una sola GPU de consumo; A14B y S2V necesitan al menos 80 GB en una sola GPU; en ComfyUI desde el 28 de julio de 2025. Revisado
- Documentación de ComfyUI: Wan2.2 Video Generation ComfyUI Official Native Workflow Example, la versión de 5B debería caber bien en 8 GB de VRAM con la descarga nativa de ComfyUI; archivos de modelos y carpetas; plantillas que se encuentran buscando en la Template Library. Revisado
- Runpod: Wan 2.2 en ComfyUI en Runpod (actualizado el 22 de octubre de 2026), plantilla de un clic de HearmemanAI, indicadores de descarga download_wan22, download_wan21 y download_wan_animate, todos en false por defecto; CUDA 13.0 y superior; niveles de VRAM por GPU; clip de 5 segundos a 640x640 en una RTX 4090D en unos 71 segundos con el Lightning LoRA o 513 con 20 pasos, ejecuciones en caliente; referencia de Alibaba de 720p en 17.4 minutos en una H100, script de referencia con 40 pasos, duración del clip no indicada; Runpod lo mantiene separado de los tiempos de ComfyUI. Revisado
- Lightricks en Hugging Face: LTX-2.3, video y audio sincronizados en un solo modelo; nodos LTXVideo integrados en ComfyUI; versión destilada con 8 pasos. Revisado
- Lightricks en GitHub: LTX-2 Community License Agreement (5 de enero de 2026), cubre todas las versiones de LTX-2 publicadas desde el 5 de enero de 2026, la licencia a la que enlaza la ficha del modelo LTX-2.3; las entidades con ingresos anuales de al menos 10 millones de dólares necesitan una licencia de uso comercial de pago; el Attachment A lista los usos prohibidos; Lightricks no reclama ningún derecho sobre los resultados. Revisado
- MiniMax en Hugging Face: MiniMax H3 Community License Agreement, el Applicable Territory es todo el mundo excepto la Unión Europea, el Reino Unido, la República de Corea y Estados Unidos. Revisado
- NVIDIA: Quick start guide for LTX-2 in ComfyUI (5 de enero de 2026, edición en español), una RTX 5090 con 32 GB genera un clip de 720p, 24 fps y 4 segundos dentro de la memoria de la GPU en unos 25 segundos; un clip de 8 segundos tarda unos tres minutos. Revisado
- Runpod: Precios de Runpod (actualizados el 8 de octubre de 2026), RTX 4090 0.89 dólares la hora en Secure, 0.34 en Community; RTX 5090 1.19 y 0.69; L40S 1.09 y 0.79; RTX PRO 6000 2.49 y 1.69; H100 SXM 3.99 y 2.69. Revisado
- Google: Preguntas frecuentes de Colab, trabajar con una interfaz web en lugar del cuaderno no está permitido en los entornos gratuitos, que a menudo se terminan cuando se usan para ejecutar una interfaz web de generación de contenido. Revisado

Alexandre S.
Alexandre S. es estratega creativo de anuncios y redactor publicitario, con diez años de experiencia en marketing digital en múltiples canales.
Páginas relacionadas
-
 Guía Wan en Higgsfield
Higgsfield ofrece seis modelos de video Wan. Un clip de Wan 3.0 de 5 segundos a 720p cuesta 8.75 créditos, cerca del precio de Alibaba. Cuándo Wan supera a Kling o Seedance, y los pasos.
-
 Categoría Los mejores generadores de video con IA para anuncios
23 generadores de video con IA y tiendas de modelos comparados por costo por clip y condiciones en anuncios, revisados el 25 sep 2026.
-
 Perfil Runpod
Runpod para imágenes y video de anuncios: Secure o Community Cloud, Pods o Serverless, licencias de modelos y lo que cuentan 48 fuentes de usuarios. Revisado el 24 oct 2026.
-
 Alternativas Alternativas a Runpod
Vast.ai, Modal, Lambda, TensorDock, Massed Compute, Paperspace y Comfy Cloud frente a Runpod en tarifas de RTX 4090, 5090 y H100, leídas el 24 de octubre de 2026.


