Wan 2.2 et LTX-2 sur Runpod
Wan 2.2 et LTX-2 sont des modèles vidéo ouverts. Vous téléchargez les fichiers et les faites tourner vous-même dans ComfyUI, sur une carte graphique que vous possédez ou louez. Runpod loue ces cartes à la seconde.
Le petit modèle 5B de Wan 2.2 et LTX-2 tiennent sur une carte de 24 ou 32 Go, la RTX 4090 ou la RTX 5090. En 720p, les modèles 14B de Wan demandent 48 Go dans le format plus léger fp8. En taille réelle, ils demandent 80 Go ou plus, comme les 96 Go de la RTX PRO 6000.
Calculé à partir des temps de génération publiés, un court clip coûte de moins d'un cent à environ un dollar de temps GPU. Le dollar vient du script de référence d'Alibaba.
| Modèle | Ce qu'il produit | Mémoire graphique (source) | Carte Runpod adaptée | Licence pour la pub |
|---|---|---|---|---|
| Wan 2.2 TI2V-5B | Texte ou image vers vidéo, 720P à 24 FPS | 24 Go (équipe Wan), environ 8 Go avec déchargement (ComfyUI) | RTX 4090, 24 Go | Apache 2.0 |
| Wan 2.2 T2V et I2V A14B | Texte vers vidéo, image vers vidéo, 480P et 720P | 80 Go sur un GPU (équipe Wan) ; 24 Go en fp8 en 480p (Runpod) | RTX PRO 6000, 96 Go, pour du 720p | Apache 2.0 |
| LTX-2 et LTX-2.3 | Vidéo avec son synchronisé | Un clip 720p de 4 secondes dans 32 Go (NVIDIA) | RTX 5090, 32 Go | Gratuit sous 10 000 000 $ de chiffre d'affaires annuel |
Faites défiler sur le côté pour voir les 5 colonnes
Que sont Wan 2.2 et LTX-2 ?
Wan 2.2 est la famille vidéo ouverte d'Alibaba. Sa version plus récente, Wan 3.0, est vendue à la seconde via l'API d'Alibaba Cloud. La page GitHub de Wan 2.2 liste un modèle 5B qui transforme un texte ou une image en vidéo 720P (Wan2.2 sur GitHub). Ses modèles 14B couvrent le texte vers vidéo, l'image vers vidéo, la parole vers vidéo et l'animation de personnage.
Le « B » désigne des milliards de paramètres, une mesure approximative de la taille du modèle. Les gros modèles demandent plus de mémoire graphique, la VRAM, qui est le chiffre décisif quand vous louez une carte.
LTX-2 est le modèle ouvert de Lightricks, et sa version 2.3 produit vidéo et son en une seule passe. La fiche du modèle LTX-2.3 dit qu'il est « conçu pour générer vidéo et audio synchronisés au sein d'un seul modèle », et oriente les utilisateurs de ComfyUI vers les nœuds LTXVideo intégrés.

Les deux tournent dans ComfyUI, une appli gratuite où chaque étape du travail est un bloc sur un canevas, relié au suivant. Wan 2.2 est dans ComfyUI depuis le 28 juillet 2025.
Peut-on utiliser des clips Wan 2.2 et LTX-2 dans des pubs ?
Oui pour les deux, avec une condition de chiffre d'affaires et une liste d'usages interdits pour LTX-2. Runpod loue le matériel : c'est donc la licence du modèle qui décide de ce que vous pouvez faire des clips.
Wan 2.2 est sous Apache 2.0, une licence permissive qui autorise l'usage commercial. Le dépôt de l'équipe Wan indique : « Les modèles de ce dépôt sont publiés sous la licence Apache 2.0. »
Licence
Licence The models in this repository are licensed under the Apache 2.0 License.
Outputs We claim no rights over the your generated contents, granting you the freedom to use them.
5B model The TI2V-5B model can also run on consumer-grade graphics cards like 4090.
LTX-2 est sous le LTX-2 Community License Agreement, daté du 5 janvier 2026. Il autorise l'usage « à toute fin », sous réserve des usages interdits de son Attachment A, comme les deepfakes faits sans consentement. Il couvre toutes les versions LTX-2 publiées depuis cette date, LTX-2.3 compris.
Pour le travail publicitaire, le seuil de chiffre d'affaires est la condition à vérifier. Les entités dont le chiffre d'affaires annuel atteint au moins 10 000 000 $ « doivent obtenir une licence d'usage commercial payante » (licence LTX-2).
Section 2.1, grant of rights (dated 5 January 2026)
Entities with annual revenues of at least $10,000,000 (the “Commercial Entities”) are required to obtain a paid commercial use license in order to use LTX-2 and Derivatives of LTX-2.
Le seuil compte tout le groupe, filiales comprises. En dessous, l'usage publicitaire est sans redevances, et Lightricks « ne revendique aucun droit sur le résultat que vous générez ».
La licence ouverte de MiniMax H3 exclut les États-Unis, l'UE, le Royaume-Uni et la Corée du Sud (licence MiniMax H3). Pour des pubs là-bas, il reste hors de la liste.
De combien de VRAM avez-vous besoin, et quel GPU Runpod convient ?
Faites d'abord correspondre le modèle et la résolution à la mémoire de la carte, puis comparez les prix. Quand un modèle ne tient pas, ComfyUI en déplace une partie dans la mémoire ordinaire du pod : cela fonctionne, mais bien plus lentement.
Wan2.2 in ComfyUI
Templates Workflows in this guide can be found in the Workflow Templates.
5B memory The Wan2.2 5B version should fit well on 8GB vram with the ComfyUI native offloading.
Licence The Wan2.2 series models are based on the Apache 2.0 open source license and support commercial use.
Le guide Wan 2.2 de Runpod, mis à jour le 22 octobre 2026, donne des paliers de mémoire par tâche (guide Wan 2.2 de Runpod). Les tarifs du tableau viennent de la page des prix de Runpod.
| Usage | Mémoire | Carte | Secure Cloud l'heure | Community Cloud l'heure |
|---|---|---|---|---|
| TI2V-5B en 1280 par 704 | 24 Go | RTX 4090 | 0,89 $ | 0,34 $ |
| 14B en fp8 en 480p ou 640 par 640 | 24 Go | RTX 4090 | 0,89 $ | 0,34 $ |
| 14B en fp8, clips plus longs ou LoRA | 32 Go | RTX 5090 | 1,19 $ | 0,69 $ |
| 14B en fp8 en 720p | 48 Go | L40S | 1,09 $ | 0,79 $ |
| 14B en 720p sans déchargement | 80 Go ou plus | RTX PRO 6000, 96 Go | 2,49 $ | 1,69 $ |
Faites défiler sur le côté pour voir les 5 colonnes
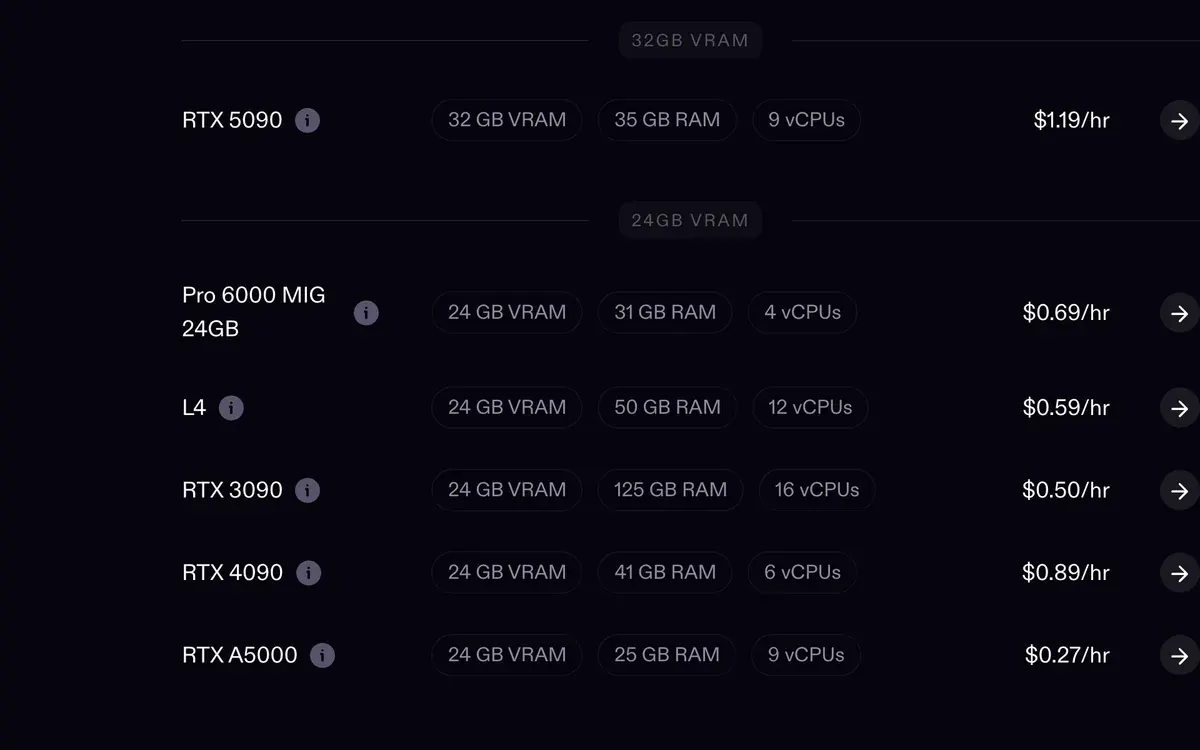
Le fp8 du tableau est un format de fichier plus léger : les nombres du modèle sont stockés avec moins de précision, ce qui demande environ moitié moins de mémoire.
Sur notre propre compte Runpod, nous voyons le même mur côté image. Les modèles d'image de 6 à 17 Go tiennent confortablement dans les 32 Go d'une 5090. Un modèle vidéo d'environ 40 Go la dépasse et se décharge.
C'est pourquoi une carte de 96 Go peut coûter moins par clip qu'une carte moins chère qui doit décharger.
Combien coûte un clip sur Runpod ?
De moins d'un cent pour un court clip LTX-2 à environ un dollar pour un clip Wan 14B en 720p avec le script de référence d'Alibaba. Chaque chiffre ci-dessous est calculé : un temps de génération publié multiplié par le tarif horaire de Runpod.
| Clip | Temps publié (source) | Carte | Secure Cloud | Community Cloud |
|---|---|---|---|---|
| LTX-2, 4 secondes, 720p, 24 fps | Environ 25 secondes (NVIDIA) | RTX 5090 | 0,008 $ | 0,005 $ |
| LTX-2, 8 secondes, 720p | Environ 3 minutes (NVIDIA) | RTX 5090 | 0,06 $ | 0,03 $ |
| Wan 2.2 14B, 5 secondes, 640 par 640, Lightning LoRA | Environ 71 secondes (Runpod, sur une RTX 4090D) | RTX 4090 | 0,018 $ | 0,007 $ |
| Wan 2.2 14B, 5 secondes, 640 par 640, 20 étapes | Environ 513 secondes (Runpod, sur une RTX 4090D) | RTX 4090 | 0,13 $ | 0,05 $ |
| Wan 2.2 TI2V-5B, 5 secondes, 720P | Moins de 9 minutes (équipe Wan, GPU grand public) | RTX 4090 | 0,13 $ | 0,05 $ |
| Wan 2.2 14B, 720p, 40 étapes, durée du clip non précisée | 17.4 minutes (benchmark d'Alibaba) | H100 SXM | 1,16 $ | 0,78 $ |
Faites défiler sur le côté pour voir les 5 colonnes
Runpod a mesuré les 71 et 513 secondes sur une exécution à chaud (modèles déjà chargés) sur une RTX 4090D, la version d'export de la 4090, avec moins de cœurs. Elles sont chiffrées ici au tarif de la 4090.
Les trois minutes de NVIDIA pour 8 secondes incluent le ralentissement quand le clip dépasse 32 Go. Les 9 minutes de l'équipe Wan sont un chiffre « en moins de » : cette ligne est donc un plafond. Le chargement des modèles avant le premier clip est aussi facturé et reste hors de ces lignes.
Le Lightning LoRA, un petit fichier complémentaire qui réduit l'échantillonnage de Wan à 4 étapes, fait passer le même clip d'environ 513 secondes à environ 71.
Pour situer l'ordre de grandeur, voici un chiffre mesuré sur notre propre compte. Une image FLUX 3 Klein fast sur une RTX 4090 Secure Cloud prend environ 28.5 secondes, soit 0,007 $ chacune. Le guide ComfyUI sur Runpod contient ce tableau.
RTX 5090 ou RTX 4090 pour Wan dans ComfyUI ?
La RTX 4090 pour le modèle 5B et pour le 14B en 480p ; la RTX 5090 quand les 24 Go ne suffisent plus. La 5090 coûte environ un tiers de plus de l'heure sur Secure Cloud : elle ne rapporte donc que si les 8 Go supplémentaires évitent à ComfyUI de décharger. Sur Community Cloud, elle coûte environ deux fois plus (0,69 $ contre 0,34 $).
Le guide de Runpod place les 32 Go de la 5090 sur les tâches 14B qui demandent de la marge : clips plus longs, ou LoRA chargés par-dessus. Pour LTX-2, la 5090 est la carte à louer, puisque le clip 720p de 4 secondes de NVIDIA tient dans sa mémoire.
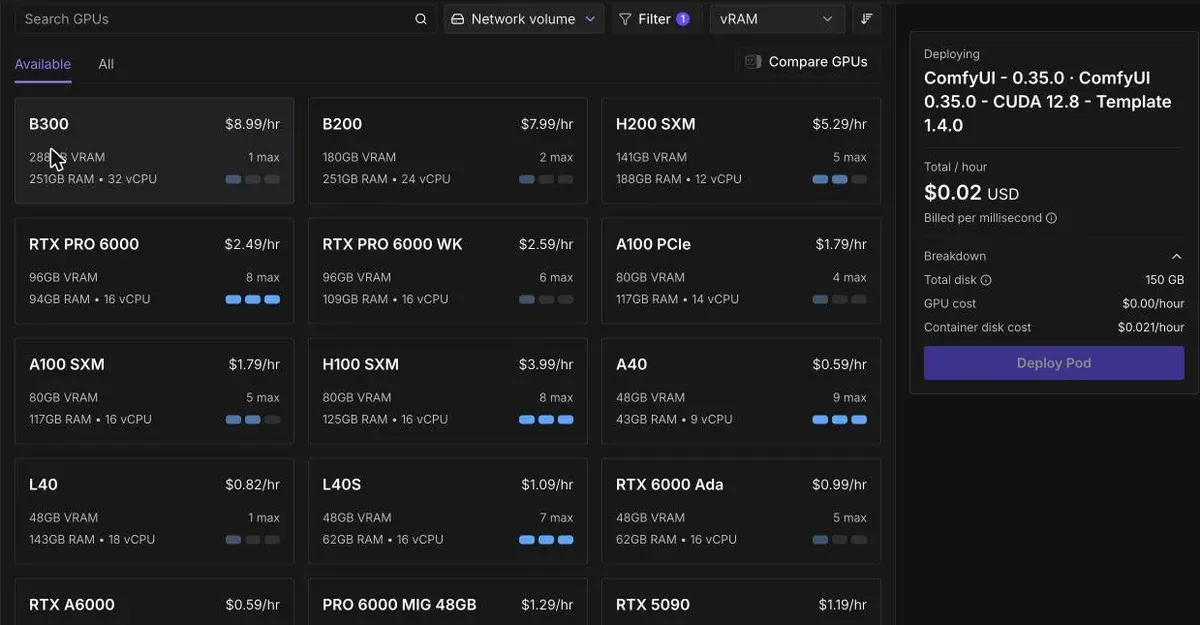
Au-delà de 32 Go, ni l'une ni l'autre ne suffit. Une L40S de 48 Go coûte moins cher de l'heure qu'une 5090 Secure Cloud. Pour le 14B complet en 720p, la RTX PRO 6000 de 96 Go tient tout le modèle.
Comment configurer Wan 2.2 avec le template de HearmemanAI
Cette voie télécharge pour vous les modèles et workflows au premier démarrage du pod. Elle utilise un template communautaire, publié sur Runpod par HearmemanAI. Joignez un volume réseau (le disque permanent de Runpod, conservé quand le pod a disparu) pour que le téléchargement n'ait lieu qu'une fois.
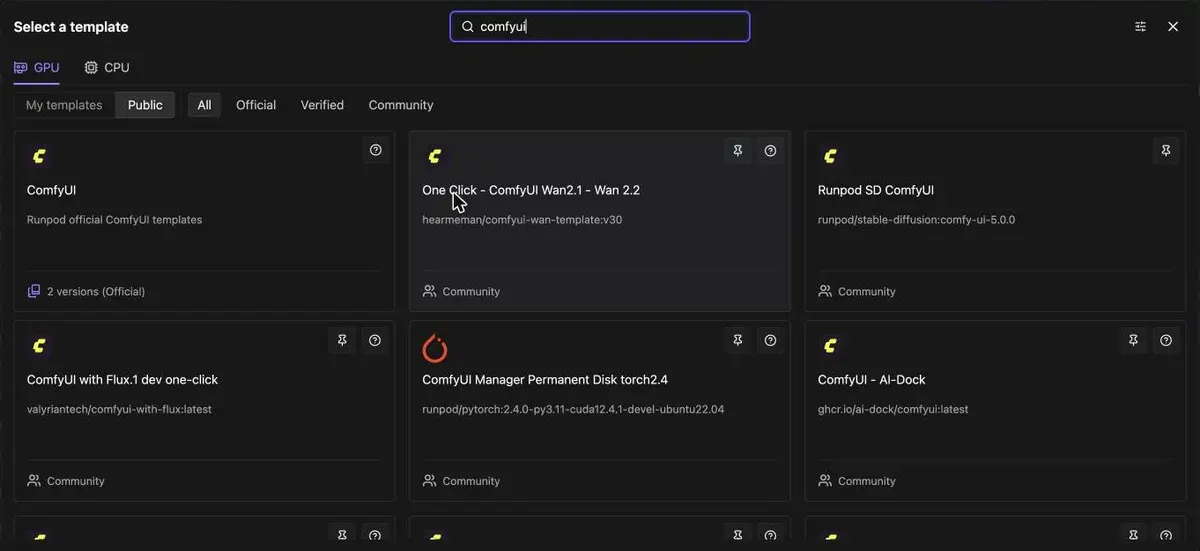
- Trouvez le template. Dans la console Runpod, ouvrez Pods, puis Deploy, et cherchez « comfyui ». Choisissez « One Click - ComfyUI Wan2.1 - Wan 2.2 » parmi les templates communautaires à côté de l'officiel.
-
Activez le téléchargement de Wan 2.2. Ouvrez Edit Template avant de déployer. Tous les indicateurs de téléchargement démarrent à false : réglez
download_wan22sur true,download_wan21aussi si vous voulez les workflows Wan 2.1, etdownload_wan_animatepour l'animation de personnage. -
Choisissez une carte qui fait tourner CUDA 13. Le guide de Runpod dit que le template « est conçu pour CUDA 13.0 et au-delà », CUDA étant la couche de pilotes du GPU. Filtrez le sélecteur par version CUDA. Sur notre compte, l'épinglage CUDA d'un template était une cause de « no instances available ».
-
Déployez et attendez le premier démarrage. Le pod télécharge les modèles avant l'ouverture de ComfyUI. Cliquez ensuite sur Connect et ouvrez le lien ComfyUI.
-
Chargez un workflow Wan 2.2 et lancez-le. Le template livre ses workflows prêts à l'emploi : vous réglez le prompt ou l'image, la taille et la durée du clip, puis vous le mettez en file.

- Arrêtez le pod quand les clips sont enregistrés. Il est facturé à chaque seconde de fonctionnement, même au repos.
La voie du template ComfyUI officiel
Le template officiel vous donne un ComfyUI propre et vous ajoutez vous-même les fichiers Wan. C'est plus long la première fois et vous gérez chaque fichier.
-
Déployez le template ComfyUI officiel depuis le même sélecteur, ou sa Blackwell Edition sur une RTX 5090. Réglez le disque de conteneur sur 50 Go, qui s'est déployé sur notre compte là où les 150 Go par défaut ne trouvaient souvent aucune carte.
-
Ouvrez la bibliothèque de templates. Dans ComfyUI, cherchez « Wan2.2 5B » dans la Template Library. Si rien n'apparaît, la doc de ComfyUI dit que votre ComfyUI est périmé. Les mêmes workflows se trouvent dans la galerie publique de comfy.org, avec recherche par modèle.
-
Mettez chaque fichier dans son dossier. Pour le modèle 5B, la doc de ComfyUI liste
wan2.2_ti2v_5B_fp16.safetensorsdansmodels/diffusion_models/,wan2.2_vae.safetensorsdansmodels/vae/etumt5_xxl_fp8_e4m3fn_scaled.safetensorsdansmodels/text_encoders/(doc ComfyUI Wan 2.2). -
Réglez la taille et la durée dans le nœud
Wan22ImageToVideoLatent. Pour les modèles 14B, c'est le nœudEmptyHunyuanLatentVideo. -
Lancez la file et enregistrez le clip. Arrêtez ensuite le pod.
Pour LTX-2, le même template officiel fonctionne. Installez les nœuds LTXVideo depuis ComfyUI Manager, comme le conseille la fiche du modèle. Chargez ensuite un workflow texte vers vidéo ou image vers vidéo depuis Template Library, puis Video.
LTX-2 in ComfyUI
Go to Template Library > Video > choose any LTX-2 workflow

Peut-on lancer Wan 2.2 dans ComfyUI sur Google Colab ?
Pas de façon fiable sur l'offre gratuite. La FAQ de Google classe le travail via une interface web comme interdit sur les environnements gratuits, et dit que ces environnements sont souvent arrêtés (FAQ Colab). ComfyUI est une interface web. Un pod loué n'est soumis à aucune règle de ce genre, et son GPU n'est facturé que pendant que le pod tourne.
Notre dossier Runpod présente les autres pages Runpod, et le tableau des prix des GPU cloud compare ces cartes entre clouds GPU.
Questions sur Wan 2.2 et LTX-2 sur Runpod
Quel GPU faut-il pour Wan 2.2 dans ComfyUI ?
Une carte de 24 Go comme la RTX 4090 fait tourner le modèle 5B en 720P et les modèles 14B en fp8 en 480p. En 720p, les modèles 14B demandent 48 Go en fp8, ou 80 Go ou plus en taille réelle sur une seule carte.
Puis-je utiliser des vidéos Wan 2.2 dans des pubs payantes ?
Oui. Wan 2.2 est sous Apache 2.0, qui autorise l'usage commercial. Runpod ne fait que louer la carte : c'est donc la licence du modèle qui régit les clips.
LTX-2 est-il gratuit pour un usage commercial ?
Oui, sous 10 000 000 $ de chiffre d'affaires annuel pour tout votre groupe, dans le respect de sa liste d'usages interdits. Au-dessus, la licence de Lightricks exige une licence commerciale payante.
Combien de temps prend un clip Wan 2.2 sur un GPU loué ?
Le guide de Runpod donne environ 71 secondes pour un clip de 5 secondes en 640 par 640 sur une RTX 4090D avec le Lightning LoRA. Avec les 20 étapes par défaut, il faut environ 513 secondes.
Le template fait-il aussi tourner Wan 2.1 ?
Oui. Wan 2.1 est la génération précédente, et le template de HearmemanAI télécharge ses workflows quand vous réglez download_wan21 sur true. Commencez par 2.2, le modèle plus récent.
Sources
- GitHub : Wan2.2, Apache 2.0 ; TI2V-5B produit du 720P à 24 FPS sur un GPU d'au moins 24 Go, une vidéo 720P de 5 secondes en moins de 9 minutes sur un GPU grand public ; A14B et S2V demandent au moins 80 Go sur un GPU ; dans ComfyUI depuis le 28 juillet 2025. Vérifié le
- ComfyUI docs : Wan2.2 Video Generation ComfyUI Official Native Workflow Example, la version 5B devrait tenir sur 8 Go de VRAM avec le déchargement natif de ComfyUI ; fichiers et dossiers du modèle ; templates trouvés en cherchant dans la Template Library. Vérifié le
- Runpod : Wan 2.2 in ComfyUI on Runpod (updated 22 October 2026), template en un clic de HearmemanAI, indicateurs de téléchargement download_wan22, download_wan21 et download_wan_animate, tous à false par défaut ; CUDA 13.0 et au-delà ; paliers de VRAM par GPU ; clip de 5 secondes en 640x640 sur une RTX 4090D en environ 71 secondes avec le Lightning LoRA ou 513 à 20 étapes, exécutions à chaud ; benchmark d'Alibaba en 720p à 17.4 minutes sur un H100, script de référence à 40 étapes, durée du clip non précisée ; Runpod le garde à part des temps ComfyUI. Vérifié le
- Lightricks sur Hugging Face : LTX-2.3, vidéo et audio synchronisés dans un seul modèle ; nœuds LTXVideo intégrés à ComfyUI ; version distillée en 8 étapes. Vérifié le
- Lightricks sur GitHub : LTX-2 Community License Agreement (5 January 2026), couvre toutes les versions LTX-2 publiées depuis le 5 janvier 2026, la licence vers laquelle renvoie la fiche du modèle LTX-2.3 ; les entités dont le chiffre d'affaires annuel atteint au moins 10 millions de dollars ont besoin d'une licence d'usage commercial payante ; l'Attachment A liste les usages interdits ; Lightricks ne revendique aucun droit sur les résultats. Vérifié le
- MiniMax sur Hugging Face : MiniMax H3 Community License Agreement, le territoire applicable est le monde entier hors Union européenne, Royaume-Uni, République de Corée et États-Unis. Vérifié le
- NVIDIA : Quick start guide for LTX-2 in ComfyUI (5 January 2026, Spanish edition), une RTX 5090 de 32 Go produit un clip 720p, 24 fps, de 4 secondes dans la mémoire du GPU en environ 25 secondes ; un clip de 8 secondes prend environ trois minutes. Vérifié le
- Runpod : Runpod pricing (updated 8 October 2026), RTX 4090 0.89 dollars de l'heure Secure, 0.34 Community ; RTX 5090 1.19 et 0.69 ; L40S 1.09 et 0.79 ; RTX PRO 6000 2.49 et 1.69 ; H100 SXM 3.99 et 2.69. Vérifié le
- Google : Colab FAQ, travailler via une interface web plutôt que le notebook est interdit sur les environnements gratuits, souvent arrêtés quand ils servent à faire tourner une interface web de génération de contenu. Vérifié le

Alexandre S.
Alexandre S. est stratège créatif en publicité et copywriter, avec dix ans d’expérience en marketing digital sur plusieurs canaux.
Pages associées
-
 Guide Wan sur Higgsfield
Higgsfield propose six modèles vidéo Wan. Un clip Wan 3.0 de 5 secondes en 720p coûte 8.75 crédits, à peu près le prix d’Alibaba. Quand Wan l’emporte sur Kling ou Seedance, et les étapes à suivre.
-
 Catégorie Les meilleurs générateurs de vidéo IA pour la pub
23 générateurs de vidéo IA et plateformes de modèles comparés sur le coût par clip et les conditions d'usage publicitaire, vérifiés le 25 septembre 2026.
-
 Fiche Runpod
Runpod pour les images et vidéos de pub : Secure ou Community Cloud, Pods ou Serverless, licences des modèles, et ce que rapportent 48 sources utilisateurs. Vérifié le 24 oct. 2026.
-
 Alternatives Alternatives à Runpod
Vast.ai, Modal, Lambda, TensorDock, Massed Compute, Paperspace et Comfy Cloud face à Runpod sur les tarifs RTX 4090, 5090 et H100, relevés le 24 octobre 2026.


