Lip sync na Higgsfield
O lip sync faz o rosto de uma foto ou vídeo mexer a boca de acordo com um roteiro. Na Higgsfield, o lipsync fica no Lipsync Studio, em Video. Você leva um rosto e uma fala, escolhe um de oito modelos e recebe um clipe falado. A voz vem da aba Audio da Higgsfield, onde dá para clonar a sua.
| Onde | O que faz | Você envia | Créditos |
|---|---|---|---|
| Lipsync Studio, modelos de imagem | Faz um rosto parado falar | Um retrato e um roteiro | Cerca de 12 a 14 por 5 s em 720p (Infinite Talk: cerca de 12 por 2 s) |
| Lipsync Studio, modelos de vídeo | Ressincroniza a boca em imagens existentes | Um clipe e um áudio novo | Cerca de 2 por 5 s (Kling Lipsync, 720p) |
| Modelos de vídeo com áudio nativo | Rosto e voz gerados de uma só vez | Um prompt e um frame inicial | Varia por modelo; Seedance 2.0 custa cerca de 22 por 5 s a 720p |
| Áudio | Texto para fala, troca de voz e tradução para 18 idiomas | Um roteiro ou um clipe | Aparece no botão Generate antes de você confirmar |
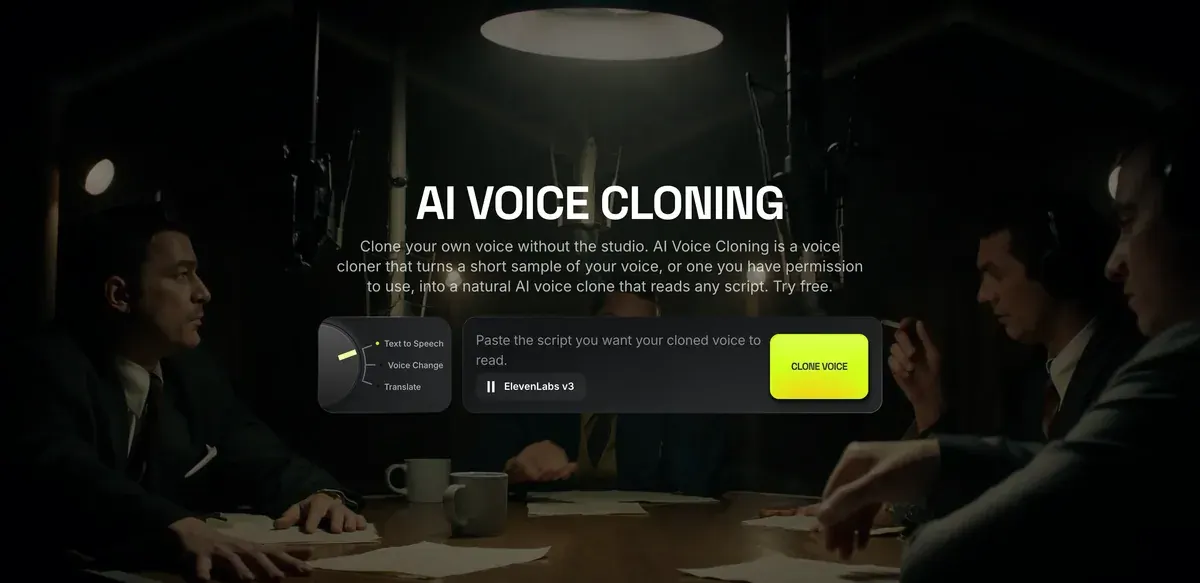
| Clonagem de voz, em Audio | Uma cópia reutilizável de uma voz | Uma amostra curta em MP3 ou WAV, com consentimento | Aparece no botão Generate antes de você confirmar |
Role para o lado para ver as 4 colunas
O que é o lipsync do Higgsfield?
O lipsync do Higgsfield são duas ferramentas que trabalham em dupla. O Audio cria a voz. O Lipsync Studio coloca essa voz num rosto. O artigo de ajuda do Higgsfield é direto: uma boca que fala “é o Lipsync Studio, em Video”, e uma voz “é o Audio. São ferramentas separadas.”
How do I use lipsync, voiceover, and aspect ratios?
Voice generation, voice change, and translation live in Audio, while making a character talk (lip sync) lives in Lipsync Studio, which offers several models for image-to-video and video-to-video talking clips. Some video models also generate audio together with video in a single pass. Aspect ratio is set per generation inside each tool: common options are 9:16 for vertical, 16:9 for horizontal, and 1:1 for square, and not every model supports every ratio.
Há um terceiro caminho que dispensa a dupla. Alguns modelos de vídeo, como Seedance 2.5, Seedance 2.0 e Kling 3.0, geram a fala junto com a imagem “em uma única passada”. O artigo de ajuda explica a diferença: o Lipsync Studio “adiciona uma boca que fala a uma imagem ou vídeo já existente, depois de pronto”, enquanto o áudio nativo dá “alinhamento físico perfeito desde o início”.
Num anúncio, o Lipsync Studio deixa você escrever as palavras exatas, escolher a voz e manter o mesmo rosto. Um modelo com áudio nativo gera rosto e voz juntos, numa só tomada, mas com menos controle sobre a entrega.
A página AI Talking Avatar é a porta de entrada do Higgsfield para essas mesmas ferramentas: um roteiro ou uma faixa de áudio, depois “uma foto de retrato ou um rosto gerado no Higgsfield”, e então prévia e download.
Como fazer um vídeo falado, passo a passo
Sete passos levam você de uma página em branco a um clipe pronto para virar anúncio.
- Abra o guia do próprio Higgsfield, How do I use lipsync, voiceover, and aspect ratios?, e deixe-o à mão. Depois abra o Lipsync Studio pelo menu Video; a central de ajuda chama a ferramenta de “Create Talking Clips”.
How do I create a lip-synced (talking) video?
Lip sync lives in Lipsync Studio (higgsfield.ai → Video → Lipsync Studio, “Create Talking Clips”). Upload a character image or video, type what the character should say in Audio text (or generate the audio), pick a model, and generate. Each model offers scene templates (General, Selfie, Podcast, Car Talking, and more) to set the look of the clip.
- Escreva o roteiro antes de tudo, calculando cerca de duas palavras e meia por segundo (a próxima seção traz as contas). Escreva como as pessoas falam, com uma indicação entre colchetes, como [warm] ou [direct], onde o tom muda.
- Escolha o rosto. Para uma imagem estática, envie um retrato nítido, bem iluminado e de frente, com “uma expressão leve e natural”; o blog do Higgsfield diz que um “rosto neutro de foto 3x4” dá ao modelo “nada de onde partir para animar”. Para um clipe em que você quer trocar a voz, use uma filmagem estável, com a cabeça parada. Um rosto criado no Soul funciona; o rosto de uma pessoa real exige o consentimento dela.
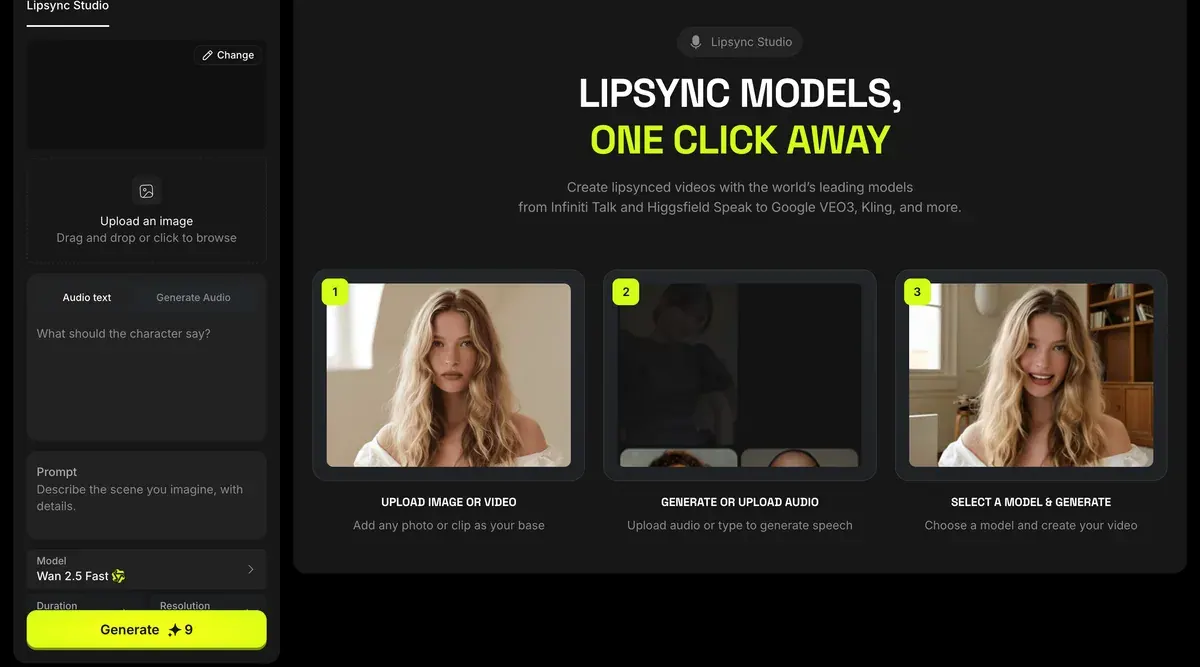
- Crie a voz. Digite a fala na caixa de áudio do Lipsync Studio ou monte a faixa antes, no Audio. O Audio oferece uma voz pronta ou um clone da sua própria voz, ajustado com controles deslizantes de emoção. O blog do Higgsfield põe o áudio em primeiro lugar por um motivo: “Uma faixa de áudio sem emoção gera um rosto sem emoção, não importa o modelo.”
- Escolha o modelo e o template de cena. Os templates incluem General, Selfie, Podcast e Car Talking. Defina a proporção antes de confirmar: 9:16 para TikTok, Reels e Shorts. As proporções variam conforme o modelo, e alguns leem a proporção da sua imagem.
- Gere e observe o rosto inteiro. Confira os olhos, a cabeça e se a expressão combina com a voz; a boca costuma ser a parte que funciona. A cada nova tentativa, mude só uma coisa, na ordem do Higgsfield: roteiro, depois imagem, depois modelo.
- Exporte. Para mudar o formato de um clipe pronto, use Edit e depois Reframe. Para fazer uma versão em outro idioma, passe o clipe pelo Translate, no Audio.
What voice and audio tools are available?
Three modes. Text to Speech generates a voice track from text; Voice Change replaces the existing voice in a clip with a different one; Translate translates and re-voices your content in another language (18 languages).
Your own voice. Create custom voice → Add Voice lets you record a sample or upload one (MP3 or WAV), then clones it into a reusable voice you can select for any generation. Only clone a voice that is your own or one you have the person’s permission to use.
Para conhecer todas as abas do Higgsfield, veja como usar o Higgsfield.
Quais modelos fazem sincronização labial e quanto custam
O Lipsync Studio reúne seis modelos de imagem e dois de vídeo. O Higgsfield Speak 2.0, motor próprio da plataforma, está disponível só nos planos Plus e Ultra.
| Modelo | Entrada | O que o Higgsfield diz | Créditos |
|---|---|---|---|
| Higgsfield Speak 2.0 | Imagem | Velocidade de fila prioritária | Cerca de 14 por 5 s a 720p |
| Wan 2.5 Speak | Imagem | De 480p a 1080p, com áudio | Cerca de 12 por 5 s a 720p |
| Infinite Talk | Imagem | Vídeo falado de longa duração | Cerca de 12 por 2 s a 720p |
| Kling 2.6 Lipsync | Imagem | Até 1080p, com áudio | Não aparece com esse nome; a linha Kling Speak da tabela marca cerca de 2 por 2 s |
| Kling Avatars 2.0 | Imagem | Avatares falantes, clipes mais longos | Não aparece com esse nome |
| Google Veo 3.1 | Imagem | Vídeo falado com visual de cinema | Não consta no Lipsync Studio |
| Kling Lipsync | Vídeo | Sincronização labial em filmagens já existentes | Cerca de 2 por 5 s a 720p |
| Sync Lipsync 3 | Vídeo | Sincronização labial precisa, até 4K | Cerca de 18 por 2 s a 4K |
Role para o lado para ver as 4 colunas
Os nomes dos modelos e as observações vêm do artigo de ajuda sobre lipsync; os créditos, da tabela comparativa da página de preços, lida em 9 de outubro de 2026.
Lipsync Studio models
Image to video. Google Veo 3.1 (cinematic talking video); Kling 2.6 Lipsync (up to 1080p, with audio); Wan 2.5 Speak (480p to 1080p, with audio); Kling Avatars 2.0 (talking avatars, longer clips); Higgsfield Speak 2.0 (priority-queue speed); Infinite Talk (long-form talking video).
Video to video. Kling Lipsync (lip sync on existing footage); Sync Lipsync 3 (precise lip sync, up to 4K).
Três custos de exemplo, com essas tarifas:
- Um clipe de apresentador de 15 segundos no Speak 2.0 a 720p: três blocos de 5 segundos a cerca de 14, ou seja, cerca de 42 créditos.
- Trocar a voz de um anúncio de 30 segundos que já está no ar, com o Kling Lipsync: seis blocos a cerca de 2, ou seja, cerca de 12 créditos. É o jeito mais barato de testar um gancho novo em uma filmagem que já provou seu valor.
- Os mesmos 15 segundos no Sync Lipsync 3 a 4K: cerca de 18 créditos a cada 2 segundos, ou seja, cerca de 135 créditos.
O Plus, plano mais barato com Speak, custa US$ 59 por mês e dá 1.200 créditos por mês. A cerca de 42 créditos por clipe, isso cobre cerca de 28 clipes de apresentador no Speak 2.0, se nada mais gastar os créditos.
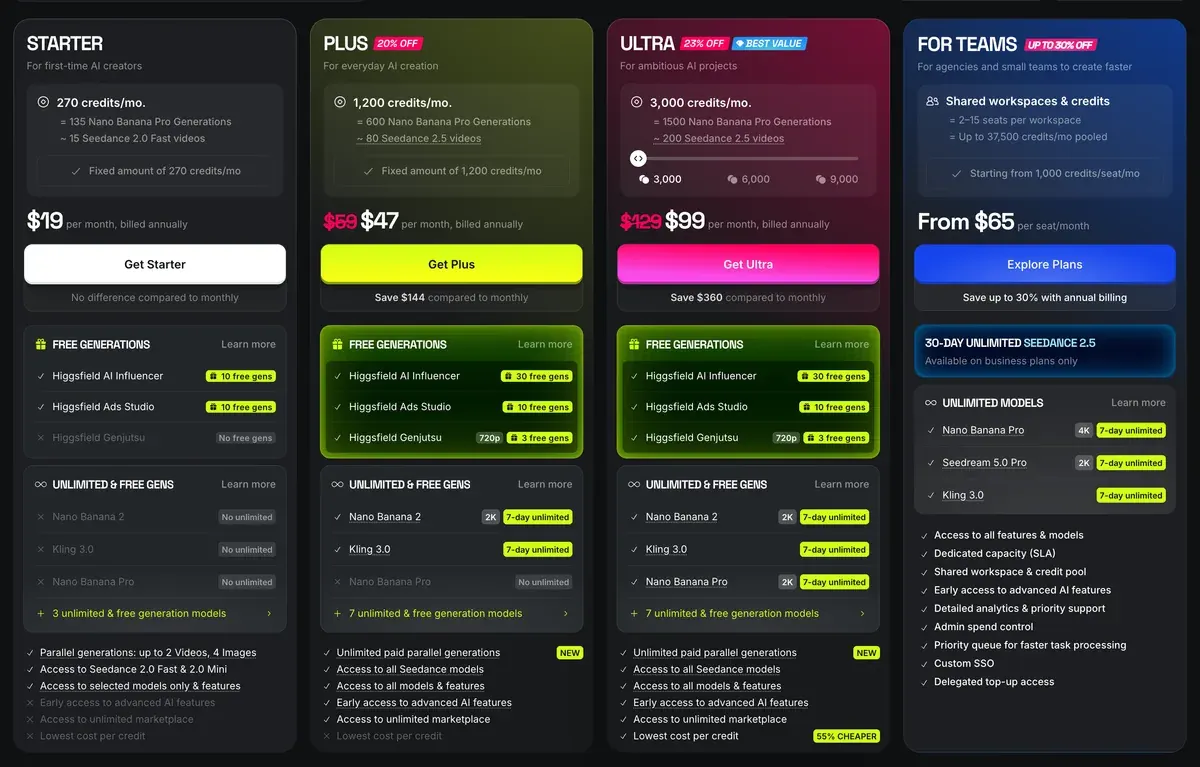
Dois relatos de usuários pesam na conta. Oito de 52 fontes públicas dizem que as gerações demoram ou falham e mesmo assim consomem créditos (Reddit, YouTube). Seis dizem que os créditos expiram no fim de cada período (Trustpilot, YouTube). Todos os planos e seus créditos: preços do Higgsfield.
Como escrever um roteiro que sincroniza bem
Roteiro de sincronização labial é escrito para o ouvido, então o tamanho se mede em segundos. O inglês americano de conversa fica em torno de 150 palavras por minuto, número que a VirtualSpeech atribui ao National Center for Voice and Speech. Dá duas palavras e meia por segundo.
| Duração do clipe | Palavras, no máximo | Serve para |
|---|---|---|
| 5 s | 12 | Uma frase de gancho |
| 8 s | 20 | Um gancho e um motivo |
| 15 s | 37 | Gancho, produto e CTA |
| 30 s | 75 | Um anúncio curto completo, melhor se dividido em dois clipes |
Role para o lado para ver as 3 colunas
Fique algumas palavras abaixo do limite. Pausas e indicações entre colchetes também levam tempo, e é numa fala apressada que a boca escorrega.
Cinco regras fazem diferença no Higgsfield:
- Uma ideia por frase. Cada frase ganha a própria respiração, e o rosto se reinicia entre elas.
- Escreva como você fala. O blog do Higgsfield contrapõe “Temos o prazer de anunciar a atualização mais recente do nosso produto” a “Hoje quero mostrar uma coisa em que a gente vem trabalhando faz um tempo.”
- Marque o tom entre colchetes onde ele muda: [warm], [calm], [direct]. Segundo o Higgsfield, os modelos baseados em performance “usam essas marcações para variar os parâmetros de animação facial”.
- Escreva os números por extenso, como se falam (“vinte por cento”), e os nomes de marcas como soam. A voz erra ao ler símbolos.
- Use um só falante. O Higgsfield lista o diálogo sobreposto entre as limitações; faça de cada falante um clipe separado.
Step-by-step: how to improve AI lipsync quality
Write for spoken delivery, not for reading. Formal writing produces robotic delivery. Conversational language produces more natural facial animation because the model has more expressive cues to work from. Add emotion cues in brackets where the tone should shift: [excited], [calm], [direct].
Generate expressive audio first. Voice is the input that drives facial animation. Monotone delivery reduces the range of facial motion the model generates. A flat audio track produces a flat face regardless of which model you use.
Roteiro de apresentadora de 15 segundos, com 28 palavras faladas, para um celular apoiado na prateleira do banheiro:
[warm] Morning routine, one step.
[direct] Two drops of this serum, pat it in, done.
[light] No layering three bottles.
[calm] It's in the link below, if your shelf is full too.
A apresentadora mostra o produto e lê a promessa da marca. Ela nunca diz que usa o produto há meses: vindo de um rosto de IA, isso é um depoimento falso (UGC com IA e a lei). Mais formatos de roteiro por tipo de anúncio: template de roteiro UGC.
Quando a boca sai do ritmo: correções comuns
O blog do Higgsfield chama a precisão da sincronização labial de “um problema em grande parte resolvido em 2026”. O que o público percebe é tudo, menos a boca: um rosto congelado, olhos fixos, um aceno em loop, um rosto que muda de um clipe para outro.
How to make an AI Talking Video Feel Real?
A believable LipSync video coordinates six elements simultaneously: lip movement aligned to speech phonemes; facial expressions that shift with emotional content; eye movement; subtle head motion that follows speech rhythm; gestures that match meaning; voice delivery with pacing, pauses, and tonal variation.
Frozen facial expressions. The cause is usually a source image with a neutral, flat expression. Use an image where the subject has a light, natural expression, not a passport-photo neutral face. Adding emotion cues to the script also helps: words like [excited], [thoughtful], or [warm] in brackets give performance-based models a signal to animate from.
| O que você vê | Por quê | Correção |
|---|---|---|
| Só a boca se mexe | Foto de origem neutra e sem expressão | Um retrato com expressão leve; indicações entre colchetes |
| Voz animada, rosto sem expressão | Voz e rosto gerados em etapas separadas | Combine a energia da voz com a do rosto ou use um modelo com áudio nativo |
| Olhar fixo, piscadas regulares | Pouco movimento dos olhos no modelo | Clipes com menos de 20 segundos |
| O mesmo aceno a cada 8 a 10 s | Uma biblioteca pequena de movimentos num clipe longo | Clipes com menos de 30 segundos, montados em sequência |
| Um rosto novo em cada clipe | Sem trava de identidade | Treine um Soul ID uma vez e reutilize |
| Lábios fora do lugar com a cabeça virada | Ângulo lateral ou rosto coberto | Material de origem de frente, sem óculos nem cabelo sobre a boca |
| Sotaque errado | Voz padrão para o roteiro | Escolha uma voz no idioma de destino; o Qwen Audio 3.0 TTS aceita o dialeto descrito em palavras simples |
| Duas pessoas falando ao mesmo tempo | Diálogo sobreposto | Um falante por clipe, unidos na edição |
Role para o lado para ver as 3 colunas
As correções das cinco primeiras linhas são do próprio Higgsfield, tiradas do post do blog sobre lipsync. As linhas de ângulo lateral e de vários falantes vêm das limitações listadas no mesmo post; a linha de sotaque, da página de voice-over.
How do you fix the most common problems?
Repetitive gestures. Limited motion libraries produce the same head nod or shoulder movement every 8-10 seconds. The fix is clip length: keep individual generations under 30 seconds and cut between them.
Character drift. The same person looking different across multiple clips is a persistent identity problem, not a LipSync problem. The fix is to use a trained identity layer rather than re-uploading the same photo each time.
Quando uma tomada está quase boa, mude uma única entrada e gere de novo. Se mudar várias de uma vez, não dá para saber qual delas resolveu.
Vídeos falados em anúncios
Três formatos de anúncio dependem de sincronização labial, e cada um usa uma parte diferente do Higgsfield.
O primeiro é o UGC de rosto falando: um criador segurando seu produto e falando para o celular. Crie o rosto uma vez no Soul, fixe-o com o Soul ID e faça-o falar no Lipsync Studio ou no Seedance. O método completo, com prompts: personagens realistas de UGC com IA no Higgsfield. Para um criador virtual recorrente, veja o guia de AI Influencer.
O segundo é o vídeo explicativo de produto: um apresentador que mostra o que o produto faz. A página de talking avatar do Higgsfield diz que o Marketing Studio “adiciona mais de 100 avatares prontos” para anúncios de produto, o que poupa o trabalho de escolher o elenco (guia do Marketing Studio). O Cinema Studio gera “cenas de avatar falante com visual de cinema de até 30 segundos, com referências de imagem, vídeo e áudio para rosto, produto e estilo.”
O terceiro é a versão traduzida de um anúncio que já vende. O Translate, no Audio, redubla um clipe em 18 idiomas. Na página de clonagem de voz, a ferramenta de localização do Supercomputer traduz a fala “para inglês, espanhol ou francês” mantendo a voz de quem fala. Depois o Kling Lipsync ressincroniza a boca, com a menor tarifa do estúdio.
Cinco de 52 fontes públicas atribuem ao Soul ID, aos Elements e às folhas de referência o mérito de manter o personagem igual entre os planos (YouTube, Reddit). É essa consistência que permite a um único apresentador sustentar uma campanha inteira.
Duas regras valem para todos os formatos. A primeira é o consentimento para qualquer rosto ou voz real. A seção 5.3 dos termos do Higgsfield obriga você a garantir “todos os consentimentos, autorizações e permissões exigidos pela lei aplicável de cada pessoa cujo rosto ou voz esteja incluído”.
A segunda é a transparência sobre o apresentador. A seção 5.2(xi) proíbe apresentar “qualquer Output como gerado por humanos quando não é”. Rótulos das plataformas: rótulo de IA do TikTok e aviso de IA da Meta.
Trocar o rosto em vez da voz é outra ferramenta: troca de rosto e Recast no Higgsfield. Todas as páginas sobre o Higgsfield estão na central do Higgsfield, e os planos e termos, no perfil do Higgsfield.
Perguntas sobre sincronização labial no Higgsfield
O Higgsfield sincroniza os lábios do meu próprio vídeo?
Sim. Os dois modelos de vídeo do Lipsync Studio ressincronizam a boca em filmagens que você envia. O Kling Lipsync custa cerca de 2 créditos por 5 segundos a 720p; o Sync Lipsync 3 vai até 4K. O blog do Higgsfield pede “filmagem estável, com rosto nítido e desobstruído e posição de cabeça consistente”.
Posso usar minha própria voz?
Sim. No Audio, escolha Create custom voice e grave ou envie uma amostra curta em MP3 ou WAV. A regra do Higgsfield: “Clone apenas a sua própria voz ou uma voz que você tenha permissão para usar.” A página de clonagem acrescenta uma etapa de consentimento antes de o clone ser criado.
Qual a duração máxima de um vídeo falado no Higgsfield?
O artigo de ajuda sobre lipsync não define limite máximo para o Lipsync Studio; o Infinite Talk é o modelo que ele indica para vídeo falado de longa duração. As cenas faladas do Cinema Studio chegam a 30 segundos. O conselho do próprio Higgsfield é manter cada geração abaixo de 30 segundos e cortar entre os clipes.
Devo usar o Lipsync Studio ou o Seedance?
Use o Lipsync Studio quando precisar controlar as palavras exatas e a voz, como num anúncio com apresentador e roteiro. Use o Seedance quando uma tomada única importar mais: ele gera voz e imagem juntas. O Seedance no Higgsfield em detalhes: guia do Seedance.
Todos os guias do Higgsfield, organizados por tarefa, estão na central do Higgsfield
Fontes
- Central de ajuda do Higgsfield: How do I use lipsync, voiceover, and aspect ratios?, os oito modelos do Lipsync Studio por tipo de entrada, templates de cena, os três modos do Audio, clonagem de voz com permissão, tradução para 18 idiomas, seis proporções de tela, Reframe; datado de 1 de agosto de 2026. Verificado em
- Blog do Higgsfield: How to make realistic AI talking and LipSync videos in 2026, seis elementos de um vídeo falado convincente, cinco problemas comuns e suas correções, um fluxo de seis passos e as limitações; 7 de julho de 2026. Verificado em
- Higgsfield: AI Talking Avatar, roteiro ou áudio mais um retrato; cenas faladas do Cinema Studio de até 30 segundos; dublagem para 18 idiomas; Reframe para 9:16, 1:1 ou 16:9 e upscale para 4K. Verificado em
- Higgsfield: AI Voice Over, motores de voz, até 10.000 caracteres por geração e diálogo com até 10 falantes no Eleven v4, Qwen Audio 3.0 TTS em 13 idiomas, exportação em MP3, WAV ou OGG. Verificado em
- Higgsfield: AI Voice Cloning, amostra curta, etapa de consentimento, ferramenta de localização do Supercomputer para inglês, espanhol ou francês com a voz do próprio falante. Verificado em
- Higgsfield: Higgsfield pricing, tabela comparativa lida no navegador: tarifas de crédito do Lipsync Studio e linha do Higgsfield Speak por plano em 9 de outubro de 2026; preços e créditos dos planos em 19 de outubro de 2026. Verificado em
- Higgsfield: Higgsfield Terms of Use (26 de julho de 2026), 5.3 sobre consentimento para todo rosto e voz enviados, 5.2(xi) sobre resultado apresentado como gerado por humanos. Verificado em
- VirtualSpeech: Average speaking rate and words per minute, cerca de 150 palavras por minuto no inglês americano de conversa, atribuído ao National Center for Voice and Speech; 20 de agosto de 2026. Verificado em
- Trustpilot, Reddit e YouTube: Relatos de usuários do Higgsfield, 52 fontes públicas sintetizadas, verificado em 28 de setembro de 2026. Verificado em
O que mudou nesta página
- Os preços do Higgsfield voltaram a subir: o Starter custa US$ 19 por mês por 270 créditos, na cobrança mensal ou anual, e o Plus 59 por mês ou 47 com cobrança anual por 1.200 créditos (antes: Starter 15 por 200, Plus 49 ou 39 por 1.000); o Ultra continua em 129, ou 99 com cobrança anual.
- Os preços do Higgsfield voltaram a cair: o Starter custa US$ 15 por mês por 200 créditos, na cobrança mensal ou anual, e o Plus 49 por mês ou 39 com cobrança anual por 1.000 créditos (antes: Starter 19 por 270, Plus 59 ou 47 por 1.200); o Ultra continua em 129, ou 99 com cobrança anual.
- Os preços do Higgsfield subiram de novo: o Starter custa US$ 19 por mês por 270 créditos, na cobrança mensal ou anual, e o Plus 59 por mês ou 47 com cobrança anual por 1.200 créditos (antes: Starter 15 por 200, Plus 49 ou 39 por 1.000); o Ultra continua em 129, ou 99 com cobrança anual.
- Os preços do Higgsfield voltaram atrás: o Starter custa US$ 15 por mês por 200 créditos, o Plus 49 por mês ou 39 com cobrança anual por 1.000 créditos, e o Ultra, a 129 ou 99 com cobrança anual, voltou a ter cartão (antes: Starter 19 por 270, Plus 59 ou 47 por 1.200).

Alexandre S.
Alexandre S. é estrategista criativo de anúncios e redator publicitário, com dez anos de experiência em marketing digital em vários canais.
Páginas relacionadas
-
 Guia Template de roteiro UGC para anúncios
Um template de roteiro de anúncio de UGC para copiar, 20 ganchos por tipo e exemplos cronometrados para 15, 30 e 45 segundos, para criadores ou atores de IA. Verificado em 15 de outubro de 2026.
-
 Melhores Narração com IA para anúncios
O plano gratuito do ElevenLabs proíbe anúncios; anúncios pagos começam no Starter, de US$ 6. Qual plano permite anúncios em nove ferramentas de voz e vídeo, verificado em 2 de outubro de 2026.
-
 Guia Seedance 2.0 no Higgsfield
Quanto custa o Seedance 2.0 no Higgsfield, quando ele é ilimitado, os limites de clipe e como o preço se compara ao do Dreamina e de outras plataformas. Verificado em 16 de outubro de 2026.
-
 Guia Higgsfield Marketing Studio
O Marketing Studio do Higgsfield transforma um link de produto em vídeos de UGC, fotos de produto e anúncios em imagem. Os passos, os créditos por clipe e as regras de anúncio, 18 de outubro de 2026.


