Higgsfield 的對嘴功能
對嘴(lip sync)能讓照片或影片裡的臉,依照腳本動嘴說話。在 Higgsfield 上,對嘴功能放在 Video 底下的 Lipsync Studio。你提供一張臉和一句台詞,從八個模型中選一個,就能得到說話影片。聲音來自 Higgsfield 的 Audio 分頁,也可以複製自己的聲音。
| 位置 | 功能簡介 | 你要提供 | 點數 |
|---|---|---|---|
| Lipsync Studio(圖片模型) | 讓靜態人臉開口說話 | 一張肖像和一份腳本 | 720p 下每 5 秒約 12 至 14(Infinite Talk:每 2 秒約 12) |
| Lipsync Studio(影片模型) | 替現有影片重新對嘴 | 一段影片和新的音訊 | 每 5 秒約 2(Kling Lipsync,720p) |
| 原生音訊的影片模型 | 臉和聲音一次生成 | 提示詞和起始畫面 | 依模型而定;Seedance 2.0 在 720p 下每 5 秒約 22 |
| Audio | 文字轉語音、變聲、翻譯成 18 種語言 | 一份腳本或一段影片 | 按下 Generate 前會顯示費用 |
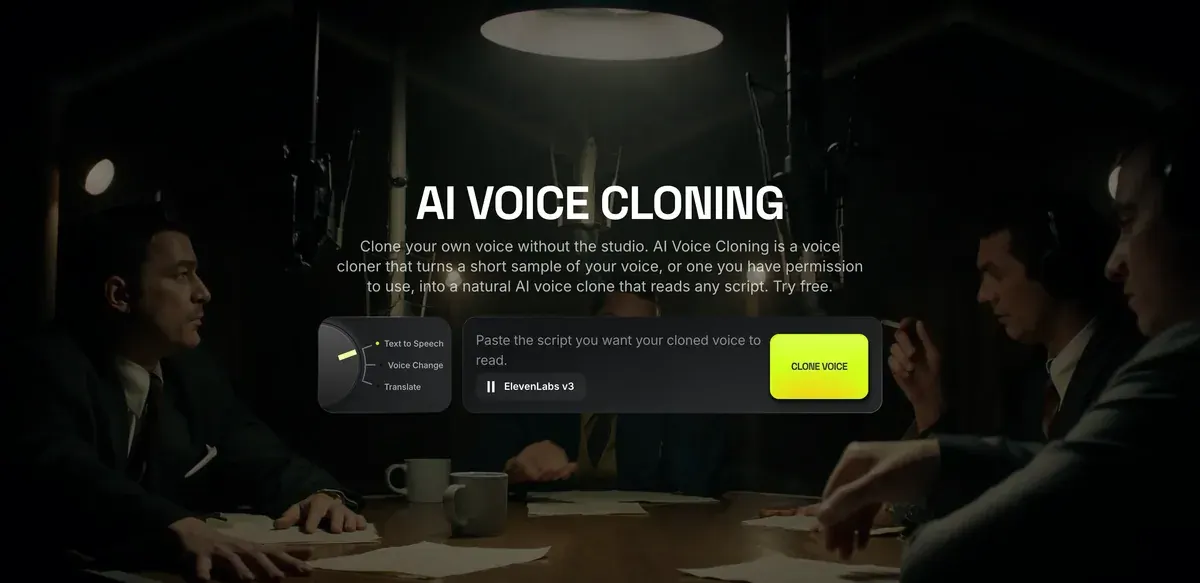
| 聲音複製(在 Audio 內) | 可重複使用的聲音複本 | 一段簡短的 MP3 或 WAV 樣本,並取得本人同意 | 按下 Generate 前會顯示費用 |
左右滑動查看全部 4 欄
Higgsfield 對嘴是什麼?
Higgsfield 的對嘴其實是兩個搭配使用的工具:Audio 負責做聲音,Lipsync Studio 負責把聲音放進一張臉裡。Higgsfield 的說明文章講得很直白:說話的嘴「是 Video 底下的 Lipsync Studio」,聲音「是 Audio。它們是兩個獨立的工具」。
How do I use lipsync, voiceover, and aspect ratios?
Voice generation, voice change, and translation live in Audio, while making a character talk (lip sync) lives in Lipsync Studio, which offers several models for image-to-video and video-to-video talking clips. Some video models also generate audio together with video in a single pass. Aspect ratio is set per generation inside each tool: common options are 9:16 for vertical, 16:9 for horizontal, and 1:1 for square, and not every model supports every ratio.
第三條路可以省掉搭配。部分影片模型,包括 Seedance 2.5、Seedance 2.0 和 Kling 3.0,能「一次完成」畫面和語音。說明文章點出差別:Lipsync Studio 是「事後替現有圖片或影片加上說話的嘴」,原生音訊則是「從一開始就完美對位」。
做廣告時,Lipsync Studio 可以讓你寫定確切的台詞、挑聲音、固定同一張臉。原生音訊模型則一次生成臉和聲音,但對語氣表現的控制較少。
AI Talking Avatar 頁面是 Higgsfield 通往同一批工具的入口:先給腳本或音軌,再提供「一張肖像照,或你在 Higgsfield 生成的臉」,然後預覽並下載。
說話影片怎麼做:步驟教學
七個步驟,從空白頁面做到可以剪進廣告的影片。
- 打開 Higgsfield 自己的教學 How do I use lipsync, voiceover, and aspect ratios?,放在手邊對照。接著從 Video 選單打開 Lipsync Studio;說明中心把這個工具標為「Create Talking Clips」。
How do I create a lip-synced (talking) video?
Lip sync lives in Lipsync Studio (higgsfield.ai → Video → Lipsync Studio, “Create Talking Clips”). Upload a character image or video, type what the character should say in Audio text (or generate the audio), pick a model, and generate. Each model offers scene templates (General, Selfie, Podcast, Car Talking, and more) to set the look of the clip.
- 先寫腳本,其他都排後面,語速抓每秒約兩個半單字(下一節有字數對照)。寫成真人講話的口氣,語氣有變化的地方用括號標註,例如 [warm] 或 [direct]。
- 挑一張臉。用靜態圖的話,上傳清晰、光線均勻、正面的肖像,表情要「輕鬆自然」;Higgsfield 的部落格說,「證件照式的中性表情」會讓模型「沒有可以做動畫的依據」。要重新配音的影片,請用鏡頭穩定、頭部不亂動的素材。用 Soul 生成的虛構人臉可以用,真人的臉則需要本人同意。
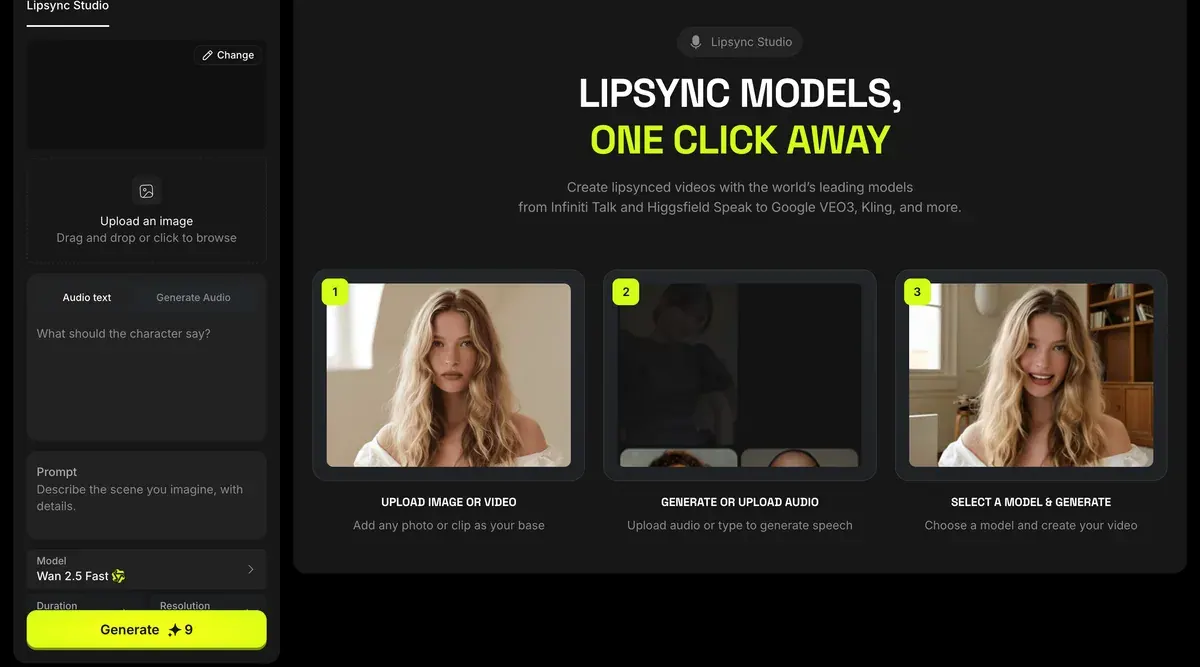
- 做聲音。在 Lipsync Studio 的音訊欄輸入台詞,或先到 Audio 做好音軌。Audio 可選預設聲音或你自己的聲音複本,並用情緒滑桿調整。Higgsfield 的部落格把音訊放第一位是有原因的:「不管用哪個模型,平板的音軌只會產出平板的臉。」
- 選模型和場景範本。範本有 General、Selfie、Podcast 和 Car Talking。確認前先設定比例:TikTok、Reels 和 Shorts 用 9:16。比例因模型而異,有些模型會直接從你的圖片讀取比例。
- 生成後,把整張臉看完。檢查眼睛、頭部,以及表情和聲音是否搭配;嘴型通常是最沒問題的部分。重試時一次只改一個地方,依 Higgsfield 建議的順序:先腳本,再圖片,最後模型。
- 匯出。要改變完成影片的畫幅,用 Edit,再選 Reframe。要做其他語言版本,就在 Audio 用 Translate 處理這支影片。
What voice and audio tools are available?
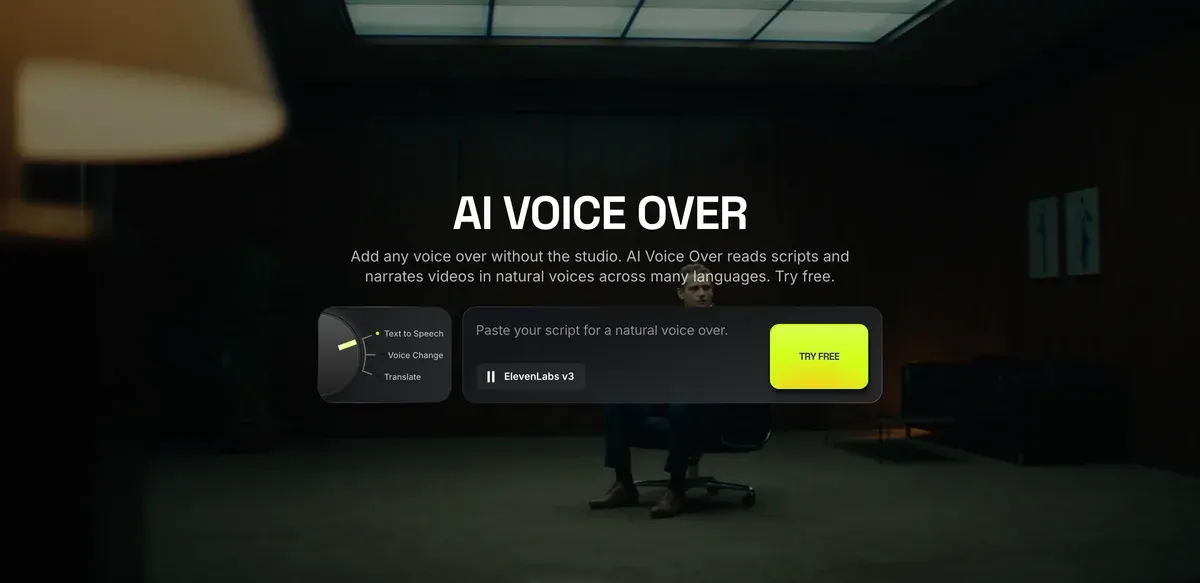
Three modes. Text to Speech generates a voice track from text; Voice Change replaces the existing voice in a clip with a different one; Translate translates and re-voices your content in another language (18 languages).
Your own voice. Create custom voice → Add Voice lets you record a sample or upload one (MP3 or WAV), then clones it into a reusable voice you can select for any generation. Only clone a voice that is your own or one you have the person’s permission to use.
想逐一了解 Higgsfield 的每個分頁,請看 Higgsfield 教學。
哪些模型能對嘴?費用多少
Lipsync Studio 有六個圖片模型和兩個影片模型。Higgsfield 自家的引擎 Higgsfield Speak 2.0 只在 Plus 和 Ultra 提供。
| 模型 | 輸入 | Higgsfield 的說法 | 點數 |
|---|---|---|---|
| Higgsfield Speak 2.0 | 圖片 | 優先佇列速度 | 720p 下每 5 秒約 14 |
| Wan 2.5 Speak | 圖片 | 480p 至 1080p,含音訊 | 720p 下每 5 秒約 12 |
| Infinite Talk | 圖片 | 長篇說話影片 | 720p 下每 2 秒約 12 |
| Kling 2.6 Lipsync | 圖片 | 最高 1080p,含音訊 | 表上沒有這個名稱;表中的 Kling Speak 列為每 2 秒約 2 |
| Kling Avatars 2.0 | 圖片 | 說話的虛擬人像、較長的影片 | 表上沒有這個名稱 |
| Google Veo 3.1 | 圖片 | 電影感說話影片 | Lipsync Studio 未列出 |
| Kling Lipsync | 影片 | 替現有影片對嘴 | 720p 下每 5 秒約 2 |
| Sync Lipsync 3 | 影片 | 精準對嘴,最高 4K | 4K 下每 2 秒約 18 |
左右滑動查看全部 4 欄
模型名稱和備註取自對嘴說明文章;點數取自定價頁的比較表,2026 年 10 月 9 日查閱。
Lipsync Studio models
Image to video. Google Veo 3.1 (cinematic talking video); Kling 2.6 Lipsync (up to 1080p, with audio); Wan 2.5 Speak (480p to 1080p, with audio); Kling Avatars 2.0 (talking avatars, longer clips); Higgsfield Speak 2.0 (priority-queue speed); Infinite Talk (long-form talking video).
Video to video. Kling Lipsync (lip sync on existing footage); Sync Lipsync 3 (precise lip sync, up to 4K).
以上述費率,舉三個實際花費的例子:
- 用 Speak 2.0 在 720p 下做一支 15 秒的主持人影片:三個 5 秒區塊,每個約 14,共約 42 點數。
- 替一支已在投放的 30 秒廣告重新配音,用 Kling Lipsync:六個區塊,每個約 2,共約 12 點數。這是用已驗證的素材測試新開場鉤子(hook)最便宜的方法。
- 同樣 15 秒,用 Sync Lipsync 3 在 4K 下:每 2 秒約 18 點數,共約 135 點數。
有 Speak 的最便宜方案是 Plus,每月 49 美元,含每月 1,000 點數。以每支約 42 點數計算,不做其他用途的話,約可在 Speak 2.0 上做 23 支主持人影片。
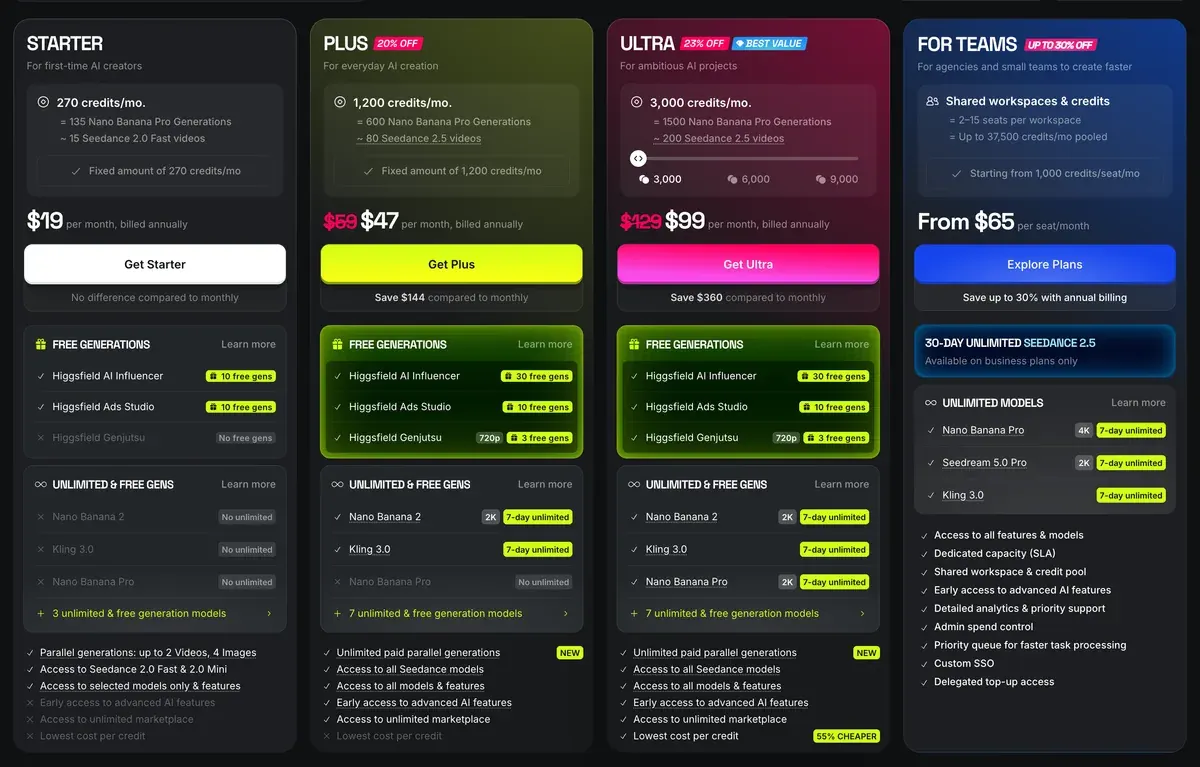
有兩項使用者反映和帳單有關。52 個公開來源中有八個說,生成速度慢或失敗,依然會扣點數(Reddit、YouTube)。六個說點數在每個計費週期結束時到期(Trustpilot、YouTube)。所有方案和點數:Higgsfield 價格。
怎麼寫出對嘴效果好的腳本
對嘴腳本是寫給耳朵聽的,所以長度要用秒數來抓。美式英語日常對話約每分鐘 150 個單字,VirtualSpeech 稱此數字來自 National Center for Voice and Speech。換算下來,每秒兩個半單字。
| 片段長度 | 單字數上限 | 可容納 |
|---|---|---|
| 5 s | 12 | 一句開場鉤子 |
| 8 s | 20 | 鉤子加一個理由 |
| 15 s | 37 | 鉤子、產品、CTA |
| 30 s | 75 | 完整的短廣告,最好剪成兩段影片 |
左右滑動查看全部 3 欄
字數請比上限少幾個。停頓和括號裡的提示也要花時間,而趕著唸的句子最容易讓嘴型出錯。
在 Higgsfield 上,五個原則最關鍵:
- 每行一個重點。每句各有自己的換氣,臉部在句與句之間會重置。
- 照說話的方式寫。Higgsfield 的部落格拿「We are pleased to announce our latest product update」來對照「Today I want to show you something we’ve been working on for a while.」。
- 語氣有變化的地方,用括號標出:[warm]、[calm]、[direct]。Higgsfield 說,以表現為基礎的模型會「用這些來調整臉部動畫參數」。
- 數字照唸法拼出來(「twenty per cent」),品牌名稱照發音寫。聲音遇到符號只能用猜的。
- 一次只放一位說話者。Higgsfield 把對話重疊列為限制之一;每位說話者各做一支影片。
Step-by-step: how to improve AI lipsync quality
Write for spoken delivery, not for reading. Formal writing produces robotic delivery. Conversational language produces more natural facial animation because the model has more expressive cues to work from. Add emotion cues in brackets where the tone should shift: [excited], [calm], [direct].
Generate expressive audio first. Voice is the input that drives facial animation. Monotone delivery reduces the range of facial motion the model generates. A flat audio track produces a flat face regardless of which model you use.
一份 15 秒的主持人腳本,共 28 個口說單字,情境是把手機立在浴室架上:
[warm] Morning routine, one step.
[direct] Two drops of this serum, pat it in, done.
[light] No layering three bottles.
[calm] It's in the link below, if your shelf is full too.
主持人展示產品並念出品牌的宣稱。她絕不說自己已經用了好幾個月:從 AI 臉孔說出來,那就是偽造的推薦見證(AI UGC 與法律)。依廣告形式整理的更多腳本結構:UGC 腳本範本。
嘴型對不上時:常見解法
Higgsfield 的部落格說,對嘴準確度在 2026 年「基本上已經解決」。觀眾真正會注意到的,是嘴以外的一切:僵住的臉、直瞪的眼睛、循環的點頭,以及不同影片間臉會變。
How to make an AI Talking Video Feel Real?
A believable LipSync video coordinates six elements simultaneously: lip movement aligned to speech phonemes; facial expressions that shift with emotional content; eye movement; subtle head motion that follows speech rhythm; gestures that match meaning; voice delivery with pacing, pauses, and tonal variation.
Frozen facial expressions. The cause is usually a source image with a neutral, flat expression. Use an image where the subject has a light, natural expression, not a passport-photo neutral face. Adding emotion cues to the script also helps: words like [excited], [thoughtful], or [warm] in brackets give performance-based models a signal to animate from.
| 你看到的狀況 | 原因 | 解法 |
|---|---|---|
| 只有嘴在動 | 平淡、無表情的來源照片 | 表情輕鬆的肖像;用括號加提示 |
| 聲音激動,臉卻沒表情 | 聲音和臉分開生成 | 讓聲音的情緒配合臉部,或改用原生音訊模型 |
| 眼神固定直瞪,眨眼間隔一致 | 模型的眼部動作少 | 影片短於 20 秒 |
| 每 8 至 10 秒就出現同樣的點頭 | 長影片的動作庫太小 | 影片短於 30 秒,再剪接在一起 |
| 每支影片換一張新臉 | 沒有鎖定身分 | 訓練一次 Soul ID,重複使用 |
| 轉頭時嘴型不對 | 側面角度或臉被遮住 | 用正面的來源,沒有眼鏡,嘴邊也沒有頭髮遮住 |
| 口音不對 | 腳本用預設聲音 | 選目標語言的聲音;Qwen Audio 3.0 TTS 可直接用白話描述方言 |
| 兩個人搶著說話 | 對話重疊 | 每支影片只有一位說話者,在剪輯時接起來 |
左右滑動查看全部 3 欄
前五列的解法是 Higgsfield 自己提出的,出自它的對嘴部落格文章。側面角度和多人說話兩列取自同一篇文章列出的限制;口音那列則取自配音頁面。
How do you fix the most common problems?
Repetitive gestures. Limited motion libraries produce the same head nod or shoulder movement every 8-10 seconds. The fix is clip length: keep individual generations under 30 seconds and cut between them.
Character drift. The same person looking different across multiple clips is a persistent identity problem, not a LipSync problem. The fix is to use a trained identity layer rather than re-uploading the same photo each time.
某一版差不多對了,就只改一個輸入再重跑一次。一次改好幾項,你就分不出是哪一項起了作用。
廣告中的說話影片
有三種廣告形式很依賴對嘴,各自用到 Higgsfield 的不同部分。
第一種是真人口吻的 UGC 口播:創作者手拿你的產品,對著手機說話。先在 Soul 生成一張臉,用 Soul ID 鎖定,再用 Lipsync Studio 或 Seedance 讓它開口。含提示詞的完整做法請見 Higgsfield 擬真 AI UGC 角色。想做長期固定的虛擬創作者,請看 AI 網紅指南。
第二種是產品說明:由主持人帶你看產品的功能。Higgsfield 的 talking-avatar 頁面說,Marketing Studio「新增 100+ 個現成虛擬人像」供產品廣告使用,省去找演員的工夫(Marketing Studio 指南)。Cinema Studio 則能做出「最長 30 秒的電影感說話虛擬人像場景,並可用圖片、影片和音訊參考臉部、產品與風格」。
第三種是把已經在賣的廣告翻成其他語言。Audio 的 Translate 可以把影片重新配音成 18 種語言。在聲音複製頁面上,Supercomputer 的在地化工具能把語音翻成「英文、西班牙文或法文」,同時保留說話者的聲音。接著用 Kling Lipsync 重新對嘴,費率是整個工作室最低的。
52 個公開來源中有五個認為,Soul ID、Elements 和參考圖能讓角色在不同鏡頭間保持一致(YouTube、Reddit)。有了這份一致性,一位主持人就能撐起整檔廣告活動。
有兩條規則適用於所有形式。第一條是真人臉孔或聲音要有同意。Higgsfield 條款第 5.3 條要求你保證取得「適用法律要求的、來自每位臉孔或聲音出現在內容中的個人的所有同意、授權與許可」。
第二條是對主持人要誠實。第 5.2(xi) 條禁止呈現「任何輸出內容為人類生成,但實際並非如此」。各平台標示規定:TikTok AI 標示和 Meta AI 揭露規定。
換臉不是換聲音,那是另一個工具:Higgsfield 換臉與 Recast。所有 Higgsfield 的頁面都在 Higgsfield 專區,方案與條款在 Higgsfield 工具介紹。
Higgsfield 對嘴常見問題
Higgsfield 能替我自己的影片對嘴嗎?
可以。Lipsync Studio 的兩個影片模型,能替你上傳的影片重新對嘴。Kling Lipsync 在 720p 下約每 5 秒 2 點數;Sync Lipsync 3 最高到 4K。Higgsfield 的部落格要求素材「穩定,臉部清晰無遮擋,頭部位置一致」。
可以用我自己的聲音嗎?
可以。在 Audio 選 Create custom voice,然後錄製或上傳一小段 MP3 或 WAV 樣本。Higgsfield 的規定是:「只能複製你自己的聲音,或你有權使用的聲音。」複製前,聲音複製頁面還會多一道同意步驟。
Higgsfield 的說話影片最長能多長?
對嘴說明文章沒有為 Lipsync Studio 設定上限;文中列為長篇說話影片模型的是 Infinite Talk。Cinema Studio 的說話場景最長 30 秒。Higgsfield 自己的建議是每次生成控制在 30 秒內,再用剪接串起來。
該用 Lipsync Studio 還是 Seedance?
需要掌控確切台詞和聲音時用 Lipsync Studio,例如有腳本的主持人廣告。更在意一次生成就到位時用 Seedance:它把聲音和畫面一起生成。Higgsfield 上 Seedance 的完整介紹:Seedance 指南。
資料來源
- Higgsfield 說明中心:How do I use lipsync, voiceover, and aspect ratios?,Lipsync Studio 依輸入分類的八個模型、場景範本、Audio 的三種模式、經同意的聲音複製、翻譯成 18 種語言、六種畫面比例、Reframe;標註日期 2026 年 8 月 1 日。確認於
- Higgsfield 部落格:How to make realistic AI talking and LipSync videos in 2026,可信說話影片的六個要素、五個常見問題與解法、六步驟流程及限制;2026 年 7 月 7 日。確認於
- Higgsfield:AI Talking Avatar,腳本或音訊加一張肖像;Cinema Studio 說話場景最長 30 秒;配音成 18 種語言;Reframe 成 9:16、1:1 或 16:9,並放大畫質到 4K。確認於
- Higgsfield:AI Voice Over,聲音引擎、每次最多 10,000 字元、Eleven v4 最多 10 位說話者的對話、Qwen Audio 3.0 TTS 支援 13 種語言、可匯出 MP3、WAV 或 OGG。確認於
- Higgsfield:AI Voice Cloning,簡短樣本、同意步驟、Supercomputer 的在地化工具可用說話者自己的聲音輸出英文、西班牙文或法文。確認於
- Higgsfield:Higgsfield pricing,在瀏覽器讀取的比較表:2026 年 10 月 9 日各方案的 Lipsync Studio 點數費率和 Higgsfield Speak 列;2026 年 10 月 19 日的方案價格與點數。確認於
- Higgsfield:Higgsfield Terms of Use (26 July 2026),5.3 規定上傳的每張臉孔與聲音都要經過同意,5.2(xi) 規定不得把輸出內容說成人類生成。確認於
- VirtualSpeech:Average speaking rate and words per minute,美式英語對話約每分鐘 150 個單字,出處為 National Center for Voice and Speech;2026 年 8 月 20 日。確認於
- Trustpilot、Reddit 與 YouTube:Higgsfield 使用者反映,彙整 52 個公開來源,確認於 2026 年 9 月 28 日。確認於
本頁更新紀錄
- Higgsfield 價格回落:Starter 按月或按年計費皆為每月 15 美元、200 點,Plus 每月 49 美元,按年計費每月 39 美元,含 1,000 點(原為 Starter 19 美元、270 點;Plus 59 美元,按年計費 47 美元、1,200 點);Ultra 維持每月 129 美元,按年計費每月 99 美元。
- Higgsfield 價格再度上漲:Starter 按月或按年計費皆為每月 19 美元、270 點,Plus 每月 59 美元,按年計費每月 47 美元,含 1,200 點(原為 Starter 15 美元、200 點;Plus 49 美元,按年計費 39 美元、1,000 點);Ultra 維持每月 129 美元,按年計費每月 99 美元。
- Higgsfield 價格調回:Starter 每月 15 美元、200 點,Plus 每月 49 美元,按年計費每月 39 美元,含 1,000 點,Ultra 每月 129 美元,按年計費每月 99 美元,重新有了方案卡(原為 Starter 19 美元、270 點;Plus 59 美元,按年計費 47 美元、1,200 點)。

相關頁面
-
 指南 廣告用 UGC 腳本範本
可直接套用的 UGC 廣告腳本範本、依類型整理的 20 種開場鉤子,以及 15、30、45 秒的時間軸範例,創作者與 AI 演員都適用。確認於 2026 年 10 月 15 日。
-
 推薦 廣告用 AI 配音
ElevenLabs 的免費方案禁止用於廣告;要從 6 美元的 Starter 方案起才能用於廣告。十款配音與影片工具各從哪個方案開始允許廣告用途,2026 年 10 月 2 日確認。
-
 指南 Higgsfield 上的 Seedance 2.0
Seedance 2.0 在 Higgsfield 的收費、何時可無限使用、單支影片的限制,以及與 Dreamina 等平台的價格比較。2026 年 10 月 16 日確認。
-
 指南 Higgsfield Marketing Studio
Higgsfield Marketing Studio 能把產品連結變成 UGC 影片、產品照與圖片廣告。操作步驟、每支影片的點數與廣告規則,截至 2026 年 10 月 18 日。


