La synchronisation labiale (lip-sync) sur Higgsfield
Le lip sync (synchronisation labiale) fait bouger la bouche d’un visage, dans une photo ou une vidéo, en suivant un texte. Sur Higgsfield, il se trouve dans Lipsync Studio, sous Video. Vous apportez un visage et une réplique, choisissez l’un des huit modèles et obtenez un clip parlé. La voix vient de l’onglet Audio de Higgsfield, où vous pouvez cloner la vôtre.
| Où | Ce qu'il fait | Ce que vous apportez | Crédits |
|---|---|---|---|
| Lipsync Studio, modèles d’image | Fait parler un visage fixe | Un portrait et un texte | Environ 12 à 14 par 5 s en 720p (Infinite Talk : environ 12 par 2 s) |
| Lipsync Studio, modèles vidéo | Resynchronise la bouche sur des images existantes | Un clip et un nouvel audio | Environ 2 par 5 s (Kling Lipsync, 720p) |
| Modèles vidéo avec audio natif | Visage et voix créés en une seule passe | Un prompt et une image de départ | Selon le modèle ; Seedance 2.0 : environ 22 par 5 s en 720p |
| Audio | Synthèse vocale, changement de voix, traduction en 18 langues | Un texte ou un clip | Affiché sur Generate avant que vous confirmiez |
| Clonage de voix, dans Audio | Une copie réutilisable d’une voix | Un court échantillon MP3 ou WAV, avec consentement | Affiché sur Generate avant que vous confirmiez |
Faites défiler sur le côté pour voir les 4 colonnes
Qu’est-ce que le lip sync Higgsfield ?
Le lip sync Higgsfield repose sur deux outils qui vont de pair. Audio fabrique la voix. Lipsync Studio la pose sur un visage. L’article d’aide de Higgsfield est clair : une bouche qui parle, c’est « Lipsync Studio, sous Video », une voix, c’est « Audio. Ce sont deux outils séparés. »
How do I use lipsync, voiceover, and aspect ratios?
Voice generation, voice change, and translation live in Audio, while making a character talk (lip sync) lives in Lipsync Studio, which offers several models for image-to-video and video-to-video talking clips. Some video models also generate audio together with video in a single pass. Aspect ratio is set per generation inside each tool: common options are 9:16 for vertical, 16:9 for horizontal, and 1:1 for square, and not every model supports every ratio.
Une troisième voie évite ce duo. Certains modèles vidéo, dont Seedance 2.5, Seedance 2.0 et Kling 3.0, génèrent la parole avec l’image « en une seule passe ». L’article d’aide explique la différence : Lipsync Studio « ajoute une bouche parlante à une image ou une vidéo existante après coup », tandis que l’audio natif offre « un alignement physique parfait dès le départ ».
Pour une pub, Lipsync Studio permet d’écrire les mots exacts, de choisir la voix et de garder le même visage. Un modèle à audio natif crée visage et voix d’un seul tenant, avec moins de contrôle sur l’interprétation.
La page AI Talking Avatar est la porte d’entrée de Higgsfield vers les mêmes outils : un texte ou une piste audio, puis « une photo portrait ou un visage généré sur Higgsfield », puis aperçu et téléchargement.
Créer une vidéo parlante, étape par étape
Sept étapes mènent d’une page blanche à un clip que vous pouvez monter dans une pub.
- Ouvrez le guide de Higgsfield, How do I use lipsync, voiceover, and aspect ratios?, et gardez-le à portée de main. Ouvrez ensuite Lipsync Studio depuis le menu Video ; le centre d’aide nomme l’outil « Create Talking Clips ».
How do I create a lip-synced (talking) video?
Lip sync lives in Lipsync Studio (higgsfield.ai → Video → Lipsync Studio, “Create Talking Clips”). Upload a character image or video, type what the character should say in Audio text (or generate the audio), pick a model, and generate. Each model offers scene templates (General, Selfie, Podcast, Car Talking, and more) to set the look of the clip.
- Écrivez d’abord le texte, à raison d’environ deux mots et demi par seconde (la section suivante donne les chiffres). Écrivez comme on parle, avec une indication entre crochets, du type [warm] ou [direct], là où le ton change.
- Choisissez le visage. Pour une image fixe, prenez un portrait net, bien éclairé, de face, avec « une expression légère et naturelle » ; le blog de Higgsfield explique qu’un « visage neutre de photo d’identité » ne donne au modèle « rien à animer ». Pour un clip à re-doubler, prenez des images stables, la tête immobile. Un visage inventé dans Soul convient ; le visage d’une personne réelle exige son consentement.
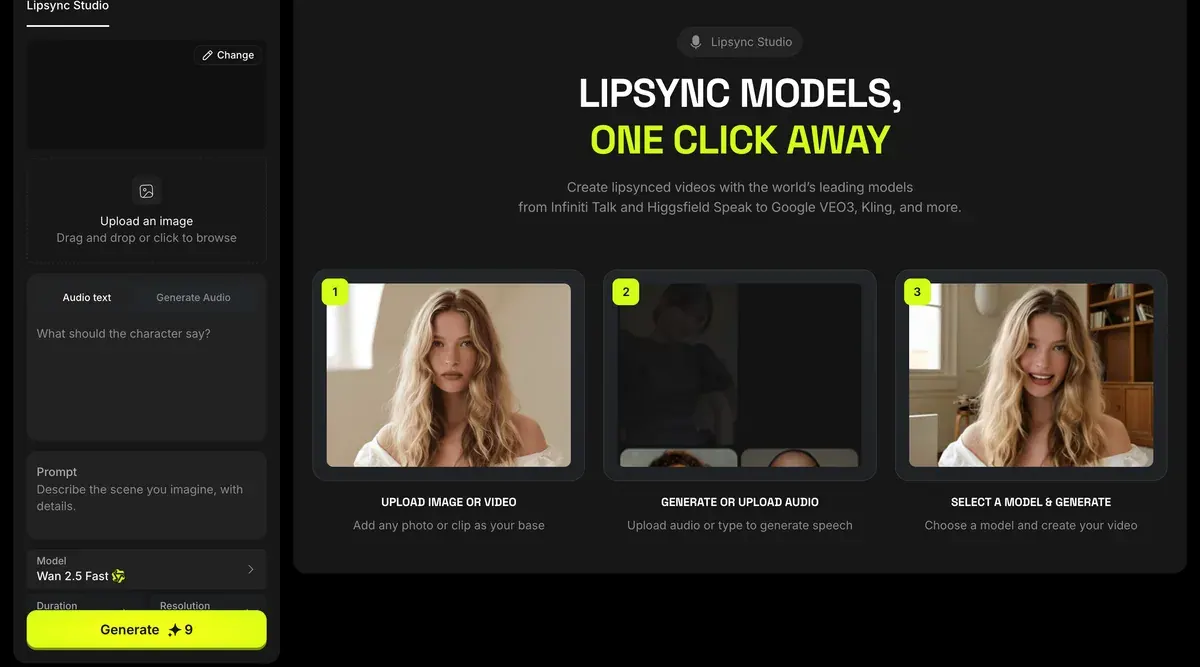
- Créez la voix. Saisissez la réplique dans la zone audio de Lipsync Studio, ou construisez d’abord la piste dans Audio. Audio propose une voix prédéfinie ou le clone de la vôtre, réglée avec des curseurs d’émotion. Le blog de Higgsfield place l’audio en premier pour une raison : « Une piste audio plate donne un visage plat, quel que soit le modèle. »
- Choisissez le modèle et le gabarit de scène. Les gabarits incluent General, Selfie, Podcast et Car Talking. Réglez le format avant de confirmer : 9:16 pour TikTok, Reels et Shorts. Les formats varient selon le modèle, et certains le lisent dans votre image.
- Lancez la génération, puis regardez tout le visage. Vérifiez les yeux, la tête et si l’expression colle à la voix ; la bouche est la partie qui fonctionne en général. À chaque nouvel essai, ne changez qu’un élément, dans l’ordre de Higgsfield : texte, puis image, puis modèle.
- Exportez. Pour changer le format d’un clip terminé, passez par Edit, puis Reframe. Pour une version dans une autre langue, faites passer le clip dans Translate, côté Audio.
What voice and audio tools are available?
Three modes. Text to Speech generates a voice track from text; Voice Change replaces the existing voice in a clip with a different one; Translate translates and re-voices your content in another language (18 languages).
Your own voice. Create custom voice → Add Voice lets you record a sample or upload one (MP3 or WAV), then clones it into a reusable voice you can select for any generation. Only clone a voice that is your own or one you have the person’s permission to use.
Pour un tour de tous les onglets de Higgsfield, voir comment utiliser Higgsfield.
Quels modèles font du lip sync, et à quel prix
Lipsync Studio compte six modèles d’image et deux modèles vidéo. Higgsfield Speak 2.0, le moteur maison, est réservé à Plus et Ultra.
| Modèle | Entrée | Ce que dit Higgsfield | Crédits |
|---|---|---|---|
| Higgsfield Speak 2.0 | Image | File d’attente prioritaire | Environ 14 par 5 s en 720p |
| Wan 2.5 Speak | Image | De 480p à 1080p, avec audio | Environ 12 par 5 s en 720p |
| Infinite Talk | Image | Vidéo parlante longue durée | Environ 12 par 2 s en 720p |
| Kling 2.6 Lipsync | Image | Jusqu’à 1080p, avec audio | Non listé sous ce nom ; la ligne Kling Speak du tableau indique environ 2 par 2 s |
| Kling Avatars 2.0 | Image | Avatars parlants, clips plus longs | Non listé sous ce nom |
| Google Veo 3.1 | Image | Vidéo parlante cinématique | Non listé pour Lipsync Studio |
| Kling Lipsync | Vidéo | Lip sync sur des images existantes | Environ 2 par 5 s en 720p |
| Sync Lipsync 3 | Vidéo | Lip sync précis, jusqu’à 4K | Environ 18 par 2 s en 4K |
Faites défiler sur le côté pour voir les 4 colonnes
Les noms et notes des modèles viennent de l’article d’aide sur le lip sync ; les crédits, du tableau comparatif de la page de tarifs, consulté le 9 octobre 2026.
Lipsync Studio models
Image to video. Google Veo 3.1 (cinematic talking video); Kling 2.6 Lipsync (up to 1080p, with audio); Wan 2.5 Speak (480p to 1080p, with audio); Kling Avatars 2.0 (talking avatars, longer clips); Higgsfield Speak 2.0 (priority-queue speed); Infinite Talk (long-form talking video).
Video to video. Kling Lipsync (lip sync on existing footage); Sync Lipsync 3 (precise lip sync, up to 4K).
Trois exemples chiffrés, à ces tarifs :
- Un clip de présentateur de 15 secondes sur Speak 2.0 en 720p : trois blocs de 5 secondes à environ 14, soit environ 42 crédits.
- Re-doubler une pub de 30 secondes déjà diffusée, avec Kling Lipsync : six blocs à environ 2, soit environ 12 crédits. C’est la façon la moins chère de tester une nouvelle accroche (hook) sur des images qui ont fait leurs preuves.
- Les mêmes 15 secondes sur Sync Lipsync 3 en 4K : environ 18 crédits toutes les 2 secondes, soit environ 135 crédits.
Plus, l’offre la moins chère avec Speak, coûte 49 $ par mois pour 1 000 crédits mensuels. À environ 42 crédits le clip, cela représente environ 23 clips de présentateur sur Speak 2.0, si rien d’autre n’utilise les crédits.
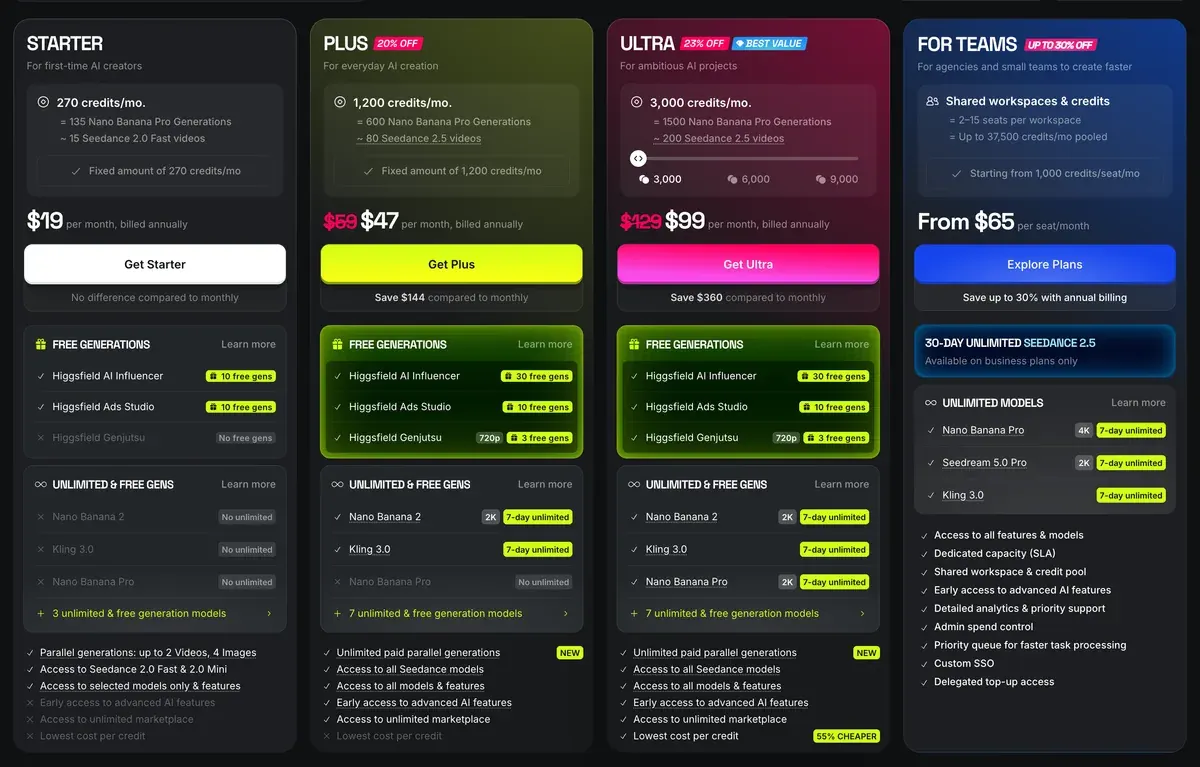
Deux retours d’utilisateurs pèsent sur la facture. Huit sources publiques sur 52 disent que les générations sont lentes ou échouent tout en coûtant des crédits (Reddit, YouTube). Six disent que les crédits expirent à la fin de chaque période (Trustpilot, YouTube). Toutes les formules et leurs crédits : tarifs Higgsfield.
Écrire un texte qui se synchronise bien
Un script de lip sync s’écrit pour l’oreille : sa longueur se compte en secondes. L’anglais américain de conversation tourne autour de 150 mots par minute, un chiffre que VirtualSpeech attribue au National Center for Voice and Speech. Cela fait deux mots et demi par seconde.
| Durée du clip | Mots, au maximum | Convient pour |
|---|---|---|
| 5 s | 12 | Une phrase d’accroche |
| 8 s | 20 | Une accroche et une raison |
| 15 s | 37 | Accroche, produit, appel à l’action |
| 30 s | 75 | Une pub courte complète, plus facile à monter en deux clips |
Faites défiler sur le côté pour voir les 3 colonnes
Restez quelques mots sous le budget. Les pauses et les indications entre crochets prennent aussi du temps, et c’est une réplique débitée trop vite qui fait décrocher les bouches.
Cinq règles font la différence sur Higgsfield :
- Une idée par phrase. Chaque phrase a sa propre respiration, ce qui remet le visage à zéro entre deux.
- Écrivez comme vous parlez. Le blog de Higgsfield oppose « Nous avons le plaisir de vous annoncer la dernière mise à jour de notre produit » à « Aujourd’hui, je voudrais vous montrer un truc sur lequel on travaille depuis un moment. »
- Notez le ton entre crochets quand il change : [warm], [calm], [direct]. Higgsfield précise que les modèles basés sur la performance « s’en servent pour faire varier les paramètres d’animation du visage ».
- Écrivez les nombres comme on les dit (« vingt pour cent »), et les noms de marque comme ils se prononcent. Une voix devine mal les symboles.
- Gardez un seul locuteur. Higgsfield range le dialogue qui se chevauche parmi les limites ; faites de chaque locuteur un clip séparé.
Step-by-step: how to improve AI lipsync quality
Write for spoken delivery, not for reading. Formal writing produces robotic delivery. Conversational language produces more natural facial animation because the model has more expressive cues to work from. Add emotion cues in brackets where the tone should shift: [excited], [calm], [direct].
Generate expressive audio first. Voice is the input that drives facial animation. Monotone delivery reduces the range of facial motion the model generates. A flat audio track produces a flat face regardless of which model you use.
Un script de présentateur de 15 secondes, 28 mots prononcés, pour un téléphone posé sur une étagère de salle de bains :
[warm] Morning routine, one step.
[direct] Two drops of this serum, pat it in, done.
[light] No layering three bottles.
[calm] It's in the link below, if your shelf is full too.
La présentatrice montre le produit et lit l’argument de la marque. Elle ne dit jamais qu’elle l’utilise depuis des mois : venant d’un visage IA, ce serait un faux témoignage (l’UGC IA et la loi). Plus de structures de script par format de pub : modèle de script UGC.
Quand la bouche décroche : les solutions courantes
Le blog de Higgsfield juge la précision du lip sync « largement résolue en 2026 ». Ce que les spectateurs remarquent, c’est tout sauf la bouche : un visage figé, un regard fixe, un hochement de tête en boucle, un visage qui change d’un clip à l’autre.
How to make an AI Talking Video Feel Real?
A believable LipSync video coordinates six elements simultaneously: lip movement aligned to speech phonemes; facial expressions that shift with emotional content; eye movement; subtle head motion that follows speech rhythm; gestures that match meaning; voice delivery with pacing, pauses, and tonal variation.
Frozen facial expressions. The cause is usually a source image with a neutral, flat expression. Use an image where the subject has a light, natural expression, not a passport-photo neutral face. Adding emotion cues to the script also helps: words like [excited], [thoughtful], or [warm] in brackets give performance-based models a signal to animate from.
| Ce que vous voyez | Pourquoi | Solution |
|---|---|---|
| Seule la bouche bouge | Une photo source plate et neutre | Un portrait avec une expression légère ; indications entre crochets |
| Voix enthousiaste, visage vide | Voix et visage créés en passes séparées | Accordez l’énergie de la voix au visage, ou prenez un modèle à audio natif |
| Regard fixe, clignements réguliers | Peu de mouvement des yeux dans le modèle | Clips de moins de 20 secondes |
| Le même hochement de tête toutes les 8 à 10 s | Une petite bibliothèque de mouvements sur un clip long | Clips de moins de 30 secondes, montés bout à bout |
| Un nouveau visage à chaque clip | Aucun verrouillage d’identité | Entraînez un Soul ID une fois et réutilisez-le |
| Lèvres décalées quand la tête tourne | Angle de côté ou visage couvert | Source de face, sans lunettes ni cheveux devant la bouche |
| Mauvais accent | Voix par défaut pour le texte | Choisissez une voix dans la langue cible ; Qwen Audio 3.0 TTS comprend le dialecte décrit avec des mots simples |
| Deux personnes qui se coupent la parole | Dialogue qui se chevauche | Un locuteur par clip, assemblés au montage |
Faites défiler sur le côté pour voir les 3 colonnes
Les solutions des cinq premières lignes viennent de Higgsfield, tirées de son article de blog sur le lip sync. Les lignes sur l’angle de côté et les locuteurs multiples reprennent les limites du même article ; celle sur l’accent, la page voix off.
How do you fix the most common problems?
Repetitive gestures. Limited motion libraries produce the same head nod or shoulder movement every 8-10 seconds. The fix is clip length: keep individual generations under 30 seconds and cut between them.
Character drift. The same person looking different across multiple clips is a persistent identity problem, not a LipSync problem. The fix is to use a trained identity layer rather than re-uploading the same photo each time.
Quand une prise est presque bonne, changez une seule entrée et relancez. Si vous en changez plusieurs à la fois, impossible de savoir laquelle a réglé le problème.
Les vidéos parlantes dans la pub
Trois formats de pub s’appuient sur le lip sync, et chacun utilise une partie différente de Higgsfield.
Le premier : l’UGC en face caméra, un créateur qui tient votre produit et parle à son téléphone. Créez le visage une fois dans Soul, verrouillez-le avec Soul ID, puis faites-le parler dans Lipsync Studio ou Seedance. La méthode complète, prompts à l’appui : personnages UGC IA réalistes sur Higgsfield. Pour un créateur virtuel récurrent, voir le guide AI Influencer.
Le deuxième : l’explicatif produit, un présentateur qui déroule ce que fait le produit. La page talking-avatar de Higgsfield indique que Marketing Studio propose « 100+ avatars prêts à l’emploi » pour les pubs produit, ce qui évite le casting (guide Marketing Studio). Cinema Studio crée des « scènes d’avatars parlants cinématiques jusqu’à 30 secondes, avec des références image, vidéo et audio pour le visage, le produit et le style ».
Le troisième : la version traduite d’une pub qui vend déjà. Translate, dans Audio, re-double un clip en 18 langues. Sur la page de clonage de voix, l’outil de localisation de Supercomputer traduit la parole « en anglais, espagnol ou français » tout en conservant la voix du locuteur. Kling Lipsync resynchronise ensuite la bouche, au tarif le plus bas du studio.
Cinq sources publiques sur 52 attribuent à Soul ID, aux Elements et aux planches de référence le maintien d’un même personnage d’un plan à l’autre (YouTube, Reddit). Cette cohérence permet à un seul présentateur de porter toute une campagne.
Deux règles valent pour tous les formats. La première : le consentement pour tout visage ou toute voix réels. La section 5.3 des conditions de Higgsfield vous fait garantir « tous les consentements, autorisations et cessions requis par la loi applicable auprès de chaque personne dont le visage ou la voix figure ».
La seconde : l’honnêteté sur le présentateur. La section 5.2(xi) interdit de présenter « un Output comme généré par un humain alors qu’il ne l’est pas ». Les mentions des plateformes : label IA de TikTok et règles de déclaration IA de Meta.
Échanger un visage plutôt qu’une voix relève d’un autre outil : face swap et Recast sur Higgsfield. Toutes les pages Higgsfield sont réunies dans le dossier Higgsfield, et les formules et conditions dans la fiche outil Higgsfield.
Questions sur le lip sync Higgsfield
Higgsfield peut-il faire du lip sync sur ma propre vidéo ?
Oui. Les deux modèles vidéo de Lipsync Studio resynchronisent la bouche sur les images que vous envoyez. Kling Lipsync coûte environ 2 crédits pour 5 secondes en 720p ; Sync Lipsync 3 monte jusqu’à 4K. Le blog de Higgsfield demande des « images stables, avec un visage net et dégagé et une position de tête constante ».
Puis-je utiliser ma propre voix ?
Oui. Dans Audio, choisissez Create custom voice, puis enregistrez ou importez un court échantillon MP3 ou WAV. La règle de Higgsfield : « Ne clonez que votre propre voix ou une voix que vous avez le droit d’utiliser. » La page de clonage ajoute une étape de consentement avant la création du clone.
Quelle peut être la durée d’une vidéo parlante Higgsfield ?
L’article d’aide sur le lip sync ne fixe aucun maximum pour Lipsync Studio ; Infinite Talk est le modèle qu’il cite pour la vidéo parlante longue durée. Les scènes parlantes de Cinema Studio vont jusqu’à 30 secondes. Higgsfield conseille de garder chaque génération sous 30 secondes et de monter les clips bout à bout.
Faut-il choisir Lipsync Studio ou Seedance ?
Choisissez Lipsync Studio quand vous voulez maîtriser les mots exacts et la voix, comme dans une pub avec présentateur scénarisé. Choisissez Seedance quand une prise unique compte davantage : il crée voix et image ensemble. Seedance sur Higgsfield en détail : guide Seedance.
Tous les guides Higgsfield, classés par usage, sont dans le dossier Higgsfield
Sources
- Centre d’aide Higgsfield : How do I use lipsync, voiceover, and aspect ratios?, les huit modèles de Lipsync Studio selon l’entrée, les gabarits de scène, les trois modes d’Audio, le clonage de voix avec autorisation, la traduction en 18 langues, six formats d’image, Reframe ; daté du 1 août 2026. Vérifié le
- Blog Higgsfield : How to make realistic AI talking and LipSync videos in 2026, six éléments d’une vidéo parlante crédible, cinq problèmes courants et leurs solutions, un workflow en six étapes et les limites ; 7 juillet 2026. Vérifié le
- Higgsfield : AI Talking Avatar, script ou audio plus un portrait ; scènes parlantes de Cinema Studio jusqu’à 30 secondes ; doublage en 18 langues ; Reframe en 9:16, 1:1 ou 16:9 et upscale jusqu’à 4K. Vérifié le
- Higgsfield : AI Voice Over, moteurs vocaux, jusqu’à 10 000 caractères par génération et dialogue jusqu’à 10 locuteurs sur Eleven v4, Qwen Audio 3.0 TTS en 13 langues, export MP3, WAV ou OGG. Vérifié le
- Higgsfield : AI Voice Cloning, court échantillon, étape de consentement, outil de localisation de Supercomputer pour l’anglais, l’espagnol ou le français avec la voix du locuteur. Vérifié le
- Higgsfield : Higgsfield pricing, tableau comparatif lu dans un navigateur : tarifs en crédits de Lipsync Studio et ligne Higgsfield Speak par formule le 9 octobre 2026 ; prix et crédits des formules le 19 octobre 2026. Vérifié le
- Higgsfield : Higgsfield Terms of Use (26 juillet 2026), section 5.3 sur le consentement pour chaque visage et voix importés, 5.2(xi) sur les contenus présentés comme générés par un humain. Vérifié le
- VirtualSpeech : Average speaking rate and words per minute, environ 150 mots par minute pour une conversation en anglais américain, attribué au National Center for Voice and Speech ; 20 août 2026. Vérifié le
- Trustpilot, Reddit et YouTube : Avis des utilisateurs de Higgsfield, synthèse de 52 sources publiques, vérifiée le 28 septembre 2026. Vérifié le
Ce qui a changé sur cette page
- Baisse des prix chez Higgsfield : Starter passe à 15 $ par mois pour 200 crédits, en facturation mensuelle ou annuelle ; Plus à 49 $ par mois, ou 39 $ facturés à l'année, pour 1 000 crédits (contre 19 $ pour 270 crédits côté Starter, et 59 $ ou 47 $ pour 1 200 crédits côté Plus) ; Ultra reste à 129 $, ou 99 $ facturés à l'année.
- Les prix de Higgsfield ont encore monté : Starter passe à 19 $ par mois pour 270 crédits, en facturation mensuelle ou annuelle, et Plus à 59 $ par mois ou 47 $ facturés à l'année pour 1 200 crédits (contre Starter à 15 $ pour 200, Plus à 49 $ ou 39 $ pour 1 000) ; Ultra reste à 129 $, ou 99 $ facturés à l'année.
- Les prix de Higgsfield sont revenus en arrière : Starter est à 15 $ par mois pour 200 crédits, Plus à 49 $ par mois ou 39 $ facturés à l'année pour 1 000 crédits, et Ultra, à 129 $ ou 99 $ facturés à l'année, retrouve sa carte tarifaire (contre Starter à 19 $ pour 270, Plus à 59 $ ou 47 $ pour 1 200).

Alexandre S.
Alexandre S. est stratège créatif en publicité et copywriter, avec dix ans d’expérience en marketing digital sur plusieurs canaux.
Pages associées
-
 Guide Modèle de script UGC pour les pubs
Un modèle de script de publicité UGC à copier, 20 hooks par type et des exemples calibrés pour 15, 30 et 45 secondes, pour des créateurs ou des acteurs IA. Vérifié le 15 octobre 2026.
-
 Les meilleurs Voix off IA pour la pub
L’offre gratuite d’ElevenLabs exclut la publicité ; elle devient possible avec la formule Starter à 6 $. Quelle formule autorise la pub dans dix outils de voix et de vidéo, vérifié le 2 octobre 2026.
-
 Guide Seedance 2.0 sur Higgsfield
Ce que coûte Seedance 2.0 sur Higgsfield, quand il est illimité, ses limites de clip, et comment son prix se compare à Dreamina et aux autres plateformes. Vérifié le 16 octobre 2026.
-
 Guide Higgsfield Marketing Studio
Higgsfield Marketing Studio transforme un lien produit en vidéos UGC, photos produit et publicités image. Les étapes, les crédits par clip et les règles publicitaires, au 18 octobre 2026.


