Lip-Sync bei Higgsfield
Beim Lip-Sync bewegt ein Gesicht in einem Foto oder Video den Mund passend zu einem Skript. Bei Higgsfield sitzt Lipsync im Lipsync Studio, unter Video. Sie bringen ein Gesicht und einen Text mit, wählen eines von acht Modellen und erhalten einen sprechenden Clip. Die Stimme stammt aus dem Tab Audio von Higgsfield, in dem Sie auch Ihre eigene klonen können.
| Wo | Was es leistet | Sie bringen mit | Credits |
|---|---|---|---|
| Lipsync Studio, Bildmodelle | Lässt ein Gesicht auf einem Standbild sprechen | Ein Porträt und ein Skript | Etwa 12 bis 14 pro 5 s bei 720p (Infinite Talk: etwa 12 pro 2 s) |
| Lipsync Studio, Videomodelle | Synchronisiert den Mund auf vorhandenem Filmmaterial neu | Einen Clip und neues Audio | Etwa 2 pro 5 s (Kling Lipsync, 720p) |
| Videomodelle mit nativem Audio | Gesicht und Stimme in einem Durchgang | Einen Prompt und ein Startbild | Je nach Modell; Seedance 2.0 etwa 22 pro 5 s bei 720p |
| Audio | Text-zu-Sprache, Stimmwechsel, Übersetzung in 18 Sprachen | Ein Skript oder einen Clip | Wird vor der Bestätigung auf „Generate“ angezeigt |
| Stimmklonung, in Audio | Eine wiederverwendbare Kopie einer Stimme | Eine kurze MP3- oder WAV-Probe, mit Einwilligung | Wird vor der Bestätigung auf „Generate“ angezeigt |
Seitlich scrollen für alle 4 Spalten
Was ist Higgsfield Lipsync?
Higgsfield Lipsync besteht aus zwei Tools, die als Paar arbeiten. Audio erzeugt die Stimme. Lipsync Studio legt diese Stimme auf ein Gesicht. Der Hilfeartikel von Higgsfield sagt es deutlich: Ein sprechender Mund „ist Lipsync Studio, unter Video“, eine Stimme „ist Audio. Das sind getrennte Tools.“
How do I use lipsync, voiceover, and aspect ratios?
Voice generation, voice change, and translation live in Audio, while making a character talk (lip sync) lives in Lipsync Studio, which offers several models for image-to-video and video-to-video talking clips. Some video models also generate audio together with video in a single pass. Aspect ratio is set per generation inside each tool: common options are 9:16 for vertical, 16:9 for horizontal, and 1:1 for square, and not every model supports every ratio.
Ein dritter Weg kommt ohne das Paar aus. Manche Videomodelle, darunter Seedance 2.5, Seedance 2.0 und Kling 3.0, erzeugen die Sprache zusammen mit dem Bild „in einem einzigen Durchgang“. Der Hilfeartikel beschreibt den Unterschied: Lipsync Studio „fügt einem vorhandenen Bild oder Video nachträglich einen sprechenden Mund hinzu“, natives Audio dagegen liefert „perfekte physische Übereinstimmung von Anfang an“.
Für eine Anzeige können Sie im Lipsync Studio den genauen Wortlaut schreiben, die Stimme wählen und dasselbe Gesicht behalten. Ein Modell mit nativem Audio erzeugt Gesicht und Stimme zusammen in einer Aufnahme, mit weniger Kontrolle über den Vortrag.
Die Seite AI Talking Avatar ist der Eingang von Higgsfield zu denselben Tools: ein Skript oder eine Audiospur, dann „ein Porträtfoto oder ein Gesicht, das Sie bei Higgsfield erzeugt haben“, danach Vorschau und Download.
So entsteht ein Sprechvideo, Schritt für Schritt
Sieben Schritte führen von der leeren Seite zu einem Clip, den Sie in eine Anzeige schneiden können.
- Öffnen Sie den eigenen Ratgeber von Higgsfield, How do I use lipsync, voiceover, and aspect ratios?, und lassen Sie ihn daneben offen. Öffnen Sie dann Lipsync Studio im Menü Video; das Hilfecenter nennt das Tool „Create Talking Clips“.
How do I create a lip-synced (talking) video?
Lip sync lives in Lipsync Studio (higgsfield.ai → Video → Lipsync Studio, “Create Talking Clips”). Upload a character image or video, type what the character should say in Audio text (or generate the audio), pick a model, and generate. Each model offers scene templates (General, Selfie, Podcast, Car Talking, and more) to set the look of the clip.
- Schreiben Sie zuerst das Skript, mit etwa zweieinhalb Wörtern pro Sekunde (die Zahlen stehen im nächsten Abschnitt). Schreiben Sie es so, wie ein Mensch spricht, und setzen Sie dort, wo der Ton wechselt, einen Hinweis in Klammern wie [warm] oder [direct].
- Wählen Sie das Gesicht. Für ein Standbild laden Sie ein scharfes, gleichmäßig ausgeleuchtetes Porträt von vorn mit „leichtem, natürlichem Ausdruck“ hoch; laut Higgsfield-Blog gibt ein „neutrales Passfoto-Gesicht“ dem Modell „nichts, woraus es etwas animieren kann“. Für einen Clip, den Sie neu vertonen wollen, nehmen Sie ruhiges Material mit stabilem Kopf. Ein Gesicht, das Sie in Soul erfunden haben, funktioniert; das Gesicht einer realen Person erfordert deren Einwilligung.
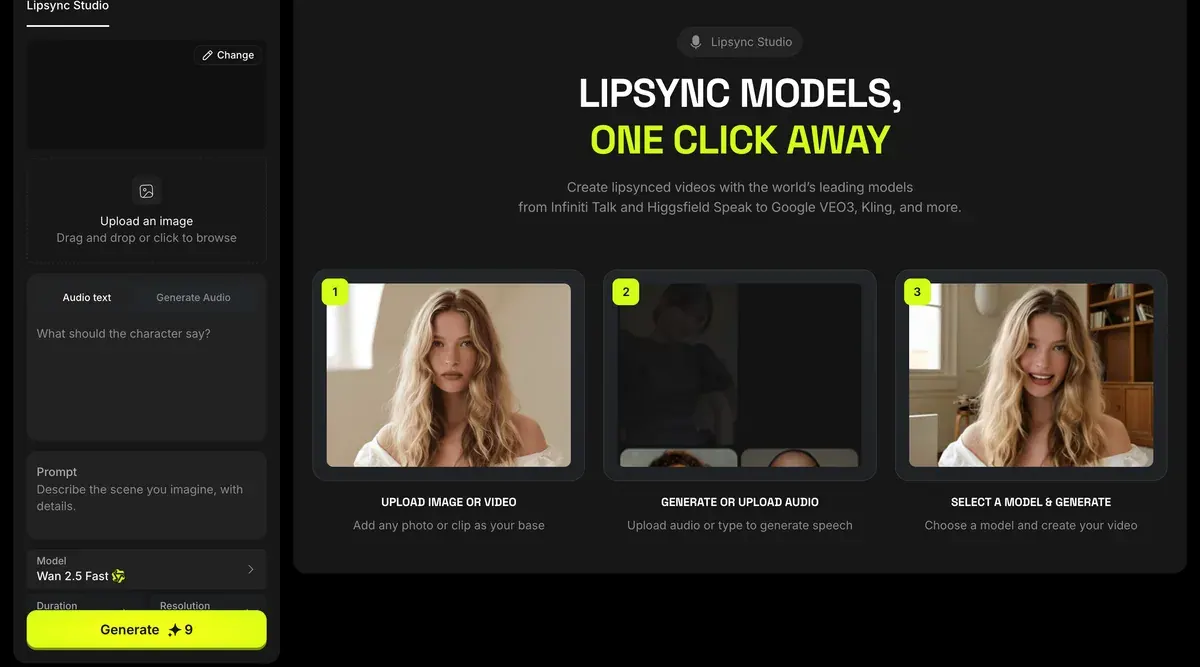
- Erzeugen Sie die Stimme. Tippen Sie den Text in das Audiofeld von Lipsync Studio oder bauen Sie die Spur zuerst in Audio. Audio bietet eine Preset-Stimme oder einen Klon Ihrer eigenen, einstellbar mit Emotionsreglern. Der Blog von Higgsfield stellt das Audio nicht ohne Grund an den Anfang: „Eine flache Audiospur ergibt ein flaches Gesicht, egal welches Modell Sie verwenden.“
- Wählen Sie Modell und Szenenvorlage. Zur Auswahl stehen unter anderem General, Selfie, Podcast und Car Talking. Stellen Sie das Format vor der Bestätigung ein: 9:16 für TikTok, Reels und Shorts. Die Formate unterscheiden sich je nach Modell, manche lesen das Format aus Ihrem Bild.
- Generieren Sie und sehen Sie sich das ganze Gesicht an. Prüfen Sie Augen, Kopf und ob der Ausdruck zur Stimme passt; der Mund ist meist der Teil, der funktioniert. Ändern Sie pro Wiederholung nur eine Sache, in der Reihenfolge von Higgsfield: Skript, dann Bild, dann Modell.
- Exportieren Sie. Um das Format eines fertigen Clips zu ändern, nutzen Sie Edit und dann Reframe. Für eine Version in einer anderen Sprache schicken Sie den Clip durch Translate in Audio.
What voice and audio tools are available?
Three modes. Text to Speech generates a voice track from text; Voice Change replaces the existing voice in a clip with a different one; Translate translates and re-voices your content in another language (18 languages).
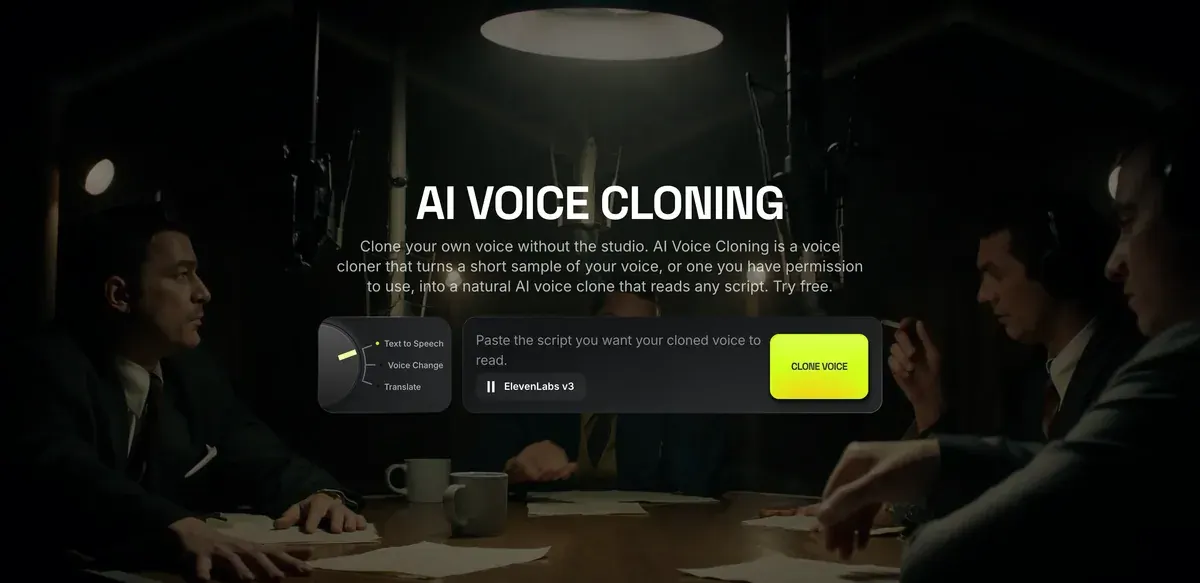
Your own voice. Create custom voice → Add Voice lets you record a sample or upload one (MP3 or WAV), then clones it into a reusable voice you can select for any generation. Only clone a voice that is your own or one you have the person’s permission to use.
Einen Überblick über alle Tabs von Higgsfield gibt So nutzen Sie Higgsfield.
Welche Modelle Lipsync können und was sie kosten
Das Lipsync Studio bietet sechs Bildmodelle und zwei Videomodelle. Higgsfield Speak 2.0, die hauseigene Engine, gibt es nur in Plus und Ultra.
| Modell | Eingabe | Was Higgsfield dazu sagt | Credits |
|---|---|---|---|
| Higgsfield Speak 2.0 | Bild | Geschwindigkeit der Prioritätswarteschlange | Etwa 14 pro 5 s bei 720p |
| Wan 2.5 Speak | Bild | 480p bis 1080p, mit Audio | Etwa 12 pro 5 s bei 720p |
| Infinite Talk | Bild | Lange Sprechvideos | Etwa 12 pro 2 s bei 720p |
| Kling 2.6 Lipsync | Bild | Bis zu 1080p, mit Audio | Unter diesem Namen nicht aufgeführt; die Zeile Kling Speak der Tabelle nennt etwa 2 pro 2 s |
| Kling Avatars 2.0 | Bild | Sprechende Avatare, längere Clips | Unter diesem Namen nicht aufgeführt |
| Google Veo 3.1 | Bild | Filmreife Sprechvideos | Für Lipsync Studio nicht aufgeführt |
| Kling Lipsync | Video | Lip-Sync auf vorhandenem Filmmaterial | Etwa 2 pro 5 s bei 720p |
| Sync Lipsync 3 | Video | Präzises Lip-Sync, bis zu 4K | Etwa 18 pro 2 s bei 4K |
Seitlich scrollen für alle 4 Spalten
Modellnamen und Hinweise stammen aus dem Hilfeartikel zu Lipsync; die Credits aus der Vergleichstabelle der Preisseite, gelesen am 9. Oktober 2026.
Lipsync Studio models
Image to video. Google Veo 3.1 (cinematic talking video); Kling 2.6 Lipsync (up to 1080p, with audio); Wan 2.5 Speak (480p to 1080p, with audio); Kling Avatars 2.0 (talking avatars, longer clips); Higgsfield Speak 2.0 (priority-queue speed); Infinite Talk (long-form talking video).
Video to video. Kling Lipsync (lip sync on existing footage); Sync Lipsync 3 (precise lip sync, up to 4K).
Drei Rechenbeispiele zu diesen Preisen:
- Ein Präsentator-Clip von 15 Sekunden mit Speak 2.0 bei 720p: drei Blöcke zu je 5 Sekunden für etwa 14, also etwa 42 Credits.
- Eine bereits laufende Anzeige von 30 Sekunden neu vertonen, mit Kling Lipsync: sechs Blöcke zu etwa 2, also etwa 12 Credits. So lässt sich ein neuer Hook am günstigsten an erprobtem Material testen.
- Dieselben 15 Sekunden mit Sync Lipsync 3 bei 4K: etwa 18 Credits alle 2 Sekunden, also etwa 135 Credits.
Plus, der günstigste Tarif mit Speak, kostet 59 $ pro Monat für 1.200 Credits pro Monat. Bei etwa 42 Credits pro Clip reicht das für etwa 28 Präsentator-Clips mit Speak 2.0, wenn die Credits sonst nirgends verbraucht werden.
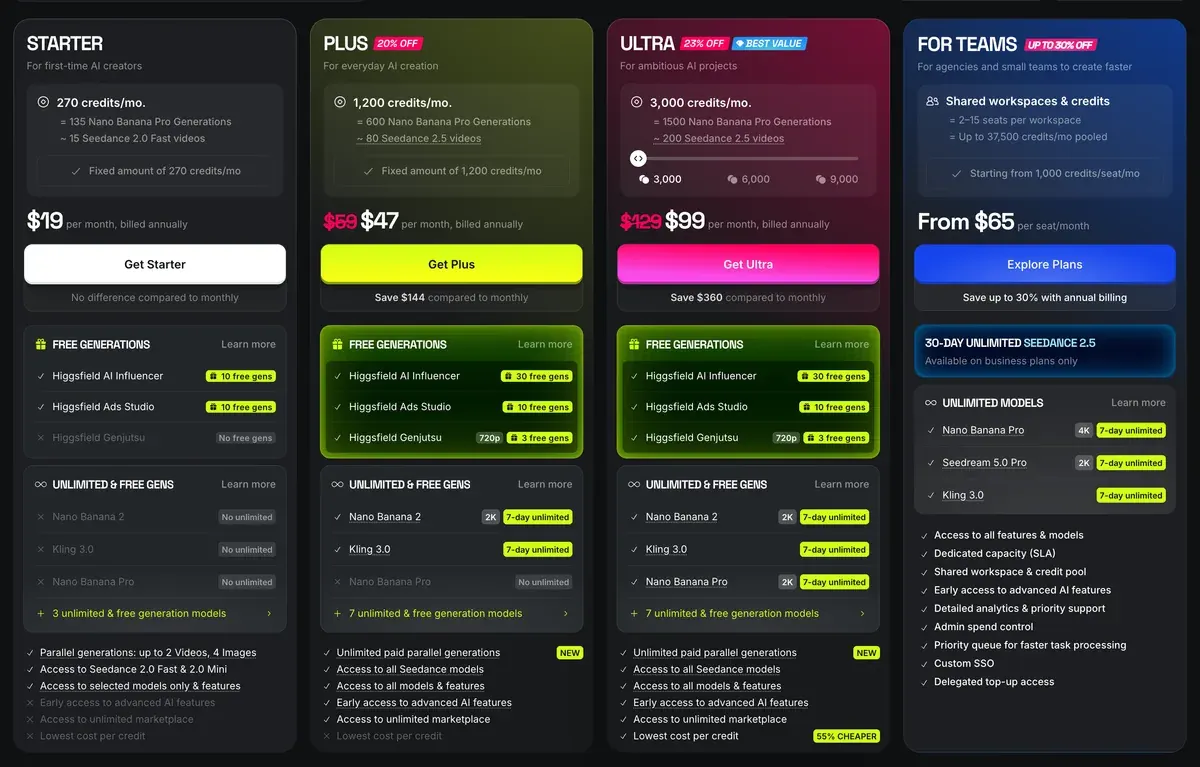
Zwei Punkte aus Nutzerberichten schlagen sich in der Rechnung nieder. Acht von 52 öffentlichen Quellen berichten, Generierungen liefen langsam oder schlügen fehl und kosteten trotzdem Credits (Reddit, YouTube). Sechs sagen, Credits verfielen am Ende jedes Abrechnungszeitraums (Trustpilot, YouTube). Alle Tarife mit ihren Credits: Higgsfield-Preise.
Ein Skript schreiben, das gut lippensynchron läuft
Ein Lip-Sync-Skript wird fürs Ohr geschrieben, seine Länge bemisst sich also in Sekunden. Gesprochenes amerikanisches Englisch liegt bei etwa 150 Wörtern pro Minute, eine Zahl, die VirtualSpeech dem National Center for Voice and Speech zuschreibt. Das sind zweieinhalb Wörter pro Sekunde.
| Cliplänge | Wörter (max.) | Passt für |
|---|---|---|
| 5 s | 12 | Eine Hook-Zeile |
| 8 s | 20 | Ein Hook und ein Grund |
| 15 s | 37 | Hook, Produkt, Call to Action |
| 30 s | 75 | Eine komplette Kurzanzeige, am besten aus zwei Clips geschnitten |
Seitlich scrollen für alle 3 Spalten
Bleiben Sie ein paar Wörter unter dem Budget. Pausen und Hinweise in Klammern brauchen ebenfalls Zeit, und in gehetzten Zeilen verrutschen die Münder.
Fünf Regeln machen bei Higgsfield den Unterschied:
- Eine Idee pro Zeile. Jeder Satz bekommt seinen eigenen Atemzug, sodass sich das Gesicht dazwischen zurücksetzt.
- Schreiben Sie, wie Sie sprechen. Der Blog von Higgsfield stellt „Wir freuen uns, unser neuestes Produkt-Update anzukündigen“ gegen „Heute möchte ich Ihnen etwas zeigen, woran wir schon eine Weile arbeiten.“
- Markieren Sie den Ton in Klammern, wo er wechselt: [warm], [calm], [direct]. Higgsfield zufolge „nutzen performancebasierte Modelle diese, um Parameter der Gesichtsanimation zu variieren“.
- Schreiben Sie Zahlen so aus, wie man sie spricht („zwanzig Prozent“), und Markennamen so, wie sie klingen. Bei Symbolen muss die Stimme raten.
- Bleiben Sie bei einem Sprecher. Higgsfield führt überlappende Dialoge unter den Grenzen auf; machen Sie aus jedem Sprecher einen eigenen Clip.
Step-by-step: how to improve AI lipsync quality
Write for spoken delivery, not for reading. Formal writing produces robotic delivery. Conversational language produces more natural facial animation because the model has more expressive cues to work from. Add emotion cues in brackets where the tone should shift: [excited], [calm], [direct].
Generate expressive audio first. Voice is the input that drives facial animation. Monotone delivery reduces the range of facial motion the model generates. A flat audio track produces a flat face regardless of which model you use.
Ein Präsentator-Skript von 15 Sekunden mit 28 gesprochenen Wörtern, für ein Handy, das auf einem Badezimmerregal lehnt:
[warm] Morning routine, one step.
[direct] Two drops of this serum, pat it in, done.
[light] No layering three bottles.
[calm] It's in the link below, if your shelf is full too.
Der Präsentator zeigt das Produkt und liest die Aussage der Marke vor. Er sagt nie, er nutze es seit Monaten: Bei einem KI-Gesicht ist das ein gefälschter Erfahrungsbericht (KI-UGC und Recht). Mehr Skriptformen nach Anzeigenformat: UGC-Skriptvorlage.
Wenn der Mund abweicht: häufige Lösungen
Der Blog von Higgsfield nennt die Genauigkeit der Lippensynchronisation „weitgehend ein gelöstes Problem in 2026“. Auffällig ist für Zuschauer alles außer dem Mund: ein erstarrtes Gesicht, starrende Augen, ein Nicken in Endlosschleife, ein Gesicht, das von Clip zu Clip wechselt.
How to make an AI Talking Video Feel Real?
A believable LipSync video coordinates six elements simultaneously: lip movement aligned to speech phonemes; facial expressions that shift with emotional content; eye movement; subtle head motion that follows speech rhythm; gestures that match meaning; voice delivery with pacing, pauses, and tonal variation.
Frozen facial expressions. The cause is usually a source image with a neutral, flat expression. Use an image where the subject has a light, natural expression, not a passport-photo neutral face. Adding emotion cues to the script also helps: words like [excited], [thoughtful], or [warm] in brackets give performance-based models a signal to animate from.
| Was Sie sehen | Warum | Lösung |
|---|---|---|
| Nur der Mund bewegt sich | Ein flaches, neutrales Ausgangsfoto | Ein Porträt mit leichtem Ausdruck; Hinweise in Klammern |
| Aufgeregte Stimme, leeres Gesicht | Stimme und Gesicht in getrennten Durchgängen erzeugt | Die Energie der Stimme an das Gesicht angleichen oder ein Modell mit nativem Audio nehmen |
| Starrer Blick, gleichmäßiges Blinzeln | Wenig Augenbewegung im Modell | Clips unter 20 Sekunden |
| Dasselbe Nicken alle 8 bis 10 s | Kleine Bewegungsbibliothek bei einem langen Clip | Clips unter 30 Sekunden, zusammengeschnitten |
| In jedem Clip ein neues Gesicht | Keine Identitätssperre | Einmal eine Soul ID trainieren und wiederverwenden |
| Lippen daneben bei gedrehtem Kopf | Seitlicher Winkel oder verdecktes Gesicht | Frontales Ausgangsmaterial, keine Brille, keine Haare vor dem Mund |
| Falscher Akzent | Standardstimme für das Skript | Eine Stimme in der Zielsprache wählen; Qwen Audio 3.0 TTS versteht Dialektangaben in einfachen Worten |
| Zwei Personen sprechen durcheinander | Überlappende Dialoge | Ein Sprecher pro Clip, im Schnitt zusammengefügt |
Seitlich scrollen für alle 3 Spalten
Die Lösungen in den ersten fünf Zeilen stammen von Higgsfield selbst, aus dem Blogbeitrag zu Lipsync. Die Zeilen zu seitlichem Winkel und mehreren Sprechern stammen aus den Grenzen desselben Beitrags, die Zeile zum Akzent von der Voice-over-Seite.
How do you fix the most common problems?
Repetitive gestures. Limited motion libraries produce the same head nod or shoulder movement every 8-10 seconds. The fix is clip length: keep individual generations under 30 seconds and cut between them.
Character drift. The same person looking different across multiple clips is a persistent identity problem, not a LipSync problem. The fix is to use a trained identity layer rather than re-uploading the same photo each time.
Ist eine Aufnahme fast gelungen, ändern Sie eine Eingabe und starten sie neu. Wer mehrere Eingaben gleichzeitig ändert, weiß nicht, was geholfen hat.
Sprechvideos in Anzeigen
Drei Anzeigenformate setzen auf Lip-Sync, und jedes nutzt einen anderen Teil von Higgsfield.
Das erste ist Talking-Head-UGC: ein Creator hält Ihr Produkt und spricht in sein Handy. Besetzen Sie das Gesicht einmal in Soul, sichern Sie es mit Soul ID und lassen Sie es dann im Lipsync Studio oder mit Seedance sprechen. Die ganze Methode samt Prompts: realistische KI-UGC-Charaktere bei Higgsfield. Für einen wiederkehrenden virtuellen Creator hilft der Ratgeber zu KI-Influencern.
Das zweite ist der Produkterklärer: ein Präsentator, der durchgeht, was das Produkt kann. Laut der Talking-Avatar-Seite von Higgsfield bringt Marketing Studio „100+ fertige Avatare“ für Produktanzeigen mit, was das Casting spart (Ratgeber zu Marketing Studio). Cinema Studio erzeugt „filmreife Szenen mit sprechenden Avataren von bis zu 30 Sekunden, mit Bild-, Video- und Audioreferenzen für Gesicht, Produkt und Stil“.
Das dritte ist die übersetzte Fassung einer Anzeige, die sich schon verkauft. Translate in Audio vertont einen Clip in 18 Sprachen neu. Auf der Seite zur Stimmklonung übersetzt das Lokalisierungs-Tool in Supercomputer Sprache „ins Englische, Spanische oder Französische“ und behält die Stimme des Sprechers bei. Kling Lipsync synchronisiert dann den Mund neu, zum niedrigsten Preis im Studio.
Fünf von 52 öffentlichen Quellen führen es auf Soul ID, Elements und Referenzbögen zurück, dass eine Figur über mehrere Einstellungen gleich bleibt (YouTube, Reddit). Dank dieser Konsistenz kann ein einziger Präsentator eine ganze Kampagne tragen.
Zwei Regeln gelten für jedes Format. Die erste ist die Einwilligung für jedes echte Gesicht und jede echte Stimme. Nach Abschnitt 5.3 der Nutzungsbedingungen von Higgsfield sichern Sie zu, dass „alle nach geltendem Recht erforderlichen Einwilligungen, Freigaben und Genehmigungen jeder Person vorliegen, deren Gesicht oder Stimme enthalten ist“.
Die zweite ist Ehrlichkeit über den Präsentator. Abschnitt 5.2(xi) verbietet es, darzustellen, „dass ein Ergebnis von Menschen erstellt wurde, wenn es das nicht ist“. Kennzeichnungen der Plattformen: TikTok-KI-Label und Meta-KI-Kennzeichnung.
Wer ein Gesicht statt einer Stimme tauschen will, braucht ein anderes Tool: Higgsfield Face Swap und Recast. Alle Higgsfield-Seiten sind auf der Themenseite zu Higgsfield gebündelt, Tarife und Bedingungen im Higgsfield-Tool-Profil.
Häufige Fragen zu Lip-Sync bei Higgsfield
Kann Higgsfield mein eigenes Video lippensynchronisieren?
Ja. Die beiden Videomodelle im Lipsync Studio synchronisieren den Mund auf hochgeladenem Material neu. Kling Lipsync kostet etwa 2 Credits pro 5 Sekunden bei 720p; Sync Lipsync 3 geht bis 4K. Der Blog von Higgsfield verlangt „stabiles Material mit klar sichtbarem, unverdecktem Gesicht und gleichbleibender Kopfhaltung“.
Kann ich meine eigene Stimme verwenden?
Ja. Wählen Sie in Audio „Create custom voice“ und nehmen Sie eine kurze MP3- oder WAV-Probe auf oder laden Sie sie hoch. Higgsfields Regel: „Klonen Sie nur Ihre eigene Stimme oder eine, für die Sie die Erlaubnis haben.“ Die Seite zur Stimmklonung schaltet vor dem Klonen einen Schritt zur Einwilligung vor.
Wie lang kann ein Sprechvideo bei Higgsfield sein?
Der Hilfeartikel zu Lipsync nennt für Lipsync Studio keine Höchstdauer; für lange Sprechvideos führt er Infinite Talk auf. Sprechszenen in Cinema Studio dauern bis zu 30 Sekunden. Higgsfield selbst rät, jede Generierung unter 30 Sekunden zu halten und zwischen Clips zu schneiden.
Lipsync Studio oder Seedance?
Lipsync Studio passt, wenn Sie den genauen Wortlaut und die Stimme steuern müssen, etwa bei einer Präsentator-Anzeige nach Skript. Seedance passt, wenn es mehr auf eine einzige Aufnahme ankommt: Das Modell erzeugt Stimme und Bild zusammen. Seedance bei Higgsfield im Detail: Ratgeber zu Seedance.
Alle Higgsfield-Ratgeber finden Sie, nach Aufgabe sortiert, auf der Higgsfield-Themenseite
Quellen
- Higgsfield-Hilfecenter: How do I use lipsync, voiceover, and aspect ratios?, die acht Modelle des Lipsync Studio nach Eingabe, Szenenvorlagen, die drei Modi von Audio, Stimmklonung mit Erlaubnis, Übersetzung in 18 Sprachen, sechs Seitenverhältnisse, Reframe; datiert 1. August 2026. Geprüft
- Higgsfield-Blog: How to make realistic AI talking and LipSync videos in 2026, sechs Elemente eines glaubwürdigen Sprechvideos, fünf häufige Probleme samt Lösungen, ein Ablauf in sechs Schritten und die Grenzen; 7. Juli 2026. Geprüft
- Higgsfield: AI Talking Avatar, Skript oder Audio plus Porträt; Sprechszenen in Cinema Studio bis zu 30 Sekunden; Dubbing in 18 Sprachen; Reframe auf 9:16, 1:1 oder 16:9 und Hochskalieren auf 4K. Geprüft
- Higgsfield: AI Voice Over, Stimm-Engines, bis zu 10.000 Zeichen pro Durchlauf und Dialog mit bis zu 10 Sprechern bei Eleven v4, Qwen Audio 3.0 TTS in 13 Sprachen, Export als MP3, WAV oder OGG. Geprüft
- Higgsfield: AI Voice Cloning, kurze Probe, ein Schritt zur Einwilligung, das Lokalisierungs-Tool in Supercomputer für Englisch, Spanisch oder Französisch in der eigenen Stimme des Sprechers. Geprüft
- Higgsfield: Higgsfield-Preise, Vergleichstabelle im Browser gelesen: Credit-Preise für Lipsync Studio und die Zeile Higgsfield Speak nach Tarif am 9. Oktober 2026; Tarifpreise und Credits am 19. Oktober 2026. Geprüft
- Higgsfield: Higgsfield-Nutzungsbedingungen (26. Juli 2026), 5.3 zur Einwilligung für jedes hochgeladene Gesicht und jede Stimme, 5.2(xi) zu Ergebnissen, die als von Menschen erstellt dargestellt werden. Geprüft
- VirtualSpeech: Average speaking rate and words per minute, etwa 150 Wörter pro Minute bei Gesprächen in amerikanischem Englisch, dem National Center for Voice and Speech zugeschrieben; 20. August 2026. Geprüft
- Trustpilot, Reddit und YouTube: Higgsfield user reports, 52 öffentliche Quellen ausgewertet, geprüft am 28. September 2026. Geprüft
Was sich auf dieser Seite geändert hat
- Die Preise von Higgsfield sind wieder gestiegen: Starter kostet 19 Dollar pro Monat für 270 Credits, bei monatlicher wie jährlicher Zahlung, Plus 59 pro Monat oder 47 bei jährlicher Zahlung für 1.200 Credits (vorher Starter 15 für 200, Plus 49 oder 39 für 1.000); Ultra bleibt bei 129 oder 99 bei jährlicher Zahlung.
- Die Preise von Higgsfield sind wieder gesunken: Starter kostet 15 $ pro Monat für 200 Credits, bei monatlicher wie jährlicher Zahlung, Plus 49 $ pro Monat oder 39 $ bei jährlicher Zahlung für 1.000 Credits (vorher Starter 19 $ für 270, Plus 59 $ oder 47 $ für 1.200); Ultra bleibt bei 129 $, bei jährlicher Zahlung 99 $.
- Die Preise von Higgsfield sind wieder gestiegen: Starter kostet 19 $ pro Monat für 270 Credits, bei monatlicher wie jährlicher Zahlung, Plus 59 $ pro Monat oder 47 $ bei jährlicher Zahlung für 1.200 Credits (vorher Starter 15 $ für 200, Plus 49 $ oder 39 $ für 1.000); Ultra bleibt bei 129 $, bei jährlicher Zahlung 99 $.
- Higgsfield hat die Preise zurückgesetzt: Starter kostet 15 $ pro Monat für 200 Credits, Plus 49 $ pro Monat oder 39 $ bei jährlicher Zahlung für 1.000 Credits, und für Ultra gibt es mit 129 $ beziehungsweise 99 $ bei jährlicher Zahlung wieder eine Tarifkarte (vorher Starter 19 $ für 270, Plus 59 $ oder 47 $ für 1.200).

Alexandre S.
Alexandre S. ist Creative Ad Strategist und Copywriter mit zehn Jahren Erfahrung im digitalen Marketing über mehrere Kanäle hinweg.
Ähnliche Seiten
-
 Ratgeber UGC-Skriptvorlage für Anzeigen
Eine UGC-Skriptvorlage zum Kopieren, 20 Hooks nach Typ und Beispiele mit Timing für 15, 30 und 45 Sekunden, für Creator oder KI-Darsteller. Geprüft am 15. Oktober 2026.
-
 Bestenliste KI-Voice-over für Anzeigen
Der Gratis-Tarif von ElevenLabs schließt Anzeigen aus; bezahlte Anzeigen beginnen mit dem Starter-Tarif für 6 $. In welchem Tarif zehn Voice- und Video-Tools Anzeigen erlauben, geprüft am 2. Oktober 2026.
-
 Ratgeber Seedance 2.0 auf Higgsfield
Was Seedance 2.0 auf Higgsfield kostet, wann es unbegrenzt ist, die Clip-Limits und wie sich der Preis zu Dreamina und anderen Anbietern verhält. Geprüft am 16. Oktober 2026.
-
 Ratgeber Higgsfield Marketing Studio
Higgsfield Marketing Studio macht aus einem Produktlink UGC-Videos, Produktaufnahmen und Bildanzeigen. Die Schritte, Credits pro Clip und Anzeigenregeln, 18. Oktober 2026.


