Higgsfield 립싱크
립싱크는 사진이나 영상 속 얼굴의 입이 대본에 맞춰 움직이게 하는 기능입니다. Higgsfield에서는 Video 메뉴의 Lipsync Studio에서 합니다. 얼굴과 대사를 준비해 8개 모델 중 하나를 고르면 말하는 클립이 나옵니다. 음성은 Higgsfield의 Audio 탭에서 가져오며, 내 목소리를 복제할 수도 있습니다.
| 위치 | 주요 기능 | 준비물 | 크레딧 |
|---|---|---|---|
| Lipsync Studio(이미지 모델) | 정지된 얼굴이 말하게 함 | 인물 사진과 대본 | 720p 기준 5초당 약 12~14 (Infinite Talk: 2초당 약 12) |
| Lipsync Studio(비디오 모델) | 기존 영상의 입 모양을 다시 맞춤 | 영상 클립과 새 오디오 | 5초당 약 2 (Kling Lipsync, 720p) |
| 네이티브 오디오 지원 영상 모델 | 얼굴과 음성을 한 번에 생성 | 프롬프트와 시작 프레임 | 모델별로 다름. Seedance 2.0은 720p 기준 5초당 약 22 |
| 오디오 | 텍스트 음성 변환, 음성 변경, 18개 언어 번역 | 스크립트 또는 클립 | 확인 전 생성 버튼에 표시 |
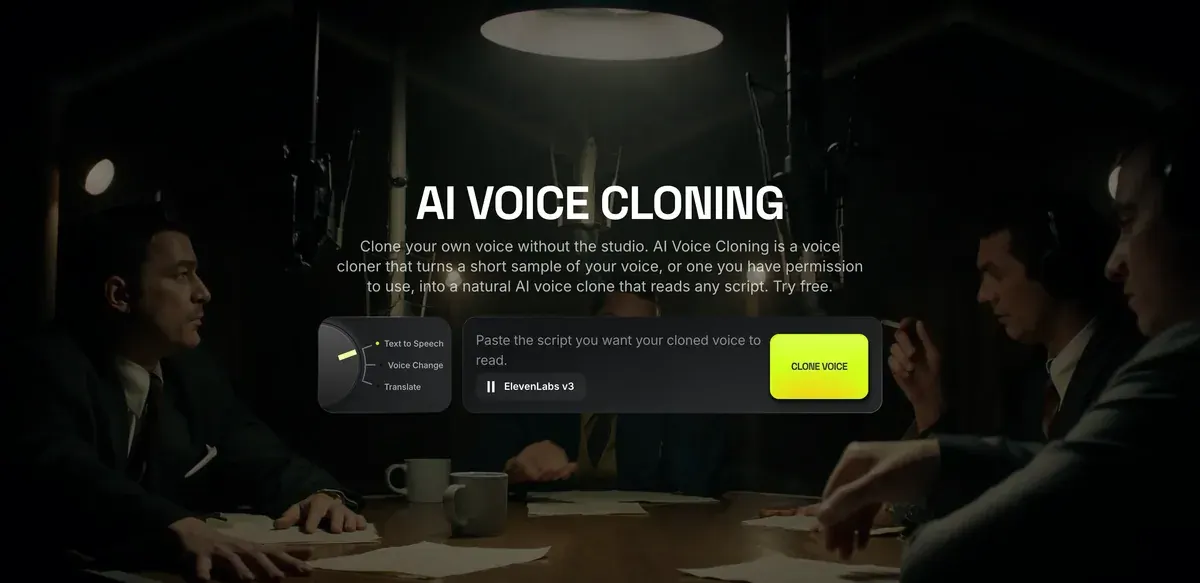
| 오디오의 음성 클로닝 | 재사용할 수 있는 음성 복제본 | 짧은 MP3 또는 WAV 샘플(동의 필요) | 확인 전 생성 버튼에 표시 |
옆으로 스크롤하면 4개 열을 모두 볼 수 있습니다.
Higgsfield 립싱크란?
Higgsfield 립싱크는 두 가지 툴을 짝지어 쓰는 방식입니다. Audio가 목소리를 만들고, Lipsync Studio가 그 목소리를 얼굴에 입힙니다. Higgsfield 도움말도 이 점을 분명히 합니다. 말하는 입은 “Video 메뉴의 Lipsync Studio”, 목소리는 “Audio”이고 “두 툴은 별개”라고 설명합니다.
How do I use lipsync, voiceover, and aspect ratios?
Voice generation, voice change, and translation live in Audio, while making a character talk (lip sync) lives in Lipsync Studio, which offers several models for image-to-video and video-to-video talking clips. Some video models also generate audio together with video in a single pass. Aspect ratio is set per generation inside each tool: common options are 9:16 for vertical, 16:9 for horizontal, and 1:1 for square, and not every model supports every ratio.
둘을 짝짓지 않는 세 번째 방법도 있습니다. Seedance 2.5, Seedance 2.0, Kling 3.0 등 일부 영상 모델은 화면과 음성을 “한 번에” 생성합니다. 도움말은 차이를 이렇게 설명합니다. Lipsync Studio는 “이미 있는 이미지나 영상에 나중에 말하는 입을 더하는” 방식이고, 네이티브 오디오는 “처음부터 완벽한 물리적 싱크”를 제공합니다.
광고라면 Lipsync Studio에서 대사를 정확히 쓰고, 목소리를 고르고, 같은 얼굴을 유지할 수 있습니다. 네이티브 오디오 모델은 얼굴과 목소리를 한 번에 만들지만 전달 방식은 통제하기 어렵습니다.
AI Talking Avatar 페이지는 같은 툴로 들어가는 Higgsfield의 입구입니다. 스크립트나 오디오 트랙을 넣고, “인물 사진 또는 Higgsfield에서 만든 얼굴”을 고른 뒤 미리보기와 다운로드로 이어집니다.
말하는 영상 만드는 법: 단계별 가이드
일곱 단계를 거치면 빈 화면에서 광고에 쓸 수 있는 클립이 완성됩니다.
- Higgsfield 공식 가이드 How do I use lipsync, voiceover, and aspect ratios?를 옆에 열어 둡니다. 그다음 Video 메뉴에서 Lipsync Studio를 엽니다. 도움말에서는 이 툴을 “Create Talking Clips”라고 부릅니다.
How do I create a lip-synced (talking) video?
Lip sync lives in Lipsync Studio (higgsfield.ai → Video → Lipsync Studio, “Create Talking Clips”). Upload a character image or video, type what the character should say in Audio text (or generate the audio), pick a model, and generate. Each model offers scene templates (General, Selfie, Podcast, Car Talking, and more) to set the look of the clip.
- 무엇보다 먼저 스크립트를 씁니다. 분량은 초당 두 단어 반 기준입니다(단어 수는 다음 섹션에 있습니다). 사람이 말하듯 쓰고, 톤이 바뀌는 곳에는 [warm], [direct] 같은 대괄호 큐를 넣습니다.
- 얼굴을 고릅니다. 정지 이미지는 선명하고 조명이 고르며 정면을 향한 인물 사진에 “가볍고 자연스러운 표정”이 담긴 것을 올립니다. Higgsfield 블로그에 따르면 “여권 사진처럼 무표정한 얼굴”에서는 모델이 “움직일 단서”를 얻지 못합니다. 목소리를 바꿀 클립이라면 머리가 흔들리지 않는 안정적인 영상을 씁니다. Soul로 만든 가상의 얼굴은 사용할 수 있지만, 실존 인물의 얼굴은 본인 동의가 필요합니다.
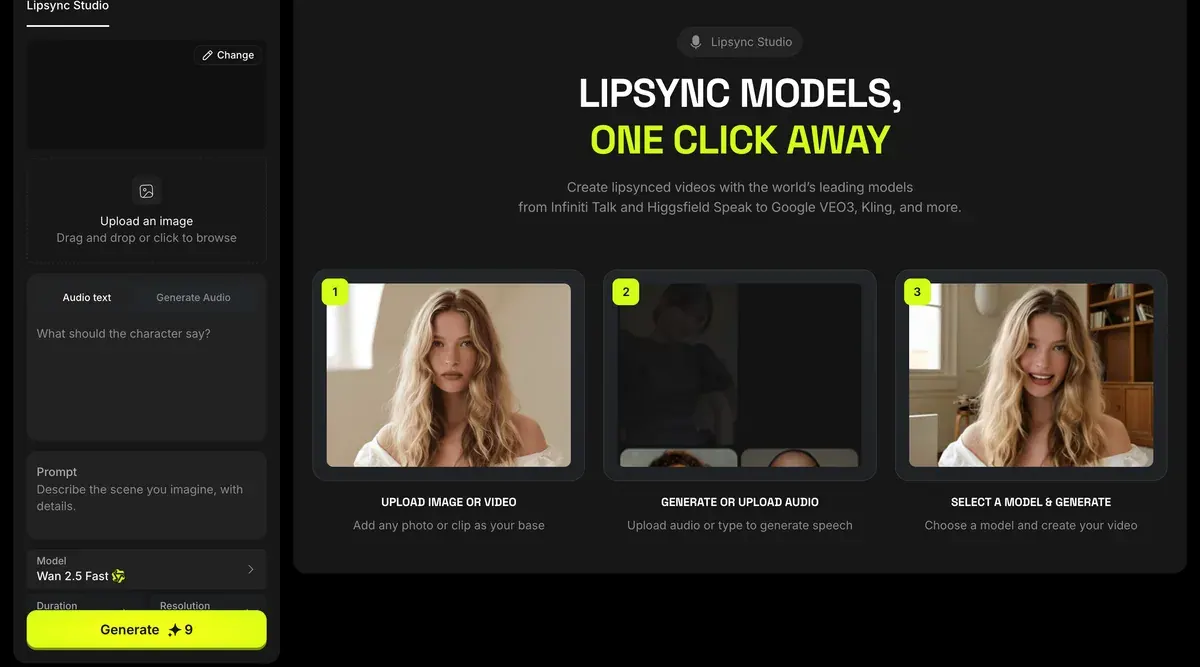
- 목소리를 만듭니다. Lipsync Studio의 오디오 입력창에 대사를 입력하거나, 먼저 Audio에서 트랙을 만듭니다. Audio에서는 프리셋 음성이나 내 목소리 복제본을 고르고 감정 슬라이더로 조정합니다. Higgsfield 블로그가 오디오를 먼저 꼽는 데는 이유가 있습니다. “밋밋한 오디오 트랙은 어떤 모델을 쓰든 밋밋한 얼굴을 만듭니다.”
- 모델과 장면 템플릿을 고릅니다. 템플릿에는 General, Selfie, Podcast, Car Talking이 있습니다. 확인 전에 화면 비율을 설정합니다. TikTok, 릴스, 쇼츠에는 9:16입니다. 비율은 모델마다 다르고, 일부는 이미지에서 비율을 읽어 옵니다.
- 생성한 뒤 얼굴 전체를 살핍니다. 눈, 머리 움직임, 표정이 목소리와 맞는지 확인합니다. 입 모양은 대체로 잘 맞는 부분입니다. 재시도할 때는 Higgsfield가 권하는 순서대로 스크립트, 이미지, 모델 순으로 한 번에 하나씩만 바꿉니다.
- 내보냅니다. 완성된 클립의 비율을 바꾸려면 Edit에서 Reframe을 씁니다. 다른 언어 버전은 Audio의 Translate에 클립을 넣어 만듭니다.
What voice and audio tools are available?
Three modes. Text to Speech generates a voice track from text; Voice Change replaces the existing voice in a clip with a different one; Translate translates and re-voices your content in another language (18 languages).
Your own voice. Create custom voice → Add Voice lets you record a sample or upload one (MP3 or WAV), then clones it into a reusable voice you can select for any generation. Only clone a voice that is your own or one you have the person’s permission to use.
Higgsfield의 모든 탭을 둘러보려면 Higgsfield 사용법을 확인하면 됩니다.
립싱크 지원 모델과 비용
Lipsync Studio에는 이미지 모델 여섯 개와 영상 모델 두 개가 있습니다. Higgsfield 자체 엔진인 Higgsfield Speak 2.0은 Plus와 Ultra 플랜에서만 쓸 수 있습니다.
| 모델 | 입력 | Higgsfield 설명 | 크레딧 |
|---|---|---|---|
| Higgsfield Speak 2.0 | 이미지 | 우선 대기열 속도 | 720p 기준 5초당 약 14 |
| Wan 2.5 Speak | 이미지 | 480p~1080p, 오디오 포함 | 720p 기준 5초당 약 12 |
| Infinite Talk | 이미지 | 긴 분량의 말하는 영상 | 720p 기준 2초당 약 12 |
| Kling 2.6 Lipsync | 이미지 | 최대 1080p, 오디오 포함 | 해당 이름으로는 표기되지 않음. 표의 Kling Speak 행은 2초당 약 2 |
| Kling Avatars 2.0 | 이미지 | 말하는 아바타, 긴 클립 | 해당 이름으로는 표기되지 않음 |
| Google Veo 3.1 | 이미지 | 시네마틱 말하는 영상 | Lipsync Studio에는 없음 |
| Kling Lipsync | 영상 | 기존 영상의 립싱크 | 720p 기준 5초당 약 2 |
| Sync Lipsync 3 | 영상 | 정밀 립싱크, 최대 4K | 4K 기준 2초당 약 18 |
옆으로 스크롤하면 4개 열을 모두 볼 수 있습니다.
모델 이름과 설명은 립싱크 도움말에서, 크레딧은 가격 페이지 비교표에서 가져왔으며 2026년 10월 9일에 확인했습니다.
Lipsync Studio models
Image to video. Google Veo 3.1 (cinematic talking video); Kling 2.6 Lipsync (up to 1080p, with audio); Wan 2.5 Speak (480p to 1080p, with audio); Kling Avatars 2.0 (talking avatars, longer clips); Higgsfield Speak 2.0 (priority-queue speed); Infinite Talk (long-form talking video).
Video to video. Kling Lipsync (lip sync on existing footage); Sync Lipsync 3 (precise lip sync, up to 4K).
위 요율로 계산한 비용 사례 세 가지입니다.
- Speak 2.0, 720p로 만드는 15초 프레젠터 클립: 5초 블록 세 개, 블록당 약 14이므로 약 42크레딧입니다.
- 이미 집행 중인 30초 광고의 목소리를 Kling Lipsync로 바꾸는 경우: 블록 여섯 개, 블록당 약 2이므로 약 12크레딧입니다. 검증된 영상으로 새 후킹을 테스트하는 가장 저렴한 방법입니다.
- 같은 15초를 4K의 Sync Lipsync 3로 만드는 경우: 2초마다 약 18크레딧이므로 약 135크레딧입니다.
Speak를 쓸 수 있는 가장 저렴한 플랜인 Plus는 월 59달러에 월 1,200크레딧을 제공합니다. 클립 한 개에 약 42크레딧이 들면, 다른 곳에 크레딧을 쓰지 않을 때 Speak 2.0로 프레젠터 클립 약 28개를 만들 수 있습니다.
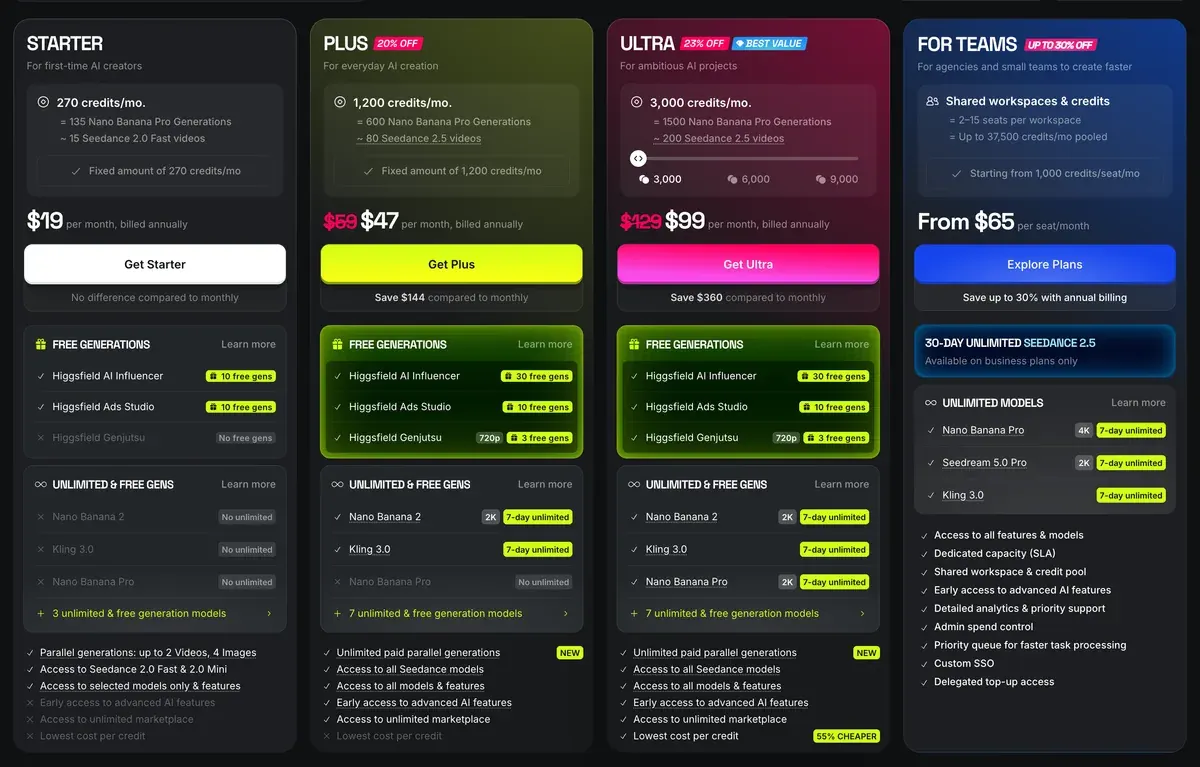
비용에 영향을 주는 사용자 리뷰가 두 가지 있습니다. 공개 출처 52건 중 여덟 건은 생성이 느리거나 실패해도 크레딧이 차감된다고 말합니다(Reddit, YouTube). 여섯 건은 크레딧이 결제 주기가 끝나면 소멸한다고 말합니다(Trustpilot, YouTube). 전체 플랜과 크레딧은 Higgsfield 가격에서 확인할 수 있습니다.
립싱크가 잘 맞는 스크립트 작성법
립싱크 스크립트는 눈이 아니라 귀를 위해 쓰므로 길이를 초 단위로 잡습니다. 미국 영어 대화는 분당 약 150단어 속도로, VirtualSpeech가 National Center for Voice and Speech의 수치로 소개한 값입니다. 초당 두 단어 반에 해당합니다.
| 클립 길이 | 최대 단어 수 | 적합한 용도 |
|---|---|---|
| 5 s | 12 | 후킹 한 줄 |
| 8 s | 20 | 후킹과 이유 한 가지 |
| 15 s | 37 | 후킹, 제품, CTA |
| 30 s | 75 | 짧은 광고 한 편(클립 두 개로 나눠 편집 권장) |
옆으로 스크롤하면 3개 열을 모두 볼 수 있습니다.
단어 수는 한도보다 몇 단어 적게 잡습니다. 쉼과 대괄호 큐에도 시간이 들고, 입이 어긋나는 곳은 대개 서두른 문장입니다.
Higgsfield에서 차이를 만드는 규칙은 다섯 가지입니다.
- 한 줄에 한 가지 생각만 담습니다. 문장마다 숨을 쉬므로 그 사이에 얼굴이 초기화됩니다.
- 말하는 대로 씁니다. Higgsfield 블로그는 “당사의 최신 제품 업데이트를 발표하게 되어 기쁩니다”와 “오늘은 한동안 준비해 온 것을 보여 드리려고 합니다”를 대비시킵니다.
- 톤이 바뀌는 곳에는 [warm], [calm], [direct]처럼 대괄호로 표시합니다. Higgsfield는 연기 기반 모델이 이를 “얼굴 애니메이션 파라미터를 바꾸는 데 활용한다”고 설명합니다.
- 숫자는 읽는 대로 풀어 쓰고(“이십 퍼센트”), 브랜드명은 소리 나는 대로 적습니다. 음성은 기호를 추측해서 읽습니다.
- 화자는 한 명으로 제한합니다. Higgsfield는 겹치는 대화를 한계로 꼽으므로, 화자마다 클립을 따로 만듭니다.
Step-by-step: how to improve AI lipsync quality
Write for spoken delivery, not for reading. Formal writing produces robotic delivery. Conversational language produces more natural facial animation because the model has more expressive cues to work from. Add emotion cues in brackets where the tone should shift: [excited], [calm], [direct].
Generate expressive audio first. Voice is the input that drives facial animation. Monotone delivery reduces the range of facial motion the model generates. A flat audio track produces a flat face regardless of which model you use.
욕실 선반에 세워 둔 휴대폰으로 찍은 듯한 15초 프레젠터 스크립트(발화 28단어):
[warm] Morning routine, one step.
[direct] Two drops of this serum, pat it in, done.
[light] No layering three bottles.
[calm] It's in the link below, if your shelf is full too.
프레젠터는 제품을 보여 주며 브랜드의 주장을 읽을 뿐, 몇 달째 써 왔다고는 말하지 않습니다. AI 얼굴이 그렇게 말하면 가짜 후기이기 때문입니다(AI UGC와 법). 광고 형식별 스크립트 구성은 UGC 스크립트 템플릿에서 볼 수 있습니다.
입 모양이 어긋날 때: 해결 방법
Higgsfield 블로그는 립싱크 정확도를 “2026년 현재 대체로 해결된 문제”라고 부릅니다. 시청자 눈에 띄는 것은 입이 아닌 나머지입니다. 굳은 얼굴, 한곳만 응시하는 눈, 반복되는 끄덕임, 클립마다 달라지는 얼굴입니다.
How to make an AI Talking Video Feel Real?
A believable LipSync video coordinates six elements simultaneously: lip movement aligned to speech phonemes; facial expressions that shift with emotional content; eye movement; subtle head motion that follows speech rhythm; gestures that match meaning; voice delivery with pacing, pauses, and tonal variation.
Frozen facial expressions. The cause is usually a source image with a neutral, flat expression. Use an image where the subject has a light, natural expression, not a passport-photo neutral face. Adding emotion cues to the script also helps: words like [excited], [thoughtful], or [warm] in brackets give performance-based models a signal to animate from.
| 확인되는 상태 | 이유 | 해결책 |
|---|---|---|
| 입만 움직임 | 무표정한 원본 사진 | 가벼운 표정의 인물 사진, 대괄호 큐 |
| 목소리는 들뜬데 얼굴은 무표정 | 음성과 얼굴을 따로 생성 | 음성의 에너지를 얼굴에 맞추거나 네이티브 오디오 모델 사용 |
| 시선 고정, 일정한 깜빡임 | 모델의 눈 움직임이 적음 | 20초 미만 클립 |
| 8~10초마다 반복되는 같은 끄덕임 | 긴 클립에 비해 부족한 모션 라이브러리 | 30초 미만 클립을 이어 붙이기 |
| 클립마다 바뀌는 얼굴 | 인물 고정 기능 없음 | Soul ID를 한 번 학습시켜 재사용 |
| 고개를 돌리면 입이 어긋남 | 측면 각도 또는 가려진 얼굴 | 정면 원본, 안경이나 입을 가리는 머리카락 없음 |
| 엉뚱한 억양 | 스크립트에 기본 음성 사용 | 대상 언어의 음성을 선택. Qwen Audio 3.0 TTS는 방언을 쉬운 말로 지정할 수 있음 |
| 두 사람이 동시에 말함 | 겹치는 대화 | 클립당 화자 한 명, 편집에서 이어 붙이기 |
옆으로 스크롤하면 3개 열을 모두 볼 수 있습니다.
앞의 다섯 행의 해결책은 Higgsfield의 립싱크 블로그 글에서 가져왔습니다. 측면 각도와 다중 화자 행은 같은 글의 한계 항목에서, 억양 행은 보이스오버 페이지에서 가져왔습니다.
How do you fix the most common problems?
Repetitive gestures. Limited motion libraries produce the same head nod or shoulder movement every 8-10 seconds. The fix is clip length: keep individual generations under 30 seconds and cut between them.
Character drift. The same person looking different across multiple clips is a persistent identity problem, not a LipSync problem. The fix is to use a trained identity layer rather than re-uploading the same photo each time.
결과가 거의 맞았다면 입력을 하나만 바꿔 다시 돌립니다. 여러 개를 한꺼번에 바꾸면 무엇이 효과였는지 알 수 없습니다.
광고 속 말하는 영상
립싱크를 활용하는 광고 형식은 세 가지이고, 형식마다 쓰는 Higgsfield 기능이 다릅니다.
첫째는 말하는 UGC입니다. 크리에이터가 제품을 들고 휴대폰 카메라에 대고 이야기하는 형식입니다. Soul에서 얼굴을 한 번 만들어 Soul ID로 고정한 뒤, Lipsync Studio나 Seedance로 말하게 합니다. 프롬프트가 포함된 전체 방법은 Higgsfield로 만드는 사실적인 AI UGC 캐릭터에서 다룹니다. 반복 등장하는 가상 크리에이터는 AI 인플루언서 가이드에서 다룹니다.
둘째는 제품 설명 영상입니다. 프레젠터가 제품 기능을 차례로 보여 줍니다. Higgsfield의 토킹 아바타 페이지에 따르면 Marketing Studio는 제품 광고용으로 “100개 이상의 준비된 아바타를 추가”해 캐스팅 수고를 덜어 줍니다(Marketing Studio 가이드). Cinema Studio는 “얼굴, 제품, 스타일 레퍼런스를 이미지, 영상, 오디오로 넣어 최대 30초의 시네마틱 토킹 아바타 장면”을 만듭니다.
셋째는 이미 성과가 나는 광고의 번역 버전입니다. Audio의 Translate는 클립의 목소리를 18개 언어로 다시 녹음합니다. 음성 클로닝 페이지에 따르면 Supercomputer의 현지화 툴은 화자의 목소리를 유지한 채 음성을 “영어, 스페인어, 프랑스어로” 번역합니다. 이후 Kling Lipsync로 입 모양을 다시 맞추며, 비용은 스튜디오에서 가장 낮은 요율입니다.
공개 출처 52건 중 다섯 건은 Soul ID, Elements, 레퍼런스 시트가 샷이 바뀌어도 캐릭터를 똑같이 유지해 준다고 평가합니다(YouTube, Reddit). 이런 일관성 덕분에 프레젠터 한 명이 캠페인 전체를 맡을 수 있습니다.
모든 형식에 적용되는 규칙이 두 가지 있습니다. 첫째는 실존 인물의 얼굴이나 음성에 대한 동의입니다. Higgsfield 이용약관 5.3조는 사용자가 “얼굴이나 목소리가 포함된 모든 개인으로부터 관련 법령상 필요한 모든 동의, 면책, 허락”을 받았음을 보증하도록 규정합니다.
둘째는 프레젠터에 대한 정직성입니다. 5.2조 (xi)호는 “사람이 만들지 않은 출력물을 사람이 만든 것처럼 제시”하는 행위를 금지합니다. 플랫폼별 표시 규정은 TikTok AI 라벨과 Meta AI 공개 규정에서 볼 수 있습니다.
음성이 아니라 얼굴을 바꾸는 것은 다른 툴로, Higgsfield 페이스 스왑과 Recast에서 다룹니다. Higgsfield 관련 페이지는 모두 Higgsfield 허브에, 플랜과 약관은 Higgsfield 툴 소개에 있습니다.
Higgsfield 립싱크 자주 묻는 질문
Higgsfield에서 내 영상에 립싱크를 할 수 있나요?
가능합니다. Lipsync Studio의 영상 모델 두 가지는 업로드한 영상의 입 모양을 다시 맞춥니다. Kling Lipsync는 720p 기준 5초당 약 2크레딧이고, Sync Lipsync 3는 최대 4K까지 지원합니다. Higgsfield 블로그는 “얼굴이 선명하게 보이고 머리 위치가 일정한 안정적인 영상”을 요구합니다.
내 목소리를 쓸 수 있나요?
가능합니다. Audio에서 Create custom voice를 선택하고 짧은 MP3 또는 WAV 샘플을 녹음하거나 업로드합니다. Higgsfield의 규칙은 “본인 목소리 또는 사용 허락을 받은 목소리만 복제”하라는 것입니다. 복제 페이지에서는 복제본을 만들기 전에 동의 단계를 거칩니다.
Higgsfield 말하는 영상은 최대 몇 초까지 만들 수 있나요?
립싱크 도움말은 Lipsync Studio의 최대 길이를 정해 두지 않았고, 장편 말하는 영상용으로는 Infinite Talk를 안내합니다. Cinema Studio의 토킹 장면은 최대 30초입니다. Higgsfield는 생성 한 번당 30초 이내로 만들고 클립 사이를 편집으로 이으라고 권합니다.
Lipsync Studio와 Seedance 중 무엇을 써야 하나요?
스크립트가 있는 프레젠터 광고처럼 정확한 대사와 음성을 통제해야 하면 Lipsync Studio를 씁니다. 한 번에 끝나는 촬영이 더 중요하면 음성과 화면을 함께 만드는 Seedance가 낫습니다. Higgsfield의 Seedance 전체 설명은 Seedance 가이드에 있습니다.
출처
- Higgsfield 도움말 센터: How do I use lipsync, voiceover, and aspect ratios?, 입력별 Lipsync Studio 모델 여덟 개, 장면 템플릿, Audio의 세 가지 모드, 허락받은 음성 클로닝, 18개 언어 번역, 화면 비율 여섯 가지, Reframe, 2026년 8월 1일 자. 확인
- Higgsfield 블로그: How to make realistic AI talking and LipSync videos in 2026, 자연스러운 말하는 영상의 여섯 요소, 흔한 문제 다섯 가지와 해결책, 여섯 단계 워크플로, 한계; 2026년 7월 7일. 확인
- Higgsfield: AI Talking Avatar, 스크립트 또는 오디오와 인물 사진, 최대 30초의 Cinema Studio 토킹 장면, 18개 언어 더빙, 9:16, 1:1, 16:9 비율로 Reframe 및 4K 업스케일. 확인
- Higgsfield: AI Voice Over, 음성 엔진, 1회 최대 10,000자, Eleven v4에서 최대 10명 화자 대화, 13개 언어를 지원하는 Qwen Audio 3.0 TTS, MP3, WAV, OGG 내보내기. 확인
- Higgsfield: AI Voice Cloning, 짧은 샘플, 동의 단계, 영어·스페인어·프랑스어를 화자 본인 목소리로 옮기는 Supercomputer의 현지화 툴. 확인
- Higgsfield: Higgsfield pricing, 브라우저에서 확인한 비교표: 2026년 10월 9일 기준 Lipsync Studio 크레딧 요율과 플랜별 Higgsfield Speak 행, 2026년 10월 19일 기준 플랜 가격과 크레딧. 확인
- Higgsfield: Higgsfield 이용약관(2026년 7월 26일), 업로드하는 모든 얼굴과 음성에 대한 동의를 다룬 5.3조, 출력물을 사람이 만든 것으로 제시하는 행위를 다룬 5.2조(xi). 확인
- VirtualSpeech: Average speaking rate and words per minute, 미국 영어 대화는 분당 약 150단어이며 National Center for Voice and Speech 수치로 소개; 2026년 8월 20일. 확인
- Trustpilot, Reddit, YouTube: Higgsfield 사용자 후기, 공개 출처 52건 종합, 2026년 9월 28일 확인. 확인
이 페이지 변경 내역
- Higgsfield 가격이 다시 올랐습니다. Starter는 월 결제와 연간 결제 모두 월 19달러에 270 크레딧, Plus는 월 59달러 또는 연간 결제 시 47달러에 1,200 크레딧입니다(기존 Starter 15달러에 200 크레딧, Plus 49달러 또는 연간 결제 시 39달러에 1,000 크레딧). Ultra는 월 129달러, 연간 결제 시 99달러로 그대로입니다.
- Higgsfield 가격이 다시 내렸습니다. Starter는 월 결제와 연간 결제 모두 월 15달러에 200 크레딧, Plus는 월 49달러 또는 연간 결제 시 39달러에 1,000 크레딧입니다(기존 Starter 19달러에 270 크레딧, Plus 59달러 또는 연간 결제 시 47달러에 1,200 크레딧). Ultra는 월 129달러, 연간 결제 시 99달러로 그대로입니다.
- Higgsfield 가격이 또다시 올랐습니다. Starter는 월 결제와 연간 결제 모두 월 19달러에 270 크레딧, Plus는 월 59달러 또는 연간 결제 시 47달러에 1,200 크레딧입니다(기존 Starter 15달러에 200 크레딧, Plus 49달러 또는 연간 결제 시 39달러에 1,000 크레딧). Ultra는 월 129달러, 연간 결제 시 99달러로 그대로입니다.
- Higgsfield 가격이 원래대로 돌아왔습니다. Starter는 월 15달러에 200 크레딧, Plus는 월 49달러 또는 연간 결제 시 39달러에 1,000 크레딧이며, Ultra(월 129달러, 연간 결제 시 99달러) 카드도 다시 생겼습니다(기존 Starter 19달러에 270 크레딧, Plus 59달러 또는 연간 결제 시 47달러에 1,200 크레딧).

관련 페이지
-
 가이드 광고용 UGC 스크립트 템플릿
그대로 복사해 쓸 수 있는 UGC 광고 대본 템플릿과 유형별 후킹 20가지, 15초·30초·45초 길이별 예시. 크리에이터와 AI 배우 모두에 쓸 수 있습니다. 2026년 10월 15일 확인.
-
 추천 목록 광고용 AI 보이스오버
ElevenLabs 무료 플랜은 광고에 쓸 수 없고, 광고용은 $6 Starter부터입니다. 음성·영상 툴 9종의 광고 사용 가능 플랜, 2026년 10월 2일 확인.
-
 가이드 Higgsfield Seedance 2.0
Higgsfield에서 Seedance 2.0의 비용, 무제한이 적용되는 때, 클립 제한, Dreamina 등 다른 곳과의 가격 비교. 2026년 10월 16일 확인.
-
 가이드 Higgsfield Marketing Studio
Higgsfield Marketing Studio는 상품 링크 하나로 UGC 영상, 제품 컷, 이미지 광고를 만듭니다. 사용 단계, 클립당 크레딧, 광고 규정을 2026년 10월 18일 기준으로 정리했습니다.


