RunpodでWan 2.2とLTX-2を動かす
Wan 2.2とLTX-2は、公開されているオープンな動画生成モデルです。ファイルをダウンロードし、手持ちまたはレンタルのグラフィックカード上のComfyUIで自分で動かします。Runpodなら、そのカードを秒単位で借りられます。
Wan 2.2の小型5BモデルとLTX-2は、24または32 GBのカード(RTX 4090やRTX 5090)に収まります。720pで動かす場合、Wanの14Bモデルは、軽量なfp8形式で48 GBが目安です。フルサイズなら80 GB以上が必要で、96 GBのRTX PRO 6000などが該当します。
公開されている生成時間から試算すると、短いクリップ1本のGPU代は1セント未満から約1ドルまでです。1ドルは、Alibabaのリファレンススクリプトの場合です。
| モデル | できること | グラフィックメモリ(出典) | 適合するRunpodのカード | 広告での利用ライセンス |
|---|---|---|---|---|
| Wan 2.2 TI2V-5B | テキスト/画像から動画生成、720P・24 FPS | 24 GB(Wanチーム)、オフロードありで約8 GB(ComfyUI) | RTX 4090、24 GB | Apache 2.0 |
| Wan 2.2 T2V・I2V A14B | テキストから動画生成、画像から動画生成、480Pと720P | GPU1枚で80 GB(Wanチーム)、480pのfp8で24 GB(Runpod) | RTX PRO 6000、96 GB(720p向け) | Apache 2.0 |
| LTX-2とLTX-2.3 | 音声と同期した動画生成 | 720pの4秒クリップが32 GBに収まる(NVIDIA) | RTX 5090、32 GB | 年間売上$10,000,000未満は無料 |
5列すべてを見るには横にスクロール
Wan 2.2とLTX-2とは?
Wan 2.2は、Alibabaが公開しているオープンな動画生成モデルのシリーズです。新バージョンのWan 3.0は、オープンではなくAlibaba CloudのAPI経由で秒単位の従量課金で提供されています。Wan 2.2のGitHubページには、テキストや画像から720Pの動画を生成する5Bモデルが掲載されています(Wan2.2 on GitHub)。14Bモデルは、テキストから動画生成、画像から動画生成、音声から動画生成、キャラクターアニメーションに対応します。
「B」は10億単位のパラメータ数のことで、モデルの大きさの目安です。モデルが大きいほど、VRAMと呼ばれるグラフィックメモリが多く必要になり、カードを借りるときはこの数字が決め手になります。
LTX-2はLightricksのオープンモデルで、2.3版は映像と音声を一度の生成で作れます。LTX-2.3のモデルカードには「1つのモデルで映像と音声を同期して生成できるよう設計されている」とあり、ComfyUIでは標準搭載のLTXVideoノードを使うよう案内されています。

どちらもComfyUIで動きます。ComfyUIは無料のアプリで、作業の各ステップをキャンバス上のボックスにして、線でつないでいきます。Wan 2.2は2025年7月28日からComfyUIで使えます。
Wan 2.2とLTX-2のクリップは広告に使える?
どちらも使えます。ただしLTX-2には売上に関する条件と、禁止用途の一覧があります。Runpodが貸すのはハードウェアだけなので、クリップの扱いはモデル自体のライセンスで決まります。
Wan 2.2のライセンスはApache 2.0で、商用利用を認める寛容なライセンスです。Wanチームのリポジトリには「The models in this repository are licensed under the Apache 2.0 License.」と記載されています。
Licence
Licence The models in this repository are licensed under the Apache 2.0 License.
Outputs We claim no rights over the your generated contents, granting you the freedom to use them.
5B model The TI2V-5B model can also run on consumer-grade graphics cards like 4090.
LTX-2は、2026年1月5日付のLTX-2 Community License Agreementのもとで提供されています。「for any purpose」(あらゆる目的)での利用が認められますが、同意なしに作るディープフェイクなど、Attachment Aに挙がる禁止用途は対象外です。この日以降に公開されたLTX-2の全バージョンが対象で、LTX-2.3も含まれます。
広告用途で確認すべき条件は、売上の基準です。年間売上が10,000,000ドル以上の事業者は、「are required to obtain a paid commercial use license」(有料の商用利用ライセンスの取得が必要)とされています(LTX-2のライセンス)。
Section 2.1, grant of rights (dated 5 January 2026)
Entities with annual revenues of at least $10,000,000 (the “Commercial Entities”) are required to obtain a paid commercial use license in order to use LTX-2 and Derivatives of LTX-2.
基準は子会社を含むグループ全体で数えます。基準を下回る場合、広告への利用にロイヤリティはかからず、Lightricksも「claims no rights in the Output you generate」(生成した出力に対する権利を主張しない)としています。
MiniMax H3のオープンライセンスは、米国、EU、英国、韓国を対象外としています(MiniMax H3のライセンス)。これらの地域向けの広告では、候補から外れます。
必要なVRAMは?適合するRunpodのGPUは
まずモデルと解像度をカードのメモリに合わせ、そのうえで価格を比べます。モデルが収まらない場合、ComfyUIはその一部をポッドの通常のメモリに移します。動作はしますが、速度は大きく落ちます。
Wan2.2 in ComfyUI
Templates Workflows in this guide can be found in the Workflow Templates.
5B memory The Wan2.2 5B version should fit well on 8GB vram with the ComfyUI native offloading.
Licence The Wan2.2 series models are based on the Apache 2.0 open source license and support commercial use.
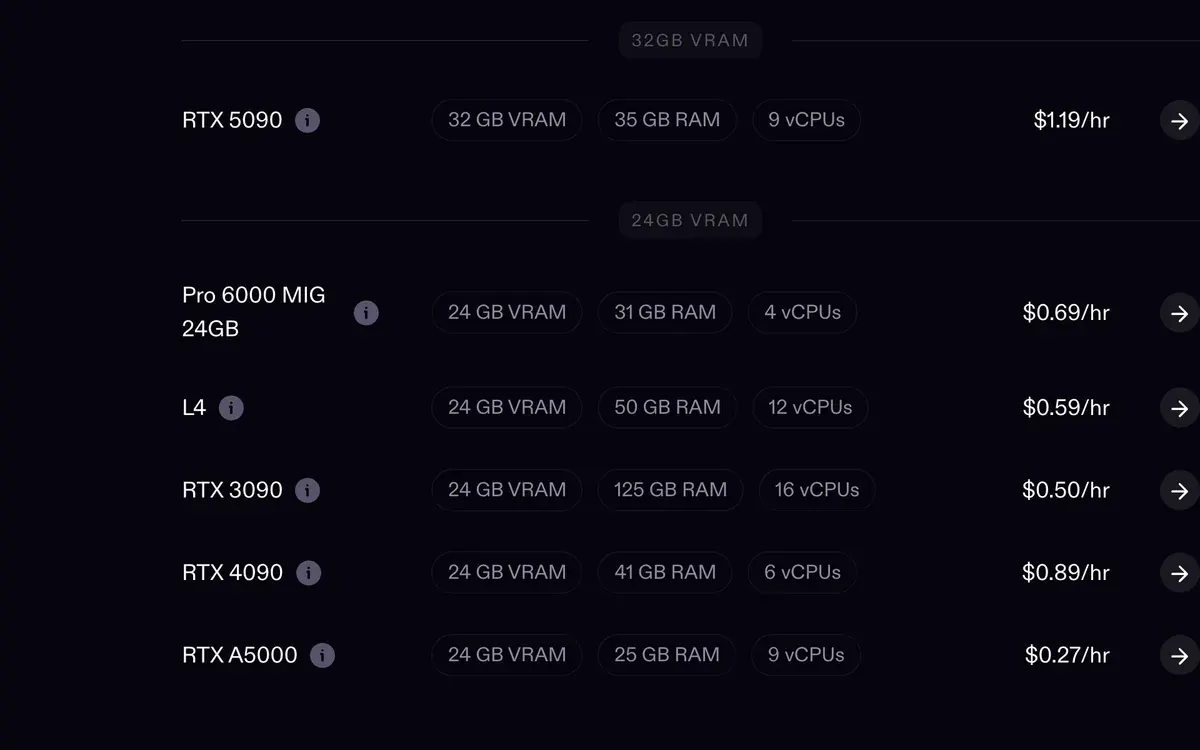
2026年10月22日更新のRunpod公式Wan 2.2ガイドに、用途別のメモリの目安が載っています(RunpodのWan 2.2ガイド)。表の料金はRunpodの料金ページによるものです。
| 用途 | メモリ | カード | Secure Cloud(1時間あたり) | Community Cloud(1時間あたり) |
|---|---|---|---|---|
| TI2V-5B(1280×704) | 24 GB | RTX 4090 | $0.89 | $0.34 |
| fp8の14B(480pまたは640×640) | 24 GB | RTX 4090 | $0.89 | $0.34 |
| fp8の14B(長尺クリップ、またはLoRA使用時) | 32 GB | RTX 5090 | $1.19 | $0.69 |
| fp8の14B(720p) | 48 GB | L40S | $1.09 | $0.79 |
| オフロードなしの14B(720p) | 80 GB以上 | RTX PRO 6000、96 GB | $2.49 | $1.69 |
5列すべてを見るには横にスクロール
表のfp8は軽量なファイル形式です。モデルの数値を低い精度で保存するため、メモリは約半分で済みます。
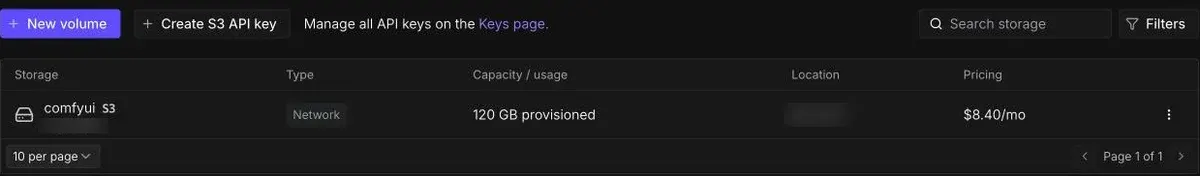
自社のRunpodアカウントでも、画像モデルで同じ壁に当たります。6〜17 GBの画像モデルなら、5090の32 GBに余裕で収まります。一方、約40 GBの動画モデルは収まりきらず、オフロードが発生します。
このため、96 GBのカードのほうが、オフロードが必要な安いカードよりクリップ1本あたりのコストが低くなることがあります。
Runpodでクリップ1本あたりのコストは?
LTX-2の短いクリップなら1セント未満、Alibabaのリファレンススクリプトで720pのWan 14Bクリップを作ると約1ドルです。下の数字はいずれも、公開されている生成時間にRunpodの時間単価を掛けた計算値です。
| クリップ | 公表されている生成時間(出典) | カード | Secure Cloud | Community Cloud |
|---|---|---|---|---|
| LTX-2、4秒、720p、24 fps | 約25秒(NVIDIA) | RTX 5090 | $0.008 | $0.005 |
| LTX-2、8秒、720p | 約3分(NVIDIA) | RTX 5090 | $0.06 | $0.03 |
| Wan 2.2 14B、5秒、640×640、Lightning LoRA | 約71秒(Runpod、RTX 4090D使用) | RTX 4090 | $0.018 | $0.007 |
| Wan 2.2 14B、5秒、640×640、20ステップ | 約513秒(Runpod、RTX 4090D使用) | RTX 4090 | $0.13 | $0.05 |
| Wan 2.2 TI2V-5B、5秒、720P | 9分未満(Wanチーム、コンシューマー向けGPU) | RTX 4090 | $0.13 | $0.05 |
| Wan 2.2 14B、720p、40ステップ、クリップの長さは記載なし | 17.4分(Alibabaのベンチマーク) | H100 SXM | $1.16 | $0.78 |
5列すべてを見るには横にスクロール
71秒と513秒は、Runpodがウォーム実行(モデルを読み込み済みの状態)で、RTX 4090Dを使って計測した値です。このカードは4090の輸出向けバージョンで、コア数が少なくなっています。ここでは4090の料金で計算しています。
NVIDIAが示す8秒のクリップで3分という数字には、クリップが32 GBに収まらなくなったときの速度低下が含まれます。Wanチームの9分は「未満」の値なので、この行は上限です。最初のクリップの前にモデルを読み込む時間も課金対象ですが、これらの行には含まれていません。
Lightning LoRAは、Wanのサンプリングを4ステップに減らす小さな追加ファイルです。これを使うと、同じクリップの生成時間が約513秒から約71秒になります。
比較のために、自社アカウントでの実測値を挙げます。Secure CloudのRTX 4090でFLUX 3 Kleinの高速モードの画像を作ると、約28.5秒、1枚あたり0.007ドルです。その表はRunpodでComfyUIを動かすガイドにあります。
ComfyUIでWanを動かすならRTX 5090とRTX 4090のどちら?
5Bモデルと、480pの14BにはRTX 4090を、24 GBでは足りない場合はRTX 5090を選びます。5090はSecure Cloudで1時間あたり約3割高いため、追加の8 GBでComfyUIのオフロードがなくなる場合にだけ元が取れます。Community Cloudでは約2倍の料金です(0.34ドルに対して0.69ドル)。
Runpodのガイドでは、5090の32 GBは、余裕が要る14Bの用途(長めのクリップや、LoRAを上乗せして読み込む場合)向けとされています。LTX-2なら、NVIDIAが示す4秒・720pのクリップがメモリに収まるため、借りるべきカードは5090です。
32 GBを超える場合は、どちらも向きません。48 GBのL40Sは、Secure Cloudの5090より1時間あたりの料金が安くなります。フルサイズの14Bを720pで動かすなら、モデル全体が収まる96 GBのRTX PRO 6000です。
HearmemanAIのテンプレートでWan 2.2をセットアップする方法
この方法では、ポッドの初回起動時にモデルとワークフローが自動でダウンロードされます。使うのは、HearmemanAIがRunpodで公開しているコミュニティテンプレートです。ネットワークボリューム(ポッドを削除しても残るRunpodの永続ディスク)をアタッチしておけば、ダウンロードは1回で済みます。
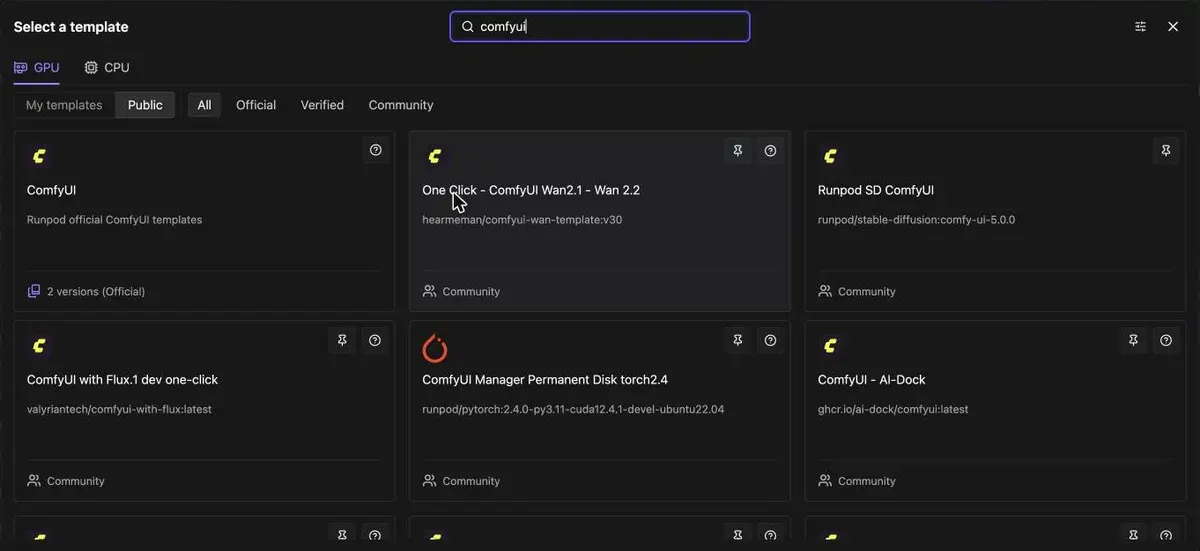
- テンプレートを探します。Runpodコンソールで「Pods」から「Deploy」を開き、「comfyui」で検索します。公式テンプレートと並ぶコミュニティテンプレートから、「One Click - ComfyUI Wan2.1 - Wan 2.2」を選びます。
-
Wan 2.2のダウンロードをオンにします。デプロイ前に「Edit Template」を開いてください。ダウンロード用のフラグはすべて初期値がfalseなので、
download_wan22をtrueにします。Wan 2.1のワークフローも使う場合はdownload_wan21、キャラクターアニメーションにはdownload_wan_animateもtrueにします。 -
CUDA 13に対応するカードを選びます。Runpodのガイドには、このテンプレートは「is built for CUDA 13.0 and above」(上記バージョン以上向けに作られている)とあります。CUDAはGPUを動かすドライバ層のことです。カード選択画面では、CUDAのバージョンで絞り込みます。自社アカウントでは、テンプレートのCUDA指定が「no instances available」(空きインスタンスなし)の原因の一つでした。
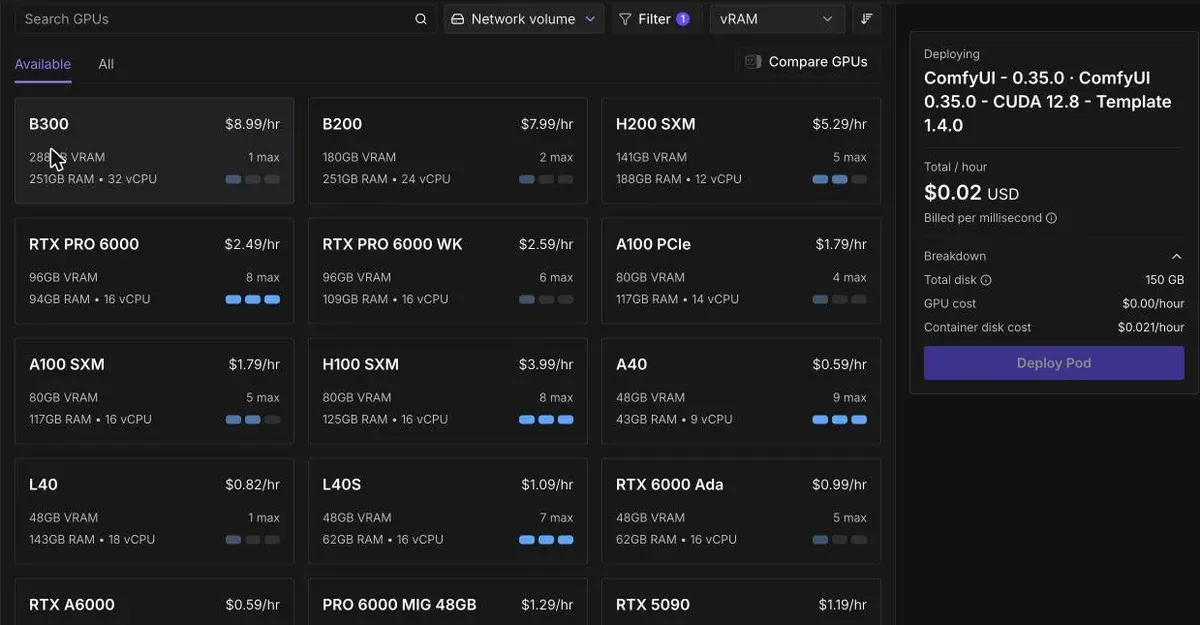
-
デプロイして、初回起動を待ちます。ComfyUIが開く前に、ポッドがモデルをダウンロードします。完了したら「Connect」をクリックし、ComfyUIのリンクを開きます。
-
Wan 2.2のワークフローを読み込んで実行します。ワークフローはテンプレートに用意済みなので、プロンプトまたは画像、サイズ、クリップの長さを設定し、キューに入れるだけです。

- クリップを保存したら、ポッドを停止します。ポッドは、使っていない間も動いている限り1秒ごとに課金されます。
公式ComfyUIテンプレートを使う方法
公式テンプレートは、まっさらなComfyUIが立ち上がり、Wanのファイルは自分で追加する形です。初回は時間がかかり、ファイルの管理もすべて自分で行います。
-
同じ選択画面から公式のComfyUIテンプレートをデプロイします。RTX 5090ならBlackwell Editionも選べます。コンテナディスクは50 GBに設定します。自社アカウントでは、この設定ならデプロイできましたが、初期値の150 GBではカードが見つからないことがよくありました。
-
テンプレートライブラリを開きます。ComfyUIのTemplate Libraryで「Wan2.2 5B」を検索します。何も表示されない場合は、ComfyUIが古いバージョンだとComfyUIのドキュメントにあります。同じワークフローは、comfy.orgの公開ギャラリーにもあり、モデル名で検索できます。
-
各ファイルを所定のフォルダに入れます。5Bモデルの場合、ComfyUIのドキュメントでは、
wan2.2_ti2v_5B_fp16.safetensorsはmodels/diffusion_models/に、wan2.2_vae.safetensorsはmodels/vae/に、umt5_xxl_fp8_e4m3fn_scaled.safetensorsはmodels/text_encoders/に置くとされています(ComfyUIのWan 2.2ドキュメント)。 -
サイズと長さは
Wan22ImageToVideoLatentノードで設定します。14Bモデルの場合はEmptyHunyuanLatentVideoノードです。 -
キューを実行してクリップを保存したら、ポッドを停止します。
LTX-2も同じ公式テンプレートで動きます。モデルカードの案内どおり、ComfyUI ManagerからLTXVideoノードをインストールします。そのうえで、Template Libraryの「Video」から、テキストから動画生成または画像から動画生成のワークフローを読み込みます。
LTX-2 in ComfyUI
Go to Template Library > Video > choose any LTX-2 workflow

Google Colab上のComfyUIでWan 2.2は動かせる?
無料枠では安定して動かせません。GoogleのFAQでは、無料ランタイムでのWeb UI経由の作業は禁止とされ、そうしたランタイムは停止されることが多いと説明されています(Colab FAQ)。ComfyUIはWeb UIです。レンタルしたポッドにはそのような規則はなく、GPUはポッドが動いている間だけ課金されます。
Runpod関連のほかのページはRunpodまとめに、これらのカードをGPUクラウド間で比べた表はクラウドGPU料金表にあります。
RunpodでのWan 2.2・LTX-2に関するよくある質問
ComfyUIでWan 2.2を動かすのに必要なGPUは?
RTX 4090などの24 GBのカードなら、5Bモデルを720Pで、14Bモデルをfp8の480pで動かせます。720pの14Bモデルでは、fp8で48 GB、カード1枚でフルサイズなら80 GB以上が必要です。
Wan 2.2の動画は有料広告に使えますか?
はい、使えます。Wan 2.2のライセンスはApache 2.0で、商用利用が認められています。Runpodが貸すのはカードだけなので、クリップに適用されるのはモデルのライセンスです。
LTX-2は商用利用が無料ですか?
はい、グループ全体の年間売上が10,000,000ドル未満で、禁止用途に当たらない範囲であれば無料です。それを超える場合、Lightricksのライセンスでは有料の商用ライセンスが必要です。
レンタルGPUでWan 2.2のクリップ生成にかかる時間は?
Runpodのガイドによると、RTX 4090DでLightning LoRAを使った5秒・640×640のクリップは約71秒です。初期設定の20ステップでは約513秒かかります。
テンプレートでWan 2.1も動かせますか?
はい、動かせます。Wan 2.1は旧世代のモデルで、HearmemanAIのテンプレートではdownload_wan21をtrueにするとそのワークフローがダウンロードされます。最初は新しいモデルの2.2から始めます。
出典
- GitHub:Wan2.2、Apache 2.0。TI2V-5Bは24 GB以上のGPUで720P・24 FPSの動画を生成し、コンシューマー向けGPU1枚で5秒・720Pの動画を9分未満で生成。A14BとS2Vは、GPU1枚あたり80 GB以上が必要。ComfyUIでは2025年7月28日から対応。確認日:
- ComfyUI docs:Wan2.2 Video Generation ComfyUI Official Native Workflow Example、5Bバージョンは、ComfyUIネイティブのオフロードを使えば8 GBのVRAMに十分収まる。モデルファイルとフォルダ。Template Libraryを検索して見つかるテンプレート。確認日:
- Runpod:Wan 2.2 in ComfyUI on Runpod(2026年10月22日更新)、HearmemanAIのワンクリックテンプレート。ダウンロードフラグはdownload_wan22、download_wan21、download_wan_animateで、初期値はすべてfalse。CUDA 13.0以上。GPU別のVRAMの目安。RTX 4090Dで5秒・640x640のクリップを、Lightning LoRAありで約71秒、または20ステップで513秒。いずれもウォーム実行。Alibabaの720pベンチマークはH1001枚で17.4分、リファレンススクリプトは40ステップで、クリップの長さは記載なし。RunpodはこれをComfyUIの所要時間とは別扱いにしている。確認日:
- Lightricks on Hugging Face:LTX-2.3、1つのモデルで映像と音声を同期して生成。ComfyUIに標準搭載のLTXVideoノード。蒸留版は8ステップ。確認日:
- Lightricks on GitHub:LTX-2 Community License Agreement(2026年1月5日)、LTX-2の全バージョンが対象(2026年1月5日以降に公開)。LTX-2.3のモデルカードがリンクするライセンス。年間売上1000万ドル以上の事業者は有料の商用利用ライセンスが必要。禁止用途はAttachment Aに列挙。Lightricksは出力に対する権利を主張しない。確認日:
- MiniMax on Hugging Face:MiniMax H3 Community License Agreement、適用地域(Applicable Territory)は、EU、英国、韓国、米国を除く全世界。確認日:
- NVIDIA:Quick start guide for LTX-2 in ComfyUI(2026年1月5日、スペイン語版)、32 GBのRTX 5090で、720p・24 fps・4秒のクリップをGPUメモリ内で約25秒で生成。8秒のクリップでは約3分かかる。確認日:
- Runpod:Runpod pricing(2026年10月8日更新)、1時間あたりの料金(Secure/Community):RTX 4090は0.89ドル/0.34ドル、RTX 5090は1.19ドル/0.69ドル、L40Sは1.09ドル/0.79ドル、RTX PRO 6000は2.49ドル/1.69ドル、H100 SXMは3.99ドル/2.69ドル。確認日:
- Google:Colab FAQ、無料ランタイムでは、ノートブックではなくWeb UI経由で作業することは禁止。コンテンツ生成用のWeb UIを動かすと、停止されることが多い。確認日:

関連ページ
-
 ガイド Wan on Higgsfield
HiggsfieldにはWanの動画モデルが6種あります。Wan 3.0の5秒クリップ(720p)は8.75クレジットで、Alibabaの価格に近い水準です。WanがKlingやSeedanceより優れている場面と、手順を解説します。
-
-
 ツール紹介 Runpod
広告用の画像・動画制作でのRunpod:Secure CloudかCommunity Cloudか、PodかServerlessか、モデルのライセンス、48件のユーザー情報源の報告をまとめています。確認日:2026年10月24日。
-
 代替ツール Runpodの代替サービス
Vast.ai、Modal、Lambda、TensorDock、Massed Compute、Paperspace、Comfy Cloudを、RTX 4090、5090、H100の料金でRunpodと比較しています(2026年10月24日時点)。


